Querri vs Databricks
Databricks es un lakehouse que tienes que construir. Querri es la respuesta que buscabas.
El mismo objetivo: respuestas confiables. Proyectos muy distintos.
Databricks es una de las plataformas de datos más capaces del mundo, pensada para equipos de ingeniería: un lakehouse, pipelines, un catálogo, tablas curadas, dos facturas y la gente para operarlo todo. Querri es la plataforma de datos que parte de las preguntas. Empieza por las preguntas que hace tu negocio y construye lo necesario para responderlas, en un solo producto, con una sola factura predecible. ¿Ya usas Databricks? Deja las tablas en el lakehouse y deja que Querri las consulte directamente.
Tiempo, costo y control
Respuestas este trimestre, una factura que puedes planificar y ningún equipo nuevo que contratar
Databricks es una plataforma sobre la que construyen los equipos de ingeniería. Querri es el camino completo desde tus sistemas hasta una respuesta. Esto es lo que esa diferencia significa para el negocio.
-
Respuestas en días, no en trimestres
Un proyecto de lakehouse tarda de semanas a meses antes de que el negocio obtenga una respuesta confiable. Con Querri, conectas un sistema o subes un archivo y preguntas el mismo día.
-
Una factura que puedes planificar, sin sorpresas
Databricks factura DBUs más las máquinas de tu proveedor de nube: dos facturas que cambian con el uso. Querri es una sola factura predecible: una asignación mensual de créditos ligada al trabajo que hace tu equipo, alertas antes de que la alcances y ningún cargo automático por excedentes.
-
Sin necesidad de un equipo de datos
Databricks necesita ingenieros para construir las tablas y un analista para mantener Genie preciso. En Querri, las personas que ya conocen el negocio deciden qué significan los números, en lenguaje sencillo.
-
Seguro, auditable y sin nada que reemplazar
SOC 2 Type II, HIPAA e ISO 27001:2022, y tus datos nunca entrenan un modelo. Cada número muestra su consulta, y si ya usas Databricks, Querri funciona encima de él, en vivo o sincronizado, sin mover nada.
Dónde encaja cada uno
Elige según el equipo y el plazo que tienes
Preferimos que elijas la herramienta correcta a que nos elijas por el motivo equivocado. Aquí está dónde encaja cada una.
Elige Databricks cuando
- Tienes ingenieros de datos que construirán y operarán pipelines de Spark, tablas Delta y Unity Catalog, y mantendrán Genie curado.
- Tus datos ocupan muchos terabytes o petabytes, o necesitas Spark para transformaciones pesadas.
- Entrenas y despliegas modelos de machine learning, o necesitas streaming en tiempo real con latencia inferior a un segundo.
- Quieres una sola plataforma para ingeniería de datos, ciencia de datos y aplicaciones de IA, gobernada en un solo catálogo.
- Alguien se hará cargo de la factura: políticas de cómputo, terminación automática, etiquetado, presupuestos y la factura de la nube.
Elige Querri cuando
- Quieres respuestas de negocio en días, no después de un proyecto de lakehouse, o ya usas Databricks y quieres que el negocio lo consulte directamente.
- Tus datos viven en sistemas de negocio (CRM, contabilidad, ERP, pagos, hojas de cálculo) y caben en una sola máquina rápida.
- Las personas que saben qué significan los números no son ingenieros, y no deberían tener que escribir vistas de métricas para decirlo.
- Quieres una sola factura predecible, no DBUs más una factura de nube que llegan por separado.
- Quieres dashboards, informes, un agente de IA, limpieza de datos y MCP para Claude y ChatGPT integrados, no ensamblados.
Función por función
La comparación detallada
Cada fila indica dónde es más fuerte cada uno. Donde Databricks gana, lo decimos. Los datos están vigentes a octubre de 2026 y enlazados en las fuentes.
Los precios de lista de Databricks varían según la nube, la región, el nivel y el contrato, y Databricks no publica una tarifa única; las cifras de DBU son estimaciones de terceros para AWS en EE. UU. Los datos de producto provienen de la documentación de Databricks al 15 de octubre de 2026.
Precios
El precio por consumo premia a un equipo que lo vigila
Pagar solo por lo que usas es una ventaja real cuando alguien lo gestiona. Databricks añade un segundo medidor: los DBUs en la factura de Databricks y las máquinas en tu factura de nube. Sin alguien que vigile ambos, el costo sigue cada clúster que se queda encendido y cada pregunta que responde un agente, y los registros llegan horas después.
Cómo factura Databricks
- Dos facturas. DBUs a Databricks, según el tipo de carga de trabajo, más las máquinas virtuales y el almacenamiento en tu cuenta de nube. Serverless integra las máquinas en una tarifa de DBU más alta.
- Las tarifas cambian según la carga de trabajo: aproximadamente $0.15 por DBU para trabajos hasta $0.70 para SQL serverless (cifras de terceros para EE. UU.). Ejecutar trabajos en cómputo all-purpose cuesta "significativamente" más.
- Los clústeres inactivos siguen facturando hasta la terminación automática, que va de 10 a 10,000 minutos, o nunca llega si se fija en 0.
- Genie incluye una asignación mensual gratuita para su uso de modelos; por encima de ella, Genie se factura en DBUs desde el 8 de julio de 2026, y el SQL warehouse que lo respalda se factura aparte.
- Los presupuestos alertan por correo. Los presupuestos de Genie no son "un tope absoluto de gasto", y las solicitudes en curso "no se interrumpen".
- Los registros de facturación llegan "normalmente en un plazo de 12 horas", así que un trabajo descontrolado aparece cuando el dinero ya se gastó.
Cuando el precio por consumo es la mejor opción
Si tienes un equipo de plataforma que ejecuta los trabajos en cómputo de trabajos, define políticas de cómputo y terminación automática, etiqueta todo desde el primer día y revisa las tablas de facturación del sistema, Databricks puede ser muy rentable a escala, y el tiempo de ingeniería que ahorra puede compensar la factura. Si ese es tu equipo, las guías de abajo son el punto de partida.
Lo que pasa cuando nadie vigila
¿Eliges Databricks? Mantén ambos medidores bajo control.
Si Databricks es la decisión correcta para ti, estos son los controles que mantienen la factura predecible. La mayoría vienen de la propia documentación de Databricks.
- Buenas prácticas de optimización de costos Cómputo de trabajos en lugar de all-purpose, tamaño adecuado y etiquetado desde el primer día. Databricks docs
- Define políticas de cómputo Limita los DBUs por hora y los clústeres que puede crear cada persona. Databricks docs
- Configura la terminación automática El cómputo inactivo factura hasta que se detiene. Mantén el tiempo de espera corto. Databricks docs
- Crea presupuestos Alertas por correo cuando el gasto mensual supera un umbral. Databricks docs
- Vigila las tablas de facturación del sistema Consulta el uso por carga de trabajo, usuario y etiqueta, con unas 12 horas de retraso. Databricks docs
- FinOps de Databricks en la práctica La guía de campo de Xebia, con ahorros reales en cómputo inactivo y sobredimensionado. Xebia
Cómo Querri mantiene la factura predecible
- Una sola factura, sin sorpresas. Un solo plan para toda la organización, con la IA, el almacenamiento y los visualizadores de dashboards ilimitados incluidos. Ver planes y precios.
- Un crédito sencillo. Un crédito es una unidad de trabajo de negocio, como responder una pregunta o sincronizar una fuente, así que el uso es fácil de entender y de planificar.
- Una sola factura. El almacenamiento, el cómputo y la IA están incluidos en el plan. No hay ninguna factura de nube detrás.
- Alertas de uso al 80% del plan, al superarlo y ante un pico, además de un límite mensual para cualquier persona.
- Ningún cargo automático por excedentes. Te avisamos cuando te acercas a tu límite, y tú decides qué pasa después.
- Visualizadores de dashboards ilimitados en todos los planes. Ver, subir archivos, exportar y la Biblioteca nunca cuestan créditos.
Costo total
Lo que hace falta para obtener la primera respuesta
Un lakehouse es donde empieza el trabajo. Antes de que un usuario de negocio obtenga una respuesta confiable de Genie, alguien construye las tablas, el catálogo y las vistas de métricas que la respaldan. Este es el camino típico de Databricks, junto a Querri.
El camino de Databricks es nuestra estimación a partir de datos de contratos de Vendr, un modelo de costos de la comunidad de Databricks y rangos salariales de las fuentes enlazadas, no una cotización. Un despliegue pequeño y cuidadoso cuesta menos; si ya tienes el equipo, la partida de personas es un costo que ya elegiste.
Arquitectura
Spark para los datos más grandes. DuckDB para los datos que realmente tienes.
Esta es la diferencia de arquitectura real, y explica buena parte de la brecha de costo. Databricks construyó su plataforma sobre Apache Spark, que reparte el trabajo en un clúster de máquinas. Querri usa DuckDB, un motor analítico en proceso, extremadamente rápido en una sola máquina, sobre archivos abiertos Parquet e Iceberg.
Databricks
Spark distribuido, en clústeres que pagas mientras están en marcha
- Spark y el motor Photon escalan horizontalmente en muchas máquinas. Para muchos terabytes, streaming y ML, nada lo supera.
- Los clústeres facturan DBUs y máquinas de nube mientras están encendidos, incluido el tiempo inactivo antes de la terminación automática, que puede fijarse en hasta 10,000 minutos o desactivarse.
- Iniciar un clúster tarda minutos; serverless arranca más rápido con una tarifa de DBU más alta.
- Tablas abiertas Delta e Iceberg en el almacenamiento de tu propia nube.
Querri
DuckDB sobre archivos abiertos, a la medida de los datos de negocio
- Los datos de cada organización se guardan como Parquet en tablas Apache Iceberg, en su propio almacenamiento.
- DuckDB los consulta en proceso: no hay clúster que iniciar, dimensionar, mantener caliente ni pagar mientras está inactivo.
- Python entra en juego donde un dataframe supera a SQL.
- Formatos abiertos de principio a fin, así que nada de tus datos queda atado a un motor propietario.
Dónde cada motor es la herramienta adecuada
Por qué la arquitectura se nota en la factura
Un clúster de Spark factura las máquinas que están encendidas, no el trabajo que hacen, y paga un costo de arranque y de coordinación para repartir incluso un trabajo pequeño. En un benchmark público con la misma carga de 5 GB, DuckDB en un solo nodo usó alrededor de una quinta parte del cómputo que usó Spark. Querri está construido sobre esa arquitectura, con los conectores, la limpieza, las definiciones, los dashboards y la IA ya incluidos, en un solo plan predecible.
Integrado, no ensamblado
Todo lo que hay entre tus datos y la respuesta, en un solo producto
En el camino del lakehouse, estas son piezas separadas que hay que construir, conectar y mantener curadas. En Querri son una sola cadena: los datos nuevos reconstruyen las vistas que dependen de ellos, los KPI se recalculan y cada actualización de dashboard vuelve a ejecutar su consulta guardada, así que cualquier número se puede rastrear hasta su fuente.
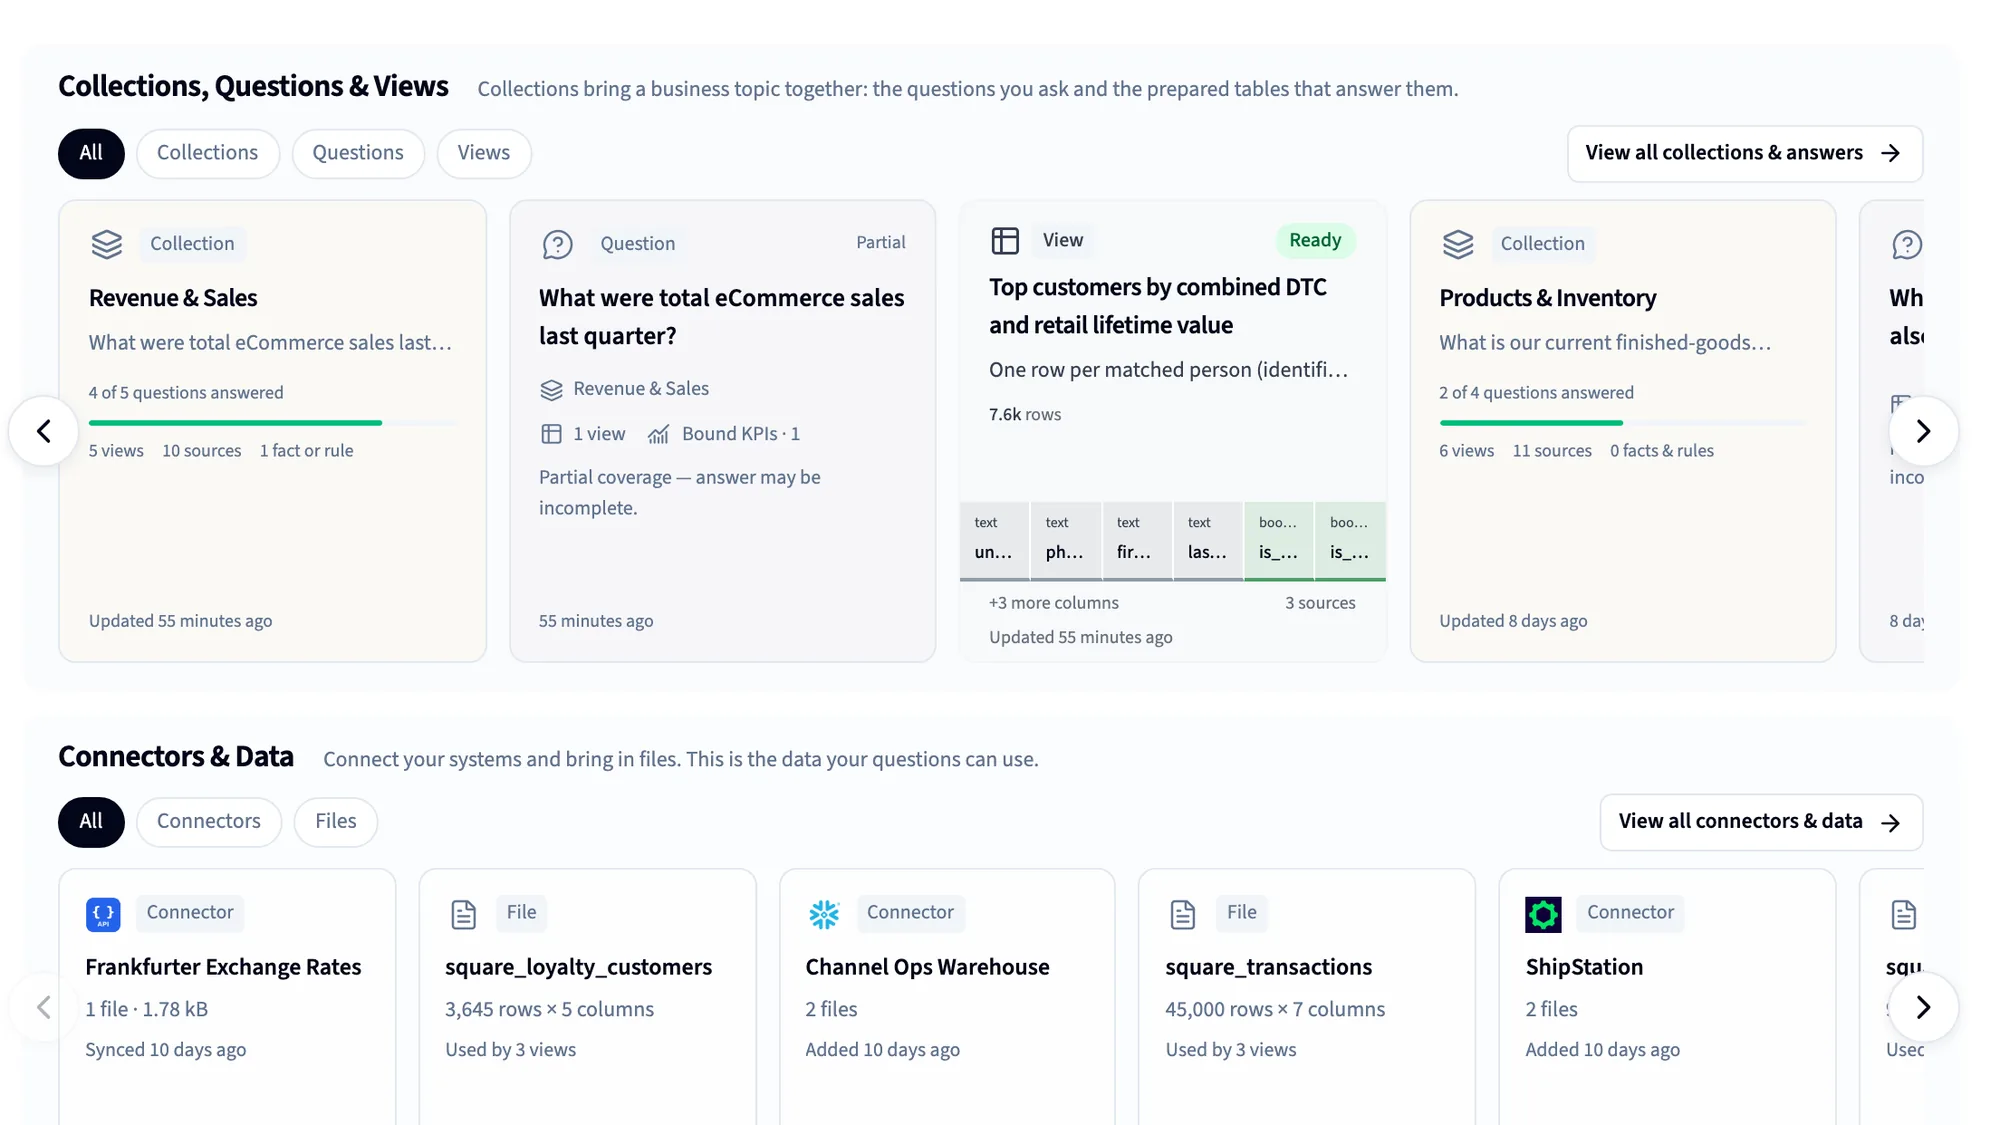
Más de 125 conectores
CRM, contabilidad, ERP, pagos, publicidad y bases de datos, además de hojas de cálculo y archivos.
Limpieza de datos automática
Más de 180 controles en cada tabla, y el Janitor para corregir lo que encuentran.
La Biblioteca
Una capa semántica pensada para el negocio: definiciones, KPI y reglas, enseñadas con solo decirlas.
Dashboards
Creados pidiéndolos o a partir de una captura, compartidos con visualizadores ilimitados.
Análisis nocturno y Monitores
Querri recorre tus datos durante la noche y te muestra qué cambió.
MCP para Claude y ChatGPT
Todos los asistentes responden con las mismas definiciones, con los permisos de cada persona.
Informes y Excel
Proyectos programados, libros con formato y presentaciones, entregados sin que tengas que hacer nada.
Marca blanca e integración
Lleva esa misma comprensión a tu propio producto, con tu marca.
Usar ambos
Cómo funcionan juntos Databricks y Querri
Muchos equipos usarán ambos, y es una buena configuración. Mantén Databricks para la ingeniería, el machine learning y los datos más grandes, y deja que Querri sea donde el negocio pregunta. Querri puede funcionar directamente encima de Databricks: deja las tablas en el lakehouse y consúltalas en vivo, o sincroniza las que prefieras que guarde Querri, junto a los sistemas que nunca llegaron al lakehouse.
Mantén en Databricks
- Pipelines de Spark y datos muy grandes
- Machine learning, entrenamiento y despliegue de modelos
- Streaming en tiempo real
- Pipelines que alimentan otros sistemas
Haz en Querri
- Preguntas de negocio en todos los sistemas
- Definiciones que son del negocio, en lenguaje claro
- Dashboards para todos, con visualizadores ilimitados
- Respuestas de IA en Querri, Claude y ChatGPT
Cómo funciona la conexión
-
Querri lee solo las tablas que eliges, con un service principal con OAuth o un token de acceso personal, con acceso de lectura.
-
Cada tabla es Live o sincronizada, tú eliges. Una tabla Live se queda en Databricks: cada pregunta se ejecuta en tu SQL warehouse como una única consulta de solo lectura en Databricks SQL, con las reglas de filas de cada persona aplicadas dentro, y solo vuelve el resultado. Las tablas Live están disponibles en los planes Scale.
-
Las consultas Live usan el cómputo de tu SQL warehouse, y un warehouse detenido añade unos segundos a la primera pregunta. Las tablas sincronizadas solo tocan Databricks cuando se sincronizan, así que las preguntas del día a día sobre ellas no mantienen un warehouse encendido. Las tablas muy grandes suelen encajar con Live; las pequeñas que exploras mucho suelen encajar con la sincronización.
-
Querri nunca escribe de vuelta en Databricks, y tus datos nunca se usan para entrenar ningún modelo.
Preguntas frecuentes
Preguntas que se hace la gente al comparar Querri y Databricks
¿Querri reemplaza a Databricks?
Para un equipo sin ingenieros de datos que quiere respuestas de negocio, Querri cubre aquello para lo que construiría un lakehouse: conectar sistemas, almacenar y limpiar los datos, definir métricas, dashboards e IA. Para machine learning, streaming, ingeniería de datos intensiva o datos a escala de petabytes, Databricks es la plataforma más fuerte, y Querri funciona encima de ella: mantén tus datos en el lakehouse y deja que el negocio les haga preguntas directamente.
¿Cuánto cuesta Databricks al mes?
Databricks factura DBUs según el tipo de carga de trabajo, aproximadamente $0.15 por DBU para trabajos hasta unos $0.70 para SQL serverless (cifras de terceros para EE. UU.), más las máquinas y el almacenamiento de tu propia cuenta de nube en una factura aparte. Vendr reporta un contrato mediano de unos $333,000 al año, dentro de un rango amplio. Querri es un solo plan predecible con IA y dashboards incluidos; consulta los planes actuales.
¿Por qué mi factura de Databricks es tan alta?
Normalmente, por algunos patrones: clústeres que siguen encendidos hasta una terminación automática larga, trabajos que se ejecutan en cómputo all-purpose en lugar de cómputo de trabajos, clústeres sobredimensionados y un autoescalado generoso, SQL warehouses funcionando día y noche para un informe pequeño, y la factura de nube que llega aparte de los DBUs. Las políticas de cómputo, una terminación automática corta, el etiquetado y los presupuestos ayudan, y exigen la atención continua de alguien.
¿Cuánto cuesta Databricks Genie?
Genie incluye una asignación mensual gratuita para su uso de modelos. Por encima de ella, el uso de Genie se factura en DBUs desde el 8 de julio de 2026, y el cómputo del SQL warehouse detrás de cada respuesta se factura aparte. Los presupuestos de Genie de Databricks no son un tope absoluto de gasto. En Querri, la IA está incluida en todos los planes, a partir de una asignación mensual fija de créditos.
¿Databricks es demasiado para una empresa pequeña?
Puede serlo. Databricks está hecho para grandes volúmenes de datos, ingeniería y machine learning, y sus buenas prácticas dan por hecho un equipo de plataforma. Si tus datos son datos de negocio de unos pocos sistemas y caben holgadamente en una sola máquina, las fortalezas de la plataforma quedan sin usar, pero sus costos y su mantenimiento no. Querri te da respuestas sin la plataforma.
¿DuckDB es más rápido que Spark?
Para datos que caben en una sola máquina, normalmente sí. DuckDB se ejecuta en proceso, sin clúster que iniciar, así que se ahorra la sobrecarga de arranque y coordinación de Spark; un benchmark en Microsoft Fabric encontró que DuckDB en un solo nodo usó alrededor de una quinta parte del cómputo de Spark en el mismo trabajo de 5 GB. Para muchos terabytes, streaming o ML, Spark es la herramienta adecuada.
¿Cuántos datos puede manejar Querri?
Querri está hecho para los datos con los que funcionan las empresas: CRM, contabilidad, ERP, publicidad, pagos y hojas de cálculo, normalmente de megabytes a cientos de gigabytes. Los archivos se suben con hasta 2 GB cada uno, y el almacenamiento crece con tu plan. Si tus datos ocupan muchos terabytes, mantenlos en el lakehouse y consúltalos en vivo desde Querri, o sincroniza las tablas curadas que tu equipo ya construyó.
¿Genie necesita un equipo de datos?
Las propias buenas prácticas de Databricks dicen que hay que empezar con cinco tablas o menos, escribir buenas descripciones en Unity Catalog y dejar la curación del agente a "analistas de datos con dominio de SQL". Los socios añaden que Genie multiplica el valor de una buena gobernanza, pero no la sustituye. Querri construye su comprensión a medida que tu equipo pregunta, y las personas que conocen el negocio definen qué significan los números.
¿Querri puede conectarse a Databricks?
Sí, de dos formas, elegidas tabla por tabla. Las tablas Live se quedan en Databricks y se consultan donde están, en solo lectura, con las reglas de filas de cada persona aplicadas dentro de la consulta. Las tablas sincronizadas se copian a Querri según una programación, junto a más de 125 sistemas de negocio. En ambos casos, el negocio puede hacer preguntas mientras tus ingenieros siguen construyendo.
¿Querri consulta Databricks en vivo?
Sí, para las tablas que elijas. Una tabla Live se queda en tu lakehouse: Querri guarda solo sus columnas y un número estimado de filas, escribe cada pregunta en Databricks SQL, la ejecuta en tu SQL warehouse como una única SELECT de solo lectura y trae solo el resultado. Las consultas Live usan el cómputo de tu warehouse; las tablas sincronizadas se responden desde la copia de Querri y no lo usan. Las tablas Live están disponibles en los planes Scale.
¿Puedo mantener mis datos en Databricks y aun así usar Querri?
Sí. Haz Live las tablas y se quedan en Databricks: Querri nunca copia sus filas, ni siquiera en las actualizaciones programadas. Las escrituras, otras tablas, las lecturas de archivos y los ajustes de sesión se rechazan antes de que nada llegue al warehouse, y las reglas de filas de cada persona se aplican dentro de la consulta. Los resultados de las preguntas se guardan en Querri como cualquier respuesta, así que los gráficos, los dashboards, las exportaciones y las preguntas de seguimiento funcionan sobre ellos.
¿Las consultas Live usan cómputo de Databricks?
Sí. Las consultas Live se ejecutan en tu SQL warehouse, así que aparecen en tu factura de Databricks, y un warehouse detenido añade unos segundos a la primera pregunta; en nuestras pruebas, un warehouse serverless en frío añadió entre 5 y 10 segundos. Antes de una actualización programada, Querri revisa si la tabla cambió, con una revisión de metadatos que no arranca el warehouse, y no ejecuta nada si no ha cambiado. Si prefieres que las preguntas no usen cómputo, sincroniza la tabla.
¿Necesito un lakehouse para usar IA con mis datos?
No para obtener respuestas de negocio. Un lakehouse es una base sólida para ingeniería, ML y datos muy grandes, y construirlo y operarlo exige ingenieros. Querri te da el almacenamiento, la limpieza, las definiciones y las respuestas en un solo producto, y puedes añadir un lakehouse más adelante si llegas a necesitarlo.
¿Cuál es la mejor alternativa a Databricks para un equipo sin ingenieros de datos?
Una que no necesite un clúster, un catálogo y tablas curadas antes de la primera respuesta. Querri conecta tus sistemas, limpia los datos automáticamente, aprende tus definiciones en lenguaje sencillo y crea dashboards con solo pedirlos, con un solo plan predecible. Puedes empezar con el plan gratuito.
¿Puedo probar Querri primero con mis propios datos?
Sí. Puedes empezar con el plan gratuito, sin tarjeta de crédito, conectar una fuente y preguntar. Consulta los planes para ver qué incluye cada uno. O trae tu pregunta más difícil a una demostración guiada de 20 minutos.
Fuentes
De dónde vienen estos datos
Verificado el 15 de octubre de 2026. Databricks actualiza sus precios y productos con frecuencia; si algo aquí está desactualizado, avísanos y lo corregiremos.
- Best practices for cost optimization Databricks docs
- Manage compute (auto-termination) Databricks docs
- Compute policies Databricks docs
- Account budgets Databricks docs
- Billable usage system table Databricks docs
- Genie budgets Databricks docs
- Genie pricing Databricks
- Genie agents best practices Databricks docs
- Databricks launches Genie One Databricks, Jun 2026
- Import Power BI and Tableau dashboards Databricks docs
- Real-time mode for Structured Streaming is GA Databricks, Mar 2026
- Standard tier retirement on Azure Databricks Microsoft Learn
- Databricks hits $7B run-rate Constellation Research, Aug 2026
- Databricks contract data (median contract) Vendr
- Estimating Databricks annual costs Databricks Community, Aug 2026
- Genie pricing, capabilities and ROI requirements (a Databricks partner) Addepto, Jul 2026
- Databricks FinOps optimization strategies Xebia, Sep 2026
- "Dumped Databricks once the first bill came" Hacker News, Nov 2025
- "A small server in a cupboard" Hacker News, Aug 2025
- Why TPC is not enough: Redshift fleet analysis (Redset) Amazon, VLDB, 2024
- The hunt for big data in the Redshift files MotherDuck, Aug 2024
- Fabric benchmark: Spark versus Python notebooks endjin, Apr 2026
- Why DuckDB DuckDB
- Big Data is Dead MotherDuck (Jordan Tigani), Feb 2023
- Is Big Data Dead? MotherDuck and the small data manifesto DataCamp podcast (Ryan Boyd), Oct 2024
- Querri pricing Querri
- Predictable credit use Querri docs
Sigue comparando
Comparaciones relacionadas
Mira tus propios datos responder antes de empezar un proyecto de lakehouse
Conecta un sistema o sube una hoja de cálculo, haz la pregunta que más importa y mira la consulta detrás de la respuesta. Si Databricks encaja mejor, te lo diremos.