Como operações e finanças conseguem respostas do Databricks sem um notebook?
Por que é difícil
As tabelas estão limpas e documentadas, mas os únicos jeitos de lê-las são um notebook, o editor de SQL ou um dashboard que outra pessoa escreveu.
 Databricks + Querri
O lakehouse guarda o que operações, finanças e vendas querem saber. O Querri põe as tabelas que você escolher numa só Biblioteca, junto com o resto do seu negócio, consultadas ao vivo no Databricks ou sincronizadas como cópia, para que qualquer pessoa pergunte sobre elas em linguagem natural e receba as respostas com as definições do seu time.
O Querri só lê o Databricks, com credenciais guardadas criptografadas e fora da vista do agente. Certificações SOC 2 Type II, HIPAA e ISO 27001:2022.
Por que os relatórios do Databricks empacam
Os engenheiros de dados migram para o Databricks porque ele dá conta do trabalho pesado de pipelines. O atrito aparece depois, quando alguém de fora do time de dados tem uma pergunta sobre o que está lá dentro.
Um gerente regional não vai abrir um notebook nem o editor de SQL. Cada pergunta vira um pedido ao time de dados, e a fila cresce mais rápido que o time.
Receita líquida é um CASE num notebook, um modelo do dbt em outro e um filtro um pouco diferente na consulta de um dashboard. Ninguém fora da engenharia consegue ver qual está certo.
Por padrão, os SQL warehouses classic e pro esperam 45 minutos ociosos antes de parar, e os serverless, 10. Um fio de perguntas avulsas ao longo do dia mantém um warehouse cobrando.
Uma tabela de notebook mostra no máximo 10.000 linhas ou 2 MB, o que for menor. Qualquer coisa maior é baixada, colada no Excel e enviada por e-mail, e as cópias começam a divergir.
O Unity Catalog decide quem lê qual tabela dentro do Databricks. Quando um CSV sai do workspace, essas permissões não vão junto, e cada destinatário vê todas as linhas.
Live ou sincronizada
Cada tabela pode ser Live ou sincronizada, e você escolhe tabela por tabela. Uma tabela Live nunca sai do Databricks: o Querri guarda só as colunas dela e uma estimativa do número de linhas, cada pergunta roda no seu SQL warehouse sobre os dados como estão agora, e só o resultado, pequeno, volta.
Live
O Querri escreve cada pergunta em Databricks SQL e a executa no seu SQL warehouse. Nada é copiado, nem nas atualizações agendadas. Clique num número da resposta e ele mostra a tabela, a conexão e um selo Live.
Ideal para
Sincronizada
O padrão. O Querri copia a tabela para o próprio armazenamento e responde a partir dessa cópia, então as perguntas não ligam um SQL warehouse.
Ideal para
O Querri só envia um único SELECT sobre as tabelas que você escolheu. Escritas, múltiplos comandos, outras tabelas, leituras de arquivos e configurações de sessão são recusados antes que qualquer coisa chegue ao Databricks.
Os filtros de linhas de cada pessoa no Querri são aplicados dentro da consulta do Databricks, então as linhas que ela não pode ver são filtradas antes que qualquer coisa saia do lakehouse.
Toda consulta Live leva uma tag de consulta que você encontra no histórico de consultas do Databricks. Os resultados param em 100.000 linhas por padrão, e um resultado cortado por esse limite vem sinalizado.
As consultas Live rodam no seu SQL warehouse, então usam a computação dele. Antes de uma atualização agendada, o Querri confere os metadados da tabela, o que não liga o warehouse, e não executa nada se a tabela não mudou.
As tabelas Live estão disponíveis nos planos Scale. Ver o plano Scale
O que você finalmente consegue responder
Cada uma é um pedido que chega todo mês a um time de lakehouse, o motivo de demorar tanto hoje e o que o Querri faz com ele.
Por que é difícil
As tabelas estão limpas e documentadas, mas os únicos jeitos de lê-las são um notebook, o editor de SQL ou um dashboard que outra pessoa escreveu.
Por que é difícil
O uso medido chega ao lakehouse, enquanto as faturas são emitidas no ERP. Comparar os dois exige um pipeline que ninguém construiu ainda, ou uma planilha de fim de mês.
Com o Querri
Conecte o NetSuite ao lado do Databricks e o Querri alinha o uso medido de cada cliente com as faturas de uso dele. Diga uma vez em Fatos e regras quais eventos são cobráveis, e a lista de clientes não cobrados segue essa regra.
Por que é difícil
A definição combinada fica no código de transformação. Um líder de vendas que refaz o número numa planilha chega perto, e é chegando perto que dois números acabam na mesma reunião.
Com o Querri
Escreva a definição em palavras simples na Biblioteca e acompanhe-a como um KPI. O chat, os dashboards e os relatórios agendados leem o mesmo significado, e o KPI guarda o histórico desde o dia em que você começa.
Por que é difícil
O modelo grava a previsão numa tabela Delta e segue em frente. Conferi-la com os pedidos reais, semana a semana e região por região, não é trabalho de ninguém.
Com o Querri
Conecte a tabela de previsão e a de pedidos, ao vivo ou sincronizadas, e acompanhe o erro da previsão como um KPI. Os Insights noturnos comparam cada região com o próprio histórico toda noite e põem na sua Caixa de entrada a que estiver se desviando.
Por que é difícil
Alguém roda a consulta, baixa o resultado, formata a planilha e a divide por região à mão. Na semana de folga dessa pessoa, ninguém recebe.
Com o Querri
Salve o recorte por região como um projeto com execução às 7h de segunda. Relatórios e automação o executa de novo sobre dados atuais e envia por e-mail a cada gerente uma pasta de trabalho formatada só com a região dele, montada com as Ferramentas de Excel.
Por que é difícil
Os pedidos estão no lakehouse e as conversas, na ferramenta de suporte. Ninguém junta os dois, então o custo de um mês ruim de suporte nunca aparece na receita.
Com o Querri
Conecte o Intercom ao lado do Databricks e pergunte. O Querri cruza os clientes entre os dois e diz como fez esse cruzamento. O playbook de volume de tickets mostra como encontrar os contatos que sempre voltam.
Por que é difícil
Acesso ao workspace para gente de fora é uma revisão de segurança, e uma ferramenta de BI separada para relatórios de clientes é mais um contrato e mais uma cópia do modelo de dados.
Com o Querri
Crie o dashboard pedindo e depois faça o embed dele no seu próprio portal, com um filtro de linhas por cliente. Com a marca branca, ele leva a sua marca, não a nossa.
Por que é difícil
Um assistente que recebe nomes crus de tabelas adivinha qual coluna é receita e por qual data filtrar. A resposta soa bem, esteja certa ou não.
Com o Querri
Conecte o Querri ao Claude ou ao ChatGPT, e as perguntas sobre dados do lakehouse são respondidas a partir da sua Biblioteca, dentro do acesso de cada pessoa no Querri. Quando uma pergunta tem duas leituras, ele diz qual leitura usou.
O Databricks e o resto
A engenharia leva primeiro os dados de alto volume para o Databricks. O ERP, o CRM, a central de suporte e a planilha de orçamento muitas vezes esperam a vez. O Querri os coloca em uma só Biblioteca ao lado das suas tabelas do lakehouse, então uma pergunta que cruza sistemas não precisa de um novo job de ingestão.
O Databricks combina bem com
Respostas que você pode defender
"Quantos pedidos atrasaram em setembro?" pode contar os pedidos que saíram do armazém depois da data prometida ou os que chegaram ao cliente depois dela. As duas leituras são justas, e operações e atendimento ao cliente preferem cada um uma delas. O Querri responde com uma leitura, diz qual é e mostra a outra contagem, para que a discussão seja sobre resolver os atrasos, não sobre a consulta. Veja como uma resposta é conferida antes de chegar a você.
Acorde sabendo o que mudou
Toda noite o Querri compara os seus KPIs com o próprio histórico deles, com aritmética simples, e procura a mudança sobre a qual ninguém perguntou. O que ele encontra espera na sua Caixa de entrada de manhã, e nada muda até você aprovar.
Dashboards personalizados do Databricks
Peça o layout numa frase, ou entregue um print do relatório que finanças abre toda segunda. As edições funcionam do mesmo jeito: um pedido em palavras simples. Os gráficos leem da mesma Biblioteca que o chat, e cada pessoa que vê pode ficar limitada às próprias linhas.
Pedidos que você pode parar de fazer à mão
Os números de cada região a partir das tabelas gold, como um arquivo do Excel formatado na caixa de entrada de cada gerente.
Veja as Ferramentas de ExcelClientes com uso medido no lakehouse e nenhuma fatura de uso correspondente no ERP, executado de novo no seu agendamento.
Veja os relatóriosPrevisões do modelo vindas de uma tabela Delta ao lado dos pedidos reais, com o erro acompanhado por região.
Veja os KPIsO uso do produto vindo do lakehouse com sinais de suporte e de faturamento, um score por conta.
Leia o playbookQuais problemas fazem os clientes voltar ao suporte, comparados com o que eles compram.
Leia o playbookO tempo entre a criação da conta e o primeiro evento que indica que o cliente vai ficar.
Leia o playbookO que é sincronizado
As tabelas sincronizadas, o padrão, são copiadas para o armazenamento do Querri, e as perguntas sobre elas são respondidas a partir dessa cópia, sem tocar no Databricks. Live ou sincronizada, o Querri só consegue ler o que o service principal ou o usuário do token tem permissão para ler.
O que você pode sincronizar
Cada sincronização relê por inteiro as tabelas que você escolheu, diária, semanal ou mensalmente, então as linhas alteradas ou excluídas no Databricks sempre chegam. Para uma tabela grande demais para ser copiada com essa frequência, mude-a para Live e cada pergunta a lê onde ela está.
As linhas chegam de 50.000 em 50.000, como arquivos Parquet tipados, e viram um dataset do Querri num armazenamento baseado em Iceberg. Há um limite de linhas por tabela, se você quiser um.
O Querri executa consultas de schema e SELECTs, nada mais. Ele nunca escreve numa tabela nem altera um registro. As sincronizações rodam no seu SQL warehouse, então usam a computação dele.
OAuth com um service principal, ou um token de acesso pessoal, criptografado em repouso e removido das mensagens de erro. O Connector Agent sabe que uma credencial existe, mas nunca vê a credencial em si.
Como conectar o Databricks
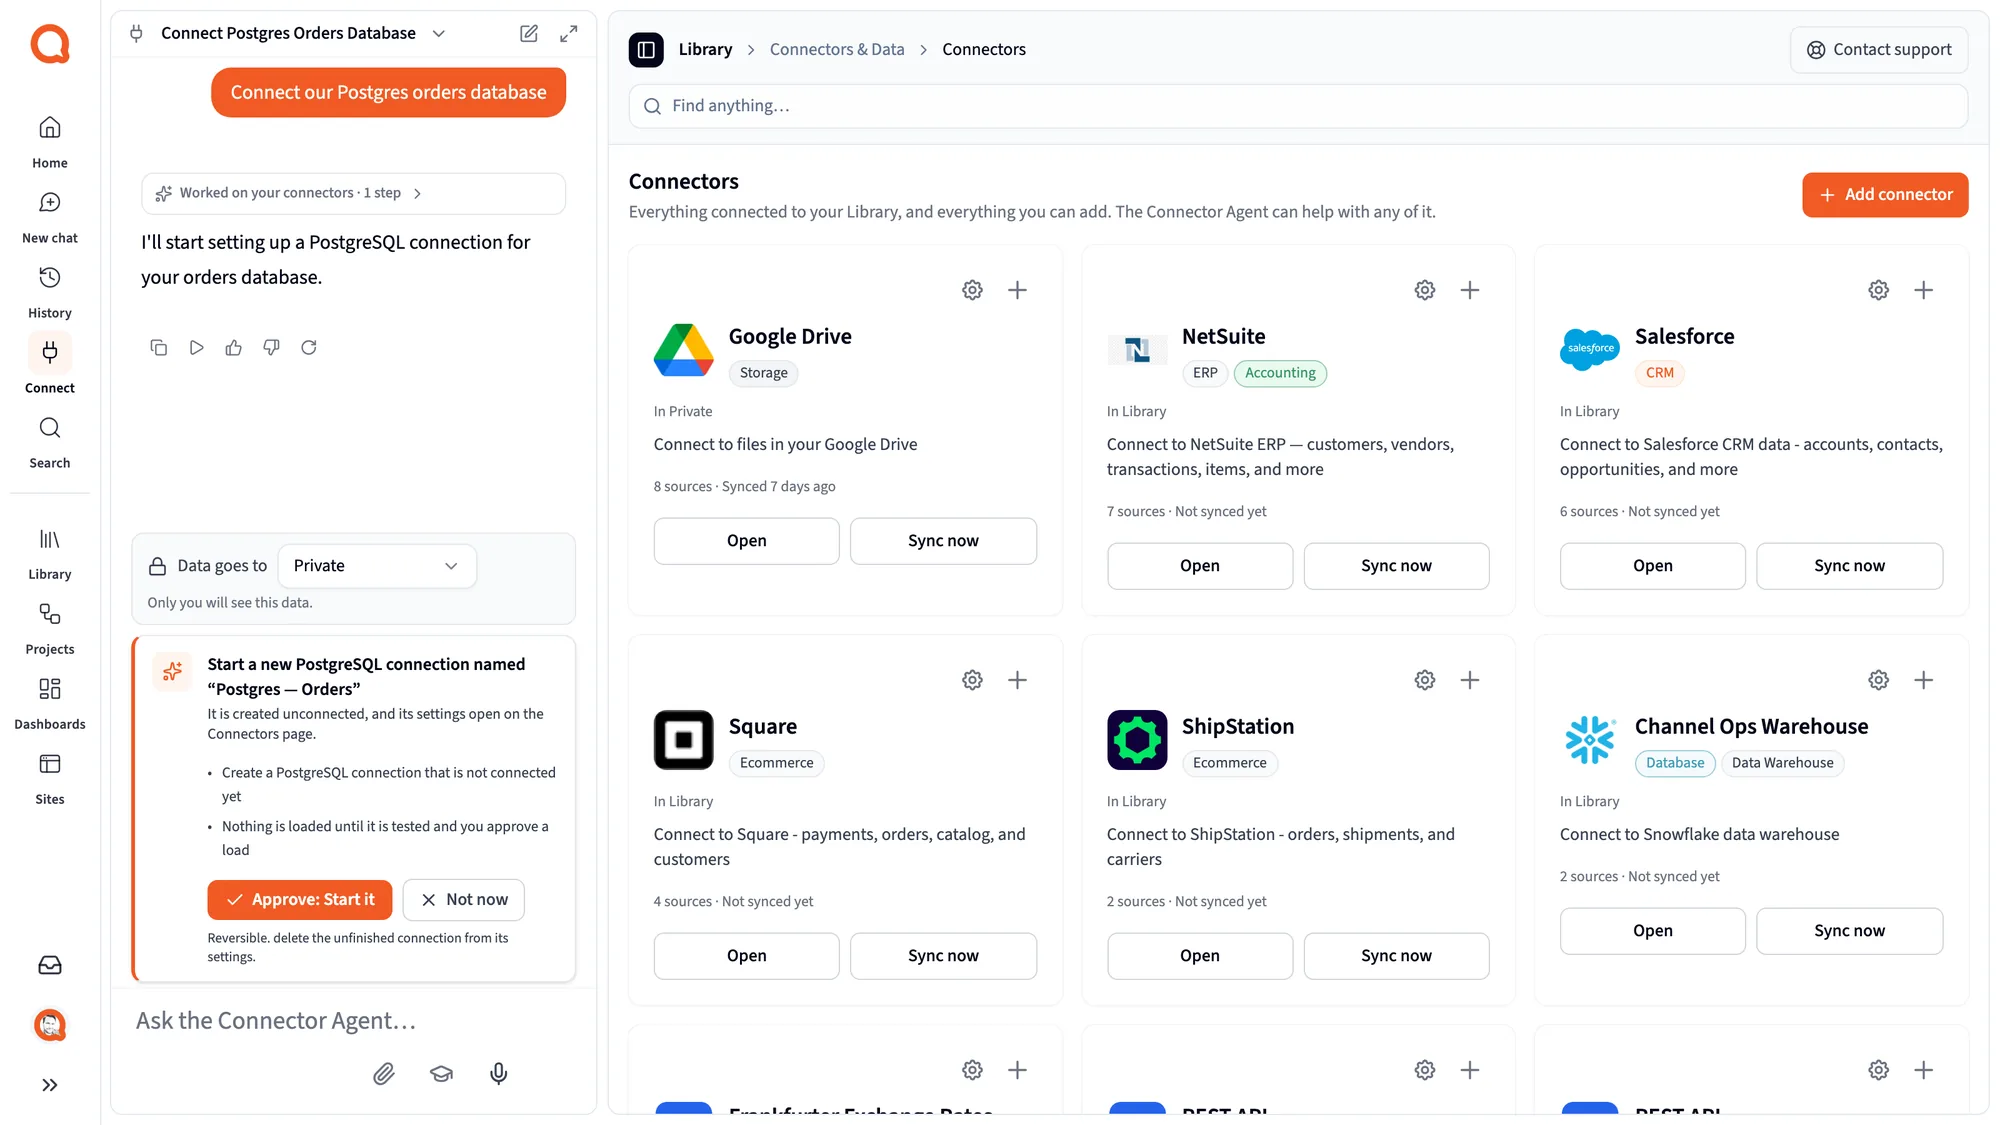
Em Connect, digite "adicione o nosso workspace do Databricks", ou clique no cartão do Databricks no catálogo.
Nos Connection details do seu SQL warehouse, copie o server hostname e o HTTP path.
Informe o client ID e o secret OAuth de um service principal, ou um token de acesso pessoal, e informe um catálogo e um schema se quiser outros que não os padrão.
Mantenha todas as tabelas ou escolha algumas, e escolha um agendamento. Para manter uma tabela no Databricks, mude-a para Live. Nada é carregado até você aprovar.
As tabelas Live ficam prontas assim que o Querri lê as colunas delas, e as sincronizadas quando a primeira carga chega. Depois disso, pergunte sobre as tabelas do lakehouse no chat, ou crie dashboards e relatórios agendados a partir delas.
Perguntas frequentes sobre o Databricks
Diga ao Connector Agent que você quer o Databricks, ou escolha o cartão dele no catálogo. Informe o server hostname e o HTTP path dos Connection details do seu SQL warehouse e depois as credenciais OAuth de um service principal ou um token de acesso pessoal no formulário seguro. Se quiser, informe um catálogo e um schema. Depois escolha as tabelas, defina quais ficam Live e com que frequência as demais são atualizadas, e aprove.
As tabelas e views do schema que você escolher, todas ou uma lista que você selecionar, com as colunas e os tipos delas. Funciona com Unity Catalog ou com o Hive metastore, por um SQL warehouse. O Querri só consegue ler o que o usuário ou o service principal do token consegue ler.
As tabelas sincronizadas são relidas por inteiro diária, semanal ou mensalmente, então as linhas alteradas ou excluídas no Databricks aparecem após a próxima execução. Antes de uma reunião importante, dispare uma à mão. As tabelas Live estão sempre atuais: cada pergunta lê o Databricks como ele está quando é executada.
Não. O Querri só lê as suas tabelas do Databricks e nunca altera um registro nelas. Ele executa consultas de schema e SELECTs e nunca cria, atualiza ou exclui uma tabela ou linha; as consultas Live são verificadas antes do envio, então só um único SELECT sobre as tabelas que você escolheu chega ao Databricks. Essas consultas rodam no seu warehouse, então as sincronizações e as perguntas Live usam a computação dele.
O Querri só consegue ler o que foi concedido ao service principal ou ao usuário do token, então um service principal com acesso de leitura apenas ao schema que você quer é a configuração mais limpa. Dentro do Querri, as permissões do Unity Catalog não valem pessoa a pessoa: o compartilhamento do Querri e um filtro de linhas para cada pessoa decidem o que ela vê, e nas tabelas Live esse filtro é aplicado dentro da consulta do Databricks.
Pode, tabela por tabela. Uma tabela Live fica no Databricks: cada pergunta que precisa dela roda no seu SQL warehouse como uma consulta escrita em Databricks SQL, e só o resultado volta. Essas consultas usam a computação do warehouse, e um warehouse parado acrescenta alguns segundos à primeira pergunta. As tabelas sincronizadas são respondidas a partir da cópia do Querri, então essas perguntas nunca acordam um SQL warehouse e refletem a sincronização mais recente. As tabelas Live estão disponíveis nos planos Scale.
Deixe-a Live quando a tabela for muito grande, quando os dados precisarem ficar no lakehouse ou quando toda resposta tiver que refletir o Databricks como está agora. Mantenha-a sincronizada quando a tabela for pequena ou média, quando as pessoas a explorarem muito e você preferir não pagar computação do warehouse por pergunta, ou quando o warehouse demorar para ligar. Você pode voltar uma tabela Live para sincronizada a qualquer momento; ela é carregada na próxima sincronização completa.
Sim. Perguntas sobre várias tabelas Live da mesma conexão rodam como uma só consulta no Databricks. Quando uma pergunta também precisa de uma tabela sincronizada ou de um arquivo enviado, o Querri primeiro resume a tabela Live no Databricks e depois combina esse resultado pequeno com os outros dados no Querri. Isso acontece automaticamente, e clicar num número mostra de qual tabela ele veio, com um selo Live.
Conecte também o NetSuite, e os dois chegam à mesma Biblioteca. O Querri pode cruzar o uso, os pedidos ou os envios do lakehouse com as faturas, os pedidos de venda e os pagamentos do NetSuite por um número de pedido ou um cliente em comum, e diz como fez o cruzamento. Defina uma vez qual uso é cobrável ou quando um pedido conta como enviado, e toda resposta segue essa definição.
Conecte o Salesforce ao lado do Databricks. O Querri cruza as contas entre os dois, de preferência por um ID guardado nos dois, para você colocar a atividade de produto ou de pedidos ao lado do pipeline, das renovações e dos casos em aberto. Se um cruzamento depender de um nome em vez de um ID, a resposta avisa.
Transforme a análise num projeto e associe um agendamento semanal. Na segunda de manhã ele é executado de novo sobre os dados atuais do lakehouse e envia a cada gerente uma pasta de trabalho formatada só com a região dele, ou uma por cliente. O passo de baixar e colar deixa de existir.
Conecte a tabela Delta em que o seu modelo grava a previsão, mais a tabela de pedidos ou de vendas, ao vivo ou sincronizadas. Defina uma vez o erro da previsão como um KPI, por região ou por produto. O Querri guarda o histórico dele desde o dia em que você começa, e os Insights noturnos sinalizam a região cujo erro se desvia.
Sim. Peça o dashboard em palavras simples, ou comece de um print de um que o seu time já usa, e altere-o pedindo. Um só dashboard pode misturar tabelas do lakehouse com dados do ERP, do CRM ou de planilhas, limitar cada pessoa às próprias linhas e ser incorporado no seu próprio app.
Sim. Depois de uma configuração única no Claude ou no ChatGPT, as perguntas sobre tabelas do lakehouse usam a sua Biblioteca do Querri, seguem as suas definições e regras e ficam dentro do que cada pessoa pode ver no Querri, então o assistente e os seus dashboards concordam.
Sim. OAuth com um service principal (máquina a máquina) é a configuração recomendada: informe o client ID e o secret dele, e os tokens de curta duração dispensam rotação. Um token de acesso pessoal também funciona. De qualquer forma, a conexão não depende do login de nenhum funcionário.
Uma conexão cobre um único catálogo e schema. Consultas SQL personalizadas não são suportadas, então selecione tabelas ou views. Não há escrita de volta. Por padrão, os resultados Live param em 100.000 linhas e as perguntas no chat expiram após 2 minutos. Vários catálogos ou schemas significam simplesmente várias conexões.
Ainda não. O Querri se conecta ao seu workspace por HTTPS na porta 443, então o workspace precisa estar acessível pela internet. Se um warehouse estiver parado ou o host estiver errado, a conexão desiste em poucos minutos em vez de ficar travada.
Sim. Deixe uma tabela grande como Live e ela fica no Databricks, onde cada pergunta roda, e só o resultado volta. As tabelas sincronizadas chegam em lotes de 50.000 linhas em arquivos Parquet tipados, em vez de uma única extração gigante, e o progresso aparece à medida que as linhas chegam. Você também pode limitar as linhas por tabela.
Não. Depois que as tabelas são conectadas, qualquer pessoa com acesso pergunta em linguagem natural. O Querri mostra os passos por trás de cada resposta, então alguém do time de dados pode conferir a lógica, e uma boa resposta pode ser salva como um projeto que é executado de novo com dados atualizados.
O Querri tem certificação SOC 2 Type II, HIPAA e ISO 27001:2022, e os seus dados nunca são usados para treinar um modelo. As suas credenciais são criptografadas em repouso, removidas das mensagens de erro e nunca mostradas ao Connector Agent, e a conexão usa apenas HTTPS.
Continue explorando
Conecte com um hostname, um HTTP path e um service principal ou token, e depois consulte o lakehouse ao vivo ou sincronize uma cópia. O Querri só lê e nunca escreve nele.