Querri vs Databricks
O Databricks é um lakehouse que você constrói. O Querri é a resposta que você veio buscar.
O mesmo objetivo: respostas confiáveis. Projetos muito diferentes.
O Databricks é uma das plataformas de dados mais capazes do mundo, feita para equipes de engenharia: um lakehouse, pipelines, um catálogo, tabelas curadas, duas contas e as pessoas para operar tudo. O Querri é a plataforma de dados que começa pelas perguntas. Ele parte das perguntas que o seu negócio faz e constrói o que for preciso para respondê-las, em um só produto, com uma só conta previsível. Já usa o Databricks? Deixe as tabelas no lakehouse e deixe o Querri consultá-las diretamente.
Tempo, custo e controle
Respostas neste trimestre, uma conta que você consegue planejar e nenhuma equipe nova para contratar
O Databricks é uma plataforma sobre a qual equipes de engenharia constroem. O Querri é o caminho pronto dos seus sistemas até uma resposta. Veja o que essa diferença significa para o negócio.
-
Respostas em dias, não em trimestres
Um projeto de lakehouse leva de semanas a meses antes que o negócio receba uma resposta confiável. Com o Querri, você conecta um sistema ou envia um arquivo e pergunta no mesmo dia.
-
Uma conta que você consegue planejar, sem surpresas
O Databricks cobra DBUs mais as máquinas do seu provedor de nuvem: duas contas que variam com o uso. O Querri é uma só conta previsível: uma cota mensal de créditos ligada ao trabalho que a sua equipe faz, alertas antes de você chegar ao limite e nenhuma cobrança automática de excedente.
-
Sem precisar de uma equipe de dados
O Databricks precisa de engenheiros para construir as tabelas e de um analista para manter o Genie preciso. No Querri, as pessoas que já conhecem o negócio decidem o que os números significam, em linguagem simples.
-
Seguro, auditável e nada para substituir
SOC 2 Type II, HIPAA e ISO 27001:2022, e os seus dados nunca treinam um modelo. Cada número mostra a sua consulta, e se você já usa o Databricks, o Querri funciona sobre ele, ao vivo ou sincronizado, sem nada para mover.
Onde cada um se encaixa
Escolha pela equipe e pelo prazo que você tem
Preferimos que você escolha a ferramenta certa a nos escolher pelo motivo errado. Veja onde cada um se encaixa.
Escolha o Databricks quando
- Você tem engenheiros de dados que vão construir e operar pipelines Spark, tabelas Delta e o Unity Catalog, e manter o Genie curado.
- Os seus dados chegam a muitos terabytes ou petabytes, ou você precisa do Spark para transformações pesadas.
- Você treina e implanta modelos de machine learning, ou precisa de streaming em tempo real com latência abaixo de um segundo.
- Você quer uma só plataforma para engenharia de dados, ciência de dados e aplicações de IA, governada em um só catálogo.
- Alguém vai cuidar da conta: políticas de computação, encerramento automático, tags, orçamentos e a fatura da nuvem.
Escolha o Querri quando
- Você quer respostas de negócio em dias, não depois de um projeto de lakehouse, ou já usa o Databricks e quer que o negócio pergunte a ele diretamente.
- Os seus dados estão em sistemas de negócio (CRM, contabilidade, ERP, pagamentos, planilhas) e cabem em uma única máquina rápida.
- As pessoas que sabem o que os números significam não são engenheiras, e não deveriam precisar escrever visões de métricas para dizer isso.
- Você quer uma só conta previsível, não DBUs mais uma conta da nuvem que chegam separadas.
- Você quer dashboards, relatórios, um agente de IA, limpeza de dados e MCP para o Claude e o ChatGPT já incluídos, não montados.
Recurso por recurso
A comparação detalhada
Cada linha diz onde cada um é mais forte. Onde o Databricks vence, nós dizemos. Os fatos estão atualizados até outubro de 2026 e com links nas fontes.
Os preços de tabela do Databricks variam por nuvem, região, nível e contrato, e o Databricks não publica uma tabela única de preços; os números de DBU são estimativas de terceiros para a AWS nos EUA. Os fatos de produto vêm da documentação do Databricks em 15 de outubro de 2026.
Preços
O preço por consumo recompensa uma equipe que o acompanha
Pagar só pelo que você usa é uma vantagem real quando alguém faz essa gestão. O Databricks acrescenta um segundo medidor: as DBUs na conta do Databricks e as máquinas na sua conta da nuvem. Sem alguém vigiando os dois, o custo acompanha cada cluster esquecido ligado e cada pergunta que um agente responde, e os registros chegam horas depois.
Como o Databricks cobra
- Duas contas. DBUs para o Databricks, por tipo de carga, mais as máquinas virtuais e o armazenamento na sua conta na nuvem. O serverless embute as máquinas em uma taxa de DBU mais alta.
- As taxas variam por carga: cerca de US$ 0,15 por DBU para jobs a US$ 0,70 para SQL serverless (números de terceiros para os EUA). Rodar jobs em computação all-purpose custa "significativamente" mais.
- Clusters ociosos continuam cobrando até o encerramento automático, que vai de 10 a 10.000 minutos, ou nunca, se estiver configurado em 0.
- O Genie inclui uma cota mensal gratuita para o uso do modelo; acima dela, o Genie é cobrado em DBUs desde 8 de julho de 2026, e o SQL warehouse por trás dele é cobrado à parte.
- Os orçamentos alertam por e-mail. Os orçamentos do Genie não são "um teto absoluto de gasto", e as solicitações em andamento "não são interrompidas."
- Os registros de cobrança chegam "normalmente em até 12 horas", então um job descontrolado só aparece depois que o dinheiro já foi gasto.
Quando o preço por consumo é o melhor negócio
Se você tem uma equipe de plataforma que roda jobs em job compute, define políticas de computação e encerramento automático, aplica tags em tudo desde o primeiro dia e revisa as tabelas de sistema de cobrança, o Databricks pode ser muito econômico em escala, e o tempo de engenharia que ele economiza pode compensar a conta. Se essa é a sua equipe, os guias abaixo são o ponto de partida.
O que acontece quando ninguém está olhando
Vai escolher o Databricks? Mantenha os dois medidores sob controle.
Se o Databricks é a escolha certa para você, estes são os controles que mantêm a conta previsível. A maioria vem da própria documentação do Databricks.
- Boas práticas de otimização de custo Job compute em vez de all-purpose, dimensionamento correto e tags desde o primeiro dia. Databricks docs
- Defina políticas de computação Limite as DBUs por hora e os clusters que cada pessoa pode criar. Databricks docs
- Configure o encerramento automático Computação ociosa cobra até parar. Mantenha o tempo limite curto. Databricks docs
- Crie orçamentos Alertas por e-mail quando o gasto mensal passa de um limite. Databricks docs
- Acompanhe as tabelas de sistema de cobrança Veja o uso por carga, usuário e tag, com cerca de 12 horas de atraso. Databricks docs
- FinOps no Databricks na prática O guia de campo da Xebia, com economias reais em computação ociosa e superdimensionada. Xebia
Como o Querri mantém a conta previsível
- Uma só conta, sem surpresas. Um só plano para toda a organização, com a IA, o armazenamento e os visualizadores de dashboards ilimitados incluídos. Veja planos e preços.
- Um crédito simples. Um crédito é uma unidade de trabalho de negócio, como responder a uma pergunta ou sincronizar uma fonte, então o uso é fácil de entender e fácil de planejar.
- Uma só conta. Armazenamento, computação e IA estão no plano. Não há fatura de nuvem por trás.
- Alertas de uso em 80% do plano, quando ele é ultrapassado e em picos, além de um limite mensal para qualquer pessoa.
- Nenhuma cobrança automática de excedente. Avisamos quando você se aproxima do limite, e você decide o que acontece depois.
- Visualizadores de dashboards ilimitados em todos os planos. Visualizar, enviar arquivos, exportar e usar a Biblioteca nunca consome créditos.
Custo total
O que é preciso para chegar à primeira resposta
O lakehouse é onde o trabalho começa. Antes que um usuário de negócio receba uma resposta confiável do Genie, alguém constrói as tabelas, o catálogo e as visões de métricas por trás dele. Este é o caminho típico do Databricks, ao lado do Querri.
O caminho do Databricks é uma estimativa nossa, com base em dados de contratos da Vendr, um modelo de custo da Databricks Community e faixas salariais nas fontes indicadas, não uma cotação. Uma implantação pequena e cuidadosa custa menos; se você já tem a equipe, a linha de pessoas é um custo que você já escolheu.
Arquitetura
Spark para os maiores dados. DuckDB para os dados que você realmente tem.
Esta é a verdadeira diferença de arquitetura, e ela explica boa parte da diferença de custo. O Databricks construiu a plataforma sobre o Apache Spark, que divide o trabalho entre um cluster de máquinas. O Querri roda o DuckDB, um motor analítico em processo extremamente rápido em uma única máquina, sobre arquivos abertos Parquet e Iceberg.
Databricks
Spark distribuído, em clusters que você paga enquanto estão ligados
- O Spark e o motor Photon escalam horizontalmente por muitas máquinas. Para muitos terabytes, streaming e ML, nada supera.
- Os clusters cobram DBUs e máquinas na nuvem enquanto estão ligados, incluindo o tempo ocioso antes do encerramento automático, que pode ser configurado para até 10.000 minutos ou desativado.
- Iniciar um cluster leva minutos; o serverless inicia mais rápido, com uma taxa de DBU mais alta.
- Tabelas abertas Delta e Iceberg no seu próprio armazenamento na nuvem.
Querri
DuckDB sobre arquivos abertos, dimensionado para dados de negócio
- Os dados de cada organização são armazenados como Parquet em tabelas Apache Iceberg, no próprio armazenamento dela.
- O DuckDB consulta tudo em processo: nenhum cluster para iniciar, dimensionar, manter aquecido ou pagar enquanto está ocioso.
- O Python entra quando um dataframe é melhor que SQL.
- Formatos abertos do começo ao fim, então nada nos seus dados fica preso a um motor proprietário.
Onde cada motor é a ferramenta certa
Por que a arquitetura aparece na conta
Um cluster Spark cobra pelas máquinas que estão ligadas, não pelo trabalho que fazem, e paga um custo de inicialização e coordenação para dividir até um job pequeno. Em um benchmark público com a mesma carga de 5 GB, o DuckDB em um único nó usou cerca de um quinto da computação que o Spark usou. O Querri é construído sobre essa arquitetura, com conectores, limpeza, definições, dashboards e IA já por cima, em um só plano previsível.
Incluído, não montado
Tudo entre os seus dados e a resposta, em um só produto
No caminho do lakehouse, estas são peças separadas para construir, conectar e manter curadas. No Querri, elas formam uma só cadeia: dados novos reconstroem as visões que dependem deles, os KPIs são recalculados e cada atualização de dashboard executa de novo a consulta salva, então qualquer número pode ser rastreado até a origem.
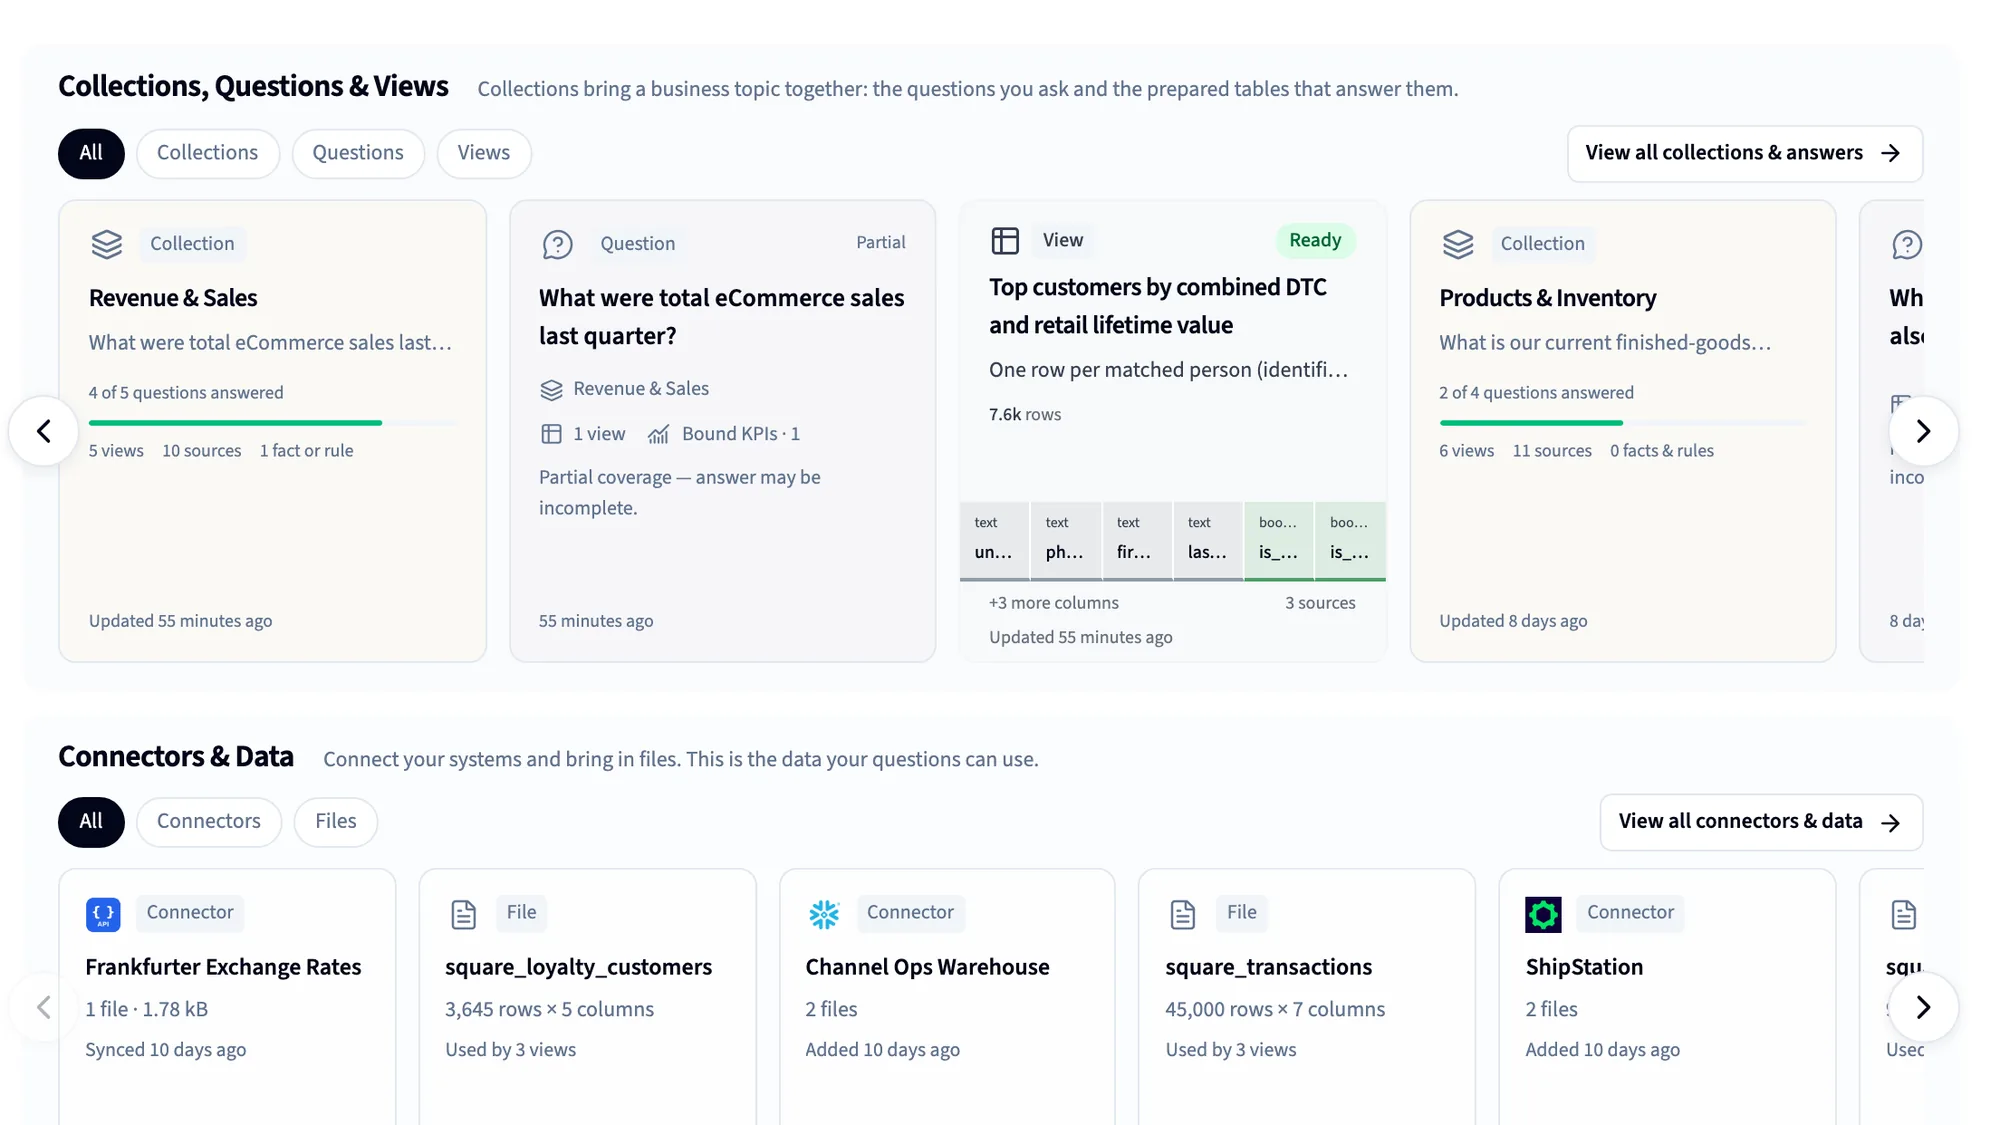
Mais de 125 conectores
CRM, contabilidade, ERP, pagamentos, anúncios e bancos de dados, além de planilhas e arquivos.
Limpeza automática de dados
Mais de 180 verificações em cada tabela, e o Janitor para corrigir o que elas encontram.
A Biblioteca
Uma camada semântica que começa pelo negócio: definições, KPIs e regras, ensinados simplesmente dizendo-os.
Dashboards
Criados pedindo ou a partir de uma captura de tela, compartilhados com visualizadores ilimitados.
Insights noturnos e Monitores
O Querri percorre os seus dados durante a noite e mostra o que mudou.
MCP para o Claude e o ChatGPT
Todo assistente responde a partir das mesmas definições, com o acesso de cada pessoa.
Relatórios e Excel
Projetos agendados, pastas de trabalho formatadas e apresentações, entregues para você.
White label e incorporação
Leve o mesmo entendimento para dentro do seu próprio produto, com a sua marca.
Usando os dois
Como o Databricks e o Querri funcionam juntos
Muitas equipes vão usar os dois, e essa é uma boa configuração. Mantenha o Databricks para engenharia, machine learning e os maiores volumes de dados, e deixe o Querri ser onde o negócio pergunta. O Querri pode funcionar direto sobre o Databricks: deixe as tabelas no lakehouse e consulte-as ao vivo, ou sincronize as que você prefere que o Querri guarde, ao lado dos sistemas que nunca chegaram ao lakehouse.
Mantenha no Databricks
- Pipelines Spark e dados muito grandes
- Machine learning, treinamento e serving de modelos
- Streaming em tempo real
- Pipelines que alimentam outros sistemas
Faça no Querri
- Perguntas de negócio em todos os sistemas
- Definições que pertencem ao negócio, em linguagem simples
- Dashboards para todos, com visualizadores ilimitados
- Respostas de IA no Querri, no Claude e no ChatGPT
Como a conexão funciona
-
O Querri lê apenas as tabelas que você escolhe, usando um service principal com OAuth ou um token de acesso pessoal, com acesso de leitura.
-
Cada tabela é Live ou sincronizada, você escolhe. Uma tabela Live fica no Databricks: cada pergunta roda no seu SQL warehouse como uma única consulta somente leitura em Databricks SQL, com as regras de linhas de cada pessoa aplicadas dentro dela, e só o resultado volta. As tabelas Live estão disponíveis nos planos Scale.
-
As consultas Live usam a computação do seu SQL warehouse, e um warehouse parado acrescenta alguns segundos à primeira pergunta. As tabelas sincronizadas só tocam o Databricks quando sincronizam, então as perguntas do dia a dia sobre elas não mantêm um warehouse ligado. Tabelas muito grandes costumam combinar com Live; as pequenas que você explora muito costumam combinar com a sincronização.
-
O Querri nunca grava de volta no Databricks, e seus dados nunca são usados para treinar nenhum modelo.
Perguntas frequentes
Perguntas comuns ao comparar o Querri e o Databricks
O Querri substitui o Databricks?
Para uma equipe sem engenheiros de dados que quer respostas de negócio, o Querri cobre aquilo para o qual ela construiria um lakehouse: conectar sistemas, armazenar e limpar os dados, definir métricas, dashboards e IA. Para machine learning, streaming, engenharia de dados pesada ou dados em escala de petabytes, o Databricks é a plataforma mais forte, e o Querri funciona sobre ele: mantenha os seus dados no lakehouse e deixe o negócio fazer perguntas a eles diretamente.
Quanto custa o Databricks por mês?
O Databricks cobra DBUs por tipo de carga, de cerca de US$ 0,15 por DBU para jobs a cerca de US$ 0,70 para SQL serverless (números de terceiros para os EUA), mais as máquinas e o armazenamento na sua própria conta na nuvem, em uma conta separada. A Vendr informa um contrato mediano de cerca de US$ 333.000 por ano, dentro de uma faixa ampla. O Querri é um só plano previsível, com IA e dashboards incluídos; veja os planos atuais.
Por que a minha conta do Databricks está tão alta?
Geralmente por alguns padrões: clusters que ficam ligados até um encerramento automático longo, jobs rodando em computação all-purpose em vez de job compute, clusters superdimensionados e autoscaling generoso, SQL warehouses ligados o tempo todo para um relatório pequeno, e a conta da nuvem que chega separada das DBUs. Políticas de computação, encerramento automático curto, tags e orçamentos ajudam, e exigem a atenção contínua de alguém.
Quanto custa o Databricks Genie?
O Genie inclui uma cota mensal gratuita para o uso do modelo. Acima dela, o uso do Genie é cobrado em DBUs desde 8 de julho de 2026, e a computação do SQL warehouse por trás de cada resposta é cobrada à parte. Os orçamentos do Genie no Databricks não são um teto absoluto de gasto. No Querri, a IA está incluída em todos os planos, a partir de uma cota mensal fixa de créditos.
O Databricks é exagero para uma empresa pequena?
Pode ser. O Databricks foi feito para dados grandes, engenharia e machine learning, e as boas práticas dele pressupõem uma equipe de plataforma. Se os seus dados são dados de negócio de alguns sistemas e cabem com folga em uma única máquina, os pontos fortes da plataforma ficam sem uso, enquanto os custos e a manutenção continuam. O Querri entrega respostas sem a plataforma.
O DuckDB é mais rápido que o Spark?
Para dados que cabem em uma única máquina, normalmente sim. O DuckDB roda em processo, sem cluster para iniciar, então evita a sobrecarga de inicialização e coordenação do Spark; um benchmark no Microsoft Fabric mostrou que o DuckDB em um único nó usou cerca de um quinto da computação do Spark no mesmo job de 5 GB. Para muitos terabytes, streaming ou ML, o Spark é a ferramenta certa.
Quantos dados o Querri aguenta?
O Querri foi feito para os dados que movem as empresas: CRM, contabilidade, ERP, anúncios, pagamentos e planilhas, normalmente de megabytes a centenas de gigabytes. Cada arquivo pode ter até 2 GB, e o armazenamento cresce com o seu plano. Se os seus dados somam muitos terabytes, mantenha-os no lakehouse e consulte-os ao vivo a partir do Querri, ou sincronize as tabelas curadas que a sua equipe já construiu.
O Genie precisa de uma equipe de dados?
As próprias boas práticas do Databricks dizem para começar com cinco tabelas ou menos, escrever boas descrições no Unity Catalog e ter o agente curado por "analistas de dados proficientes em SQL." Os parceiros acrescentam que o Genie multiplica uma boa governança, mas não a substitui. O Querri constrói o próprio entendimento conforme a sua equipe pergunta, e as pessoas que conhecem o negócio definem o que os números significam.
O Querri se conecta ao Databricks?
Sim, de duas formas, escolhidas tabela por tabela. As tabelas Live ficam no Databricks e são consultadas onde estão, somente leitura, com as regras de linhas de cada pessoa aplicadas dentro da consulta. As tabelas sincronizadas são copiadas para o Querri num agendamento, junto com mais de 125 sistemas de negócio. Nos dois casos, o negócio pode fazer perguntas enquanto os seus engenheiros continuam construindo.
O Querri consulta o Databricks ao vivo?
Sim, para as tabelas que você escolher. Uma tabela Live fica no seu lakehouse: o Querri guarda só as colunas dela e uma estimativa do número de linhas, escreve cada pergunta em Databricks SQL, a executa no seu SQL warehouse como um único SELECT somente leitura e traz de volta só o resultado. As consultas Live usam a computação do seu warehouse; as tabelas sincronizadas são respondidas a partir da cópia do Querri e não usam. As tabelas Live estão disponíveis nos planos Scale.
Posso manter os meus dados no Databricks e ainda usar o Querri?
Sim. Deixe as tabelas como Live e elas ficam no Databricks: o Querri nunca copia as linhas delas, nem nas atualizações agendadas. Escritas, outras tabelas, leituras de arquivos e configurações de sessão são recusadas antes que qualquer coisa chegue ao warehouse, e as regras de linhas de cada pessoa são aplicadas dentro da consulta. Os resultados das perguntas ficam guardados no Querri como qualquer resposta, então gráficos, dashboards, exportações e perguntas de acompanhamento funcionam sobre eles.
As consultas Live usam computação do Databricks?
Sim. As consultas Live rodam no seu SQL warehouse, então aparecem na sua conta do Databricks, e um warehouse parado acrescenta alguns segundos à primeira pergunta; nos nossos testes, um warehouse serverless frio acrescentou cerca de 5 a 10 segundos. Antes de uma atualização agendada, o Querri verifica se a tabela mudou, com uma verificação de metadados que não liga o warehouse, e não executa nada se ela não mudou. Se você prefere que as perguntas não usem computação, sincronize a tabela.
Preciso de um lakehouse para usar IA nos meus dados?
Não para obter respostas de negócio. Um lakehouse é uma base sólida para engenharia, ML e dados muito grandes, e exige engenheiros para construir e operar. O Querri entrega o armazenamento, a limpeza, as definições e as respostas em um só produto, e você pode adicionar um lakehouse depois, se crescer até precisar de um.
Qual é a melhor alternativa ao Databricks para uma equipe sem engenheiros de dados?
Uma que não exija um cluster, um catálogo e tabelas curadas antes da primeira resposta. O Querri conecta os seus sistemas, limpa os dados automaticamente, aprende as suas definições em linguagem simples e cria dashboards quando você pede, com um só plano previsível. Você pode começar pelo plano gratuito.
Posso testar o Querri com os meus próprios dados primeiro?
Sim. Você pode começar pelo plano gratuito, sem cartão de crédito, conectar uma fonte e perguntar. Veja os planos para saber o que cada um inclui. Ou traga a sua pergunta mais difícil para uma demonstração guiada de 20 minutos.
Fontes
De onde vêm estes fatos
Verificado em 15 de outubro de 2026. O Databricks atualiza preços e produtos com frequência; se algo aqui estiver desatualizado, avise-nos e vamos corrigir.
- Best practices for cost optimization Databricks docs
- Manage compute (auto-termination) Databricks docs
- Compute policies Databricks docs
- Account budgets Databricks docs
- Billable usage system table Databricks docs
- Genie budgets Databricks docs
- Genie pricing Databricks
- Genie agents best practices Databricks docs
- Databricks launches Genie One Databricks, Jun 2026
- Import Power BI and Tableau dashboards Databricks docs
- Real-time mode for Structured Streaming is GA Databricks, Mar 2026
- Standard tier retirement on Azure Databricks Microsoft Learn
- Databricks hits $7B run-rate Constellation Research, Aug 2026
- Databricks contract data (median contract) Vendr
- Estimating Databricks annual costs Databricks Community, Aug 2026
- Genie pricing, capabilities and ROI requirements (a Databricks partner) Addepto, Jul 2026
- Databricks FinOps optimization strategies Xebia, Sep 2026
- "Dumped Databricks once the first bill came" Hacker News, Nov 2025
- "A small server in a cupboard" Hacker News, Aug 2025
- Why TPC is not enough: Redshift fleet analysis (Redset) Amazon, VLDB, 2024
- The hunt for big data in the Redshift files MotherDuck, Aug 2024
- Fabric benchmark: Spark versus Python notebooks endjin, Apr 2026
- Why DuckDB DuckDB
- Big Data is Dead MotherDuck (Jordan Tigani), Feb 2023
- Is Big Data Dead? MotherDuck and the small data manifesto DataCamp podcast (Ryan Boyd), Oct 2024
- Querri pricing Querri
- Predictable credit use Querri docs
Continue comparando
Comparações relacionadas
Veja os seus próprios dados respondendo antes de começar um projeto de lakehouse
Conecte um sistema ou envie uma planilha, faça a pergunta que mais importa e veja a consulta por trás da resposta. Se o Databricks for a melhor opção, nós diremos.