Si una IA te dio una cifra que se vino abajo en plena reunión, no eres el único.
Toda respuesta se apoya en decisiones. Querri te dice cuándo tomó una. Revisa tus datos antes de consultar, resuelve la respuesta por dos caminos independientes y deja la consulta detrás de cada cifra abierta para que cualquiera la lea.
En la app
Las comprobaciones, tal como se ven en Querri.
Son capturas de pantalla de Querri con los datos de una empresa de demostración. Las advertencias, la ruta y la consulta aparecen junto a cada número.
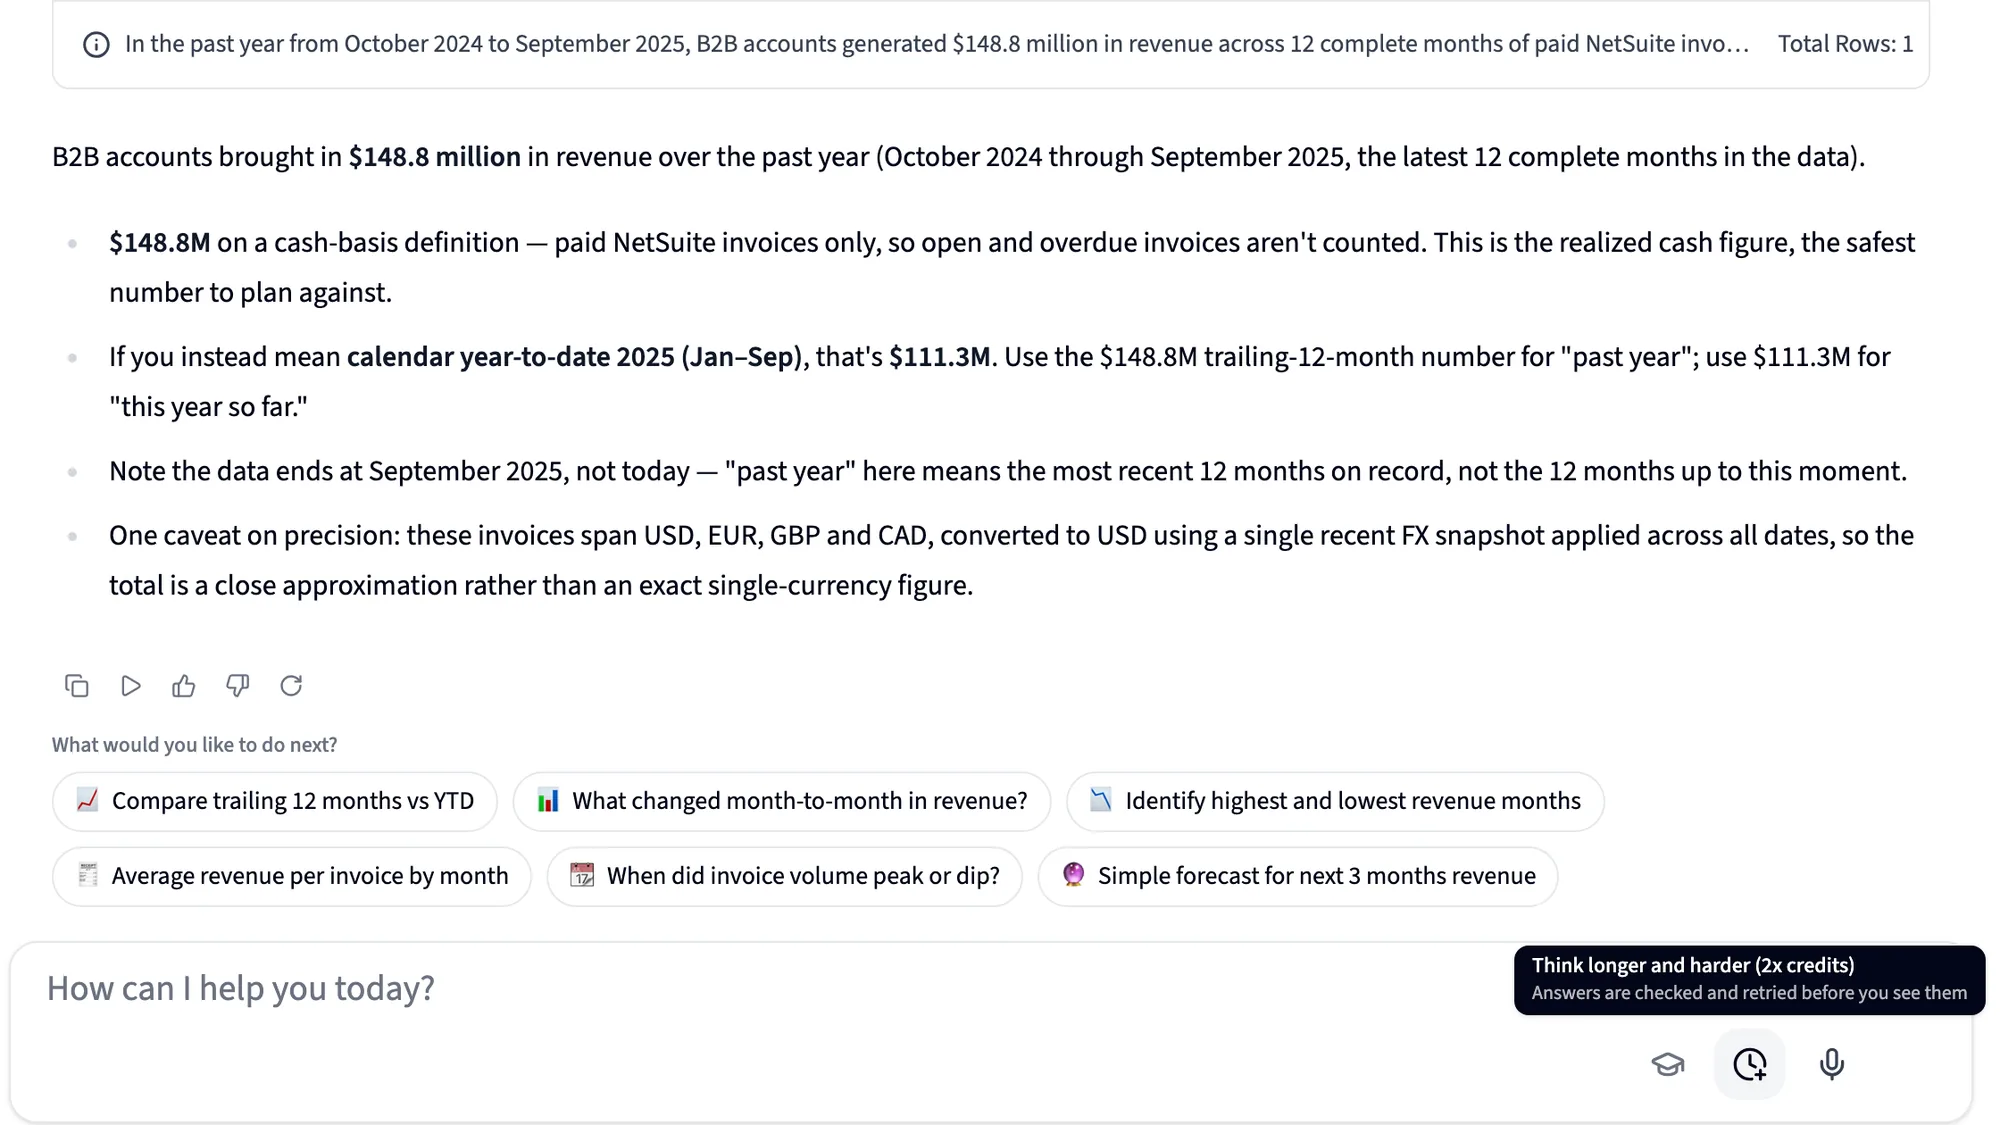
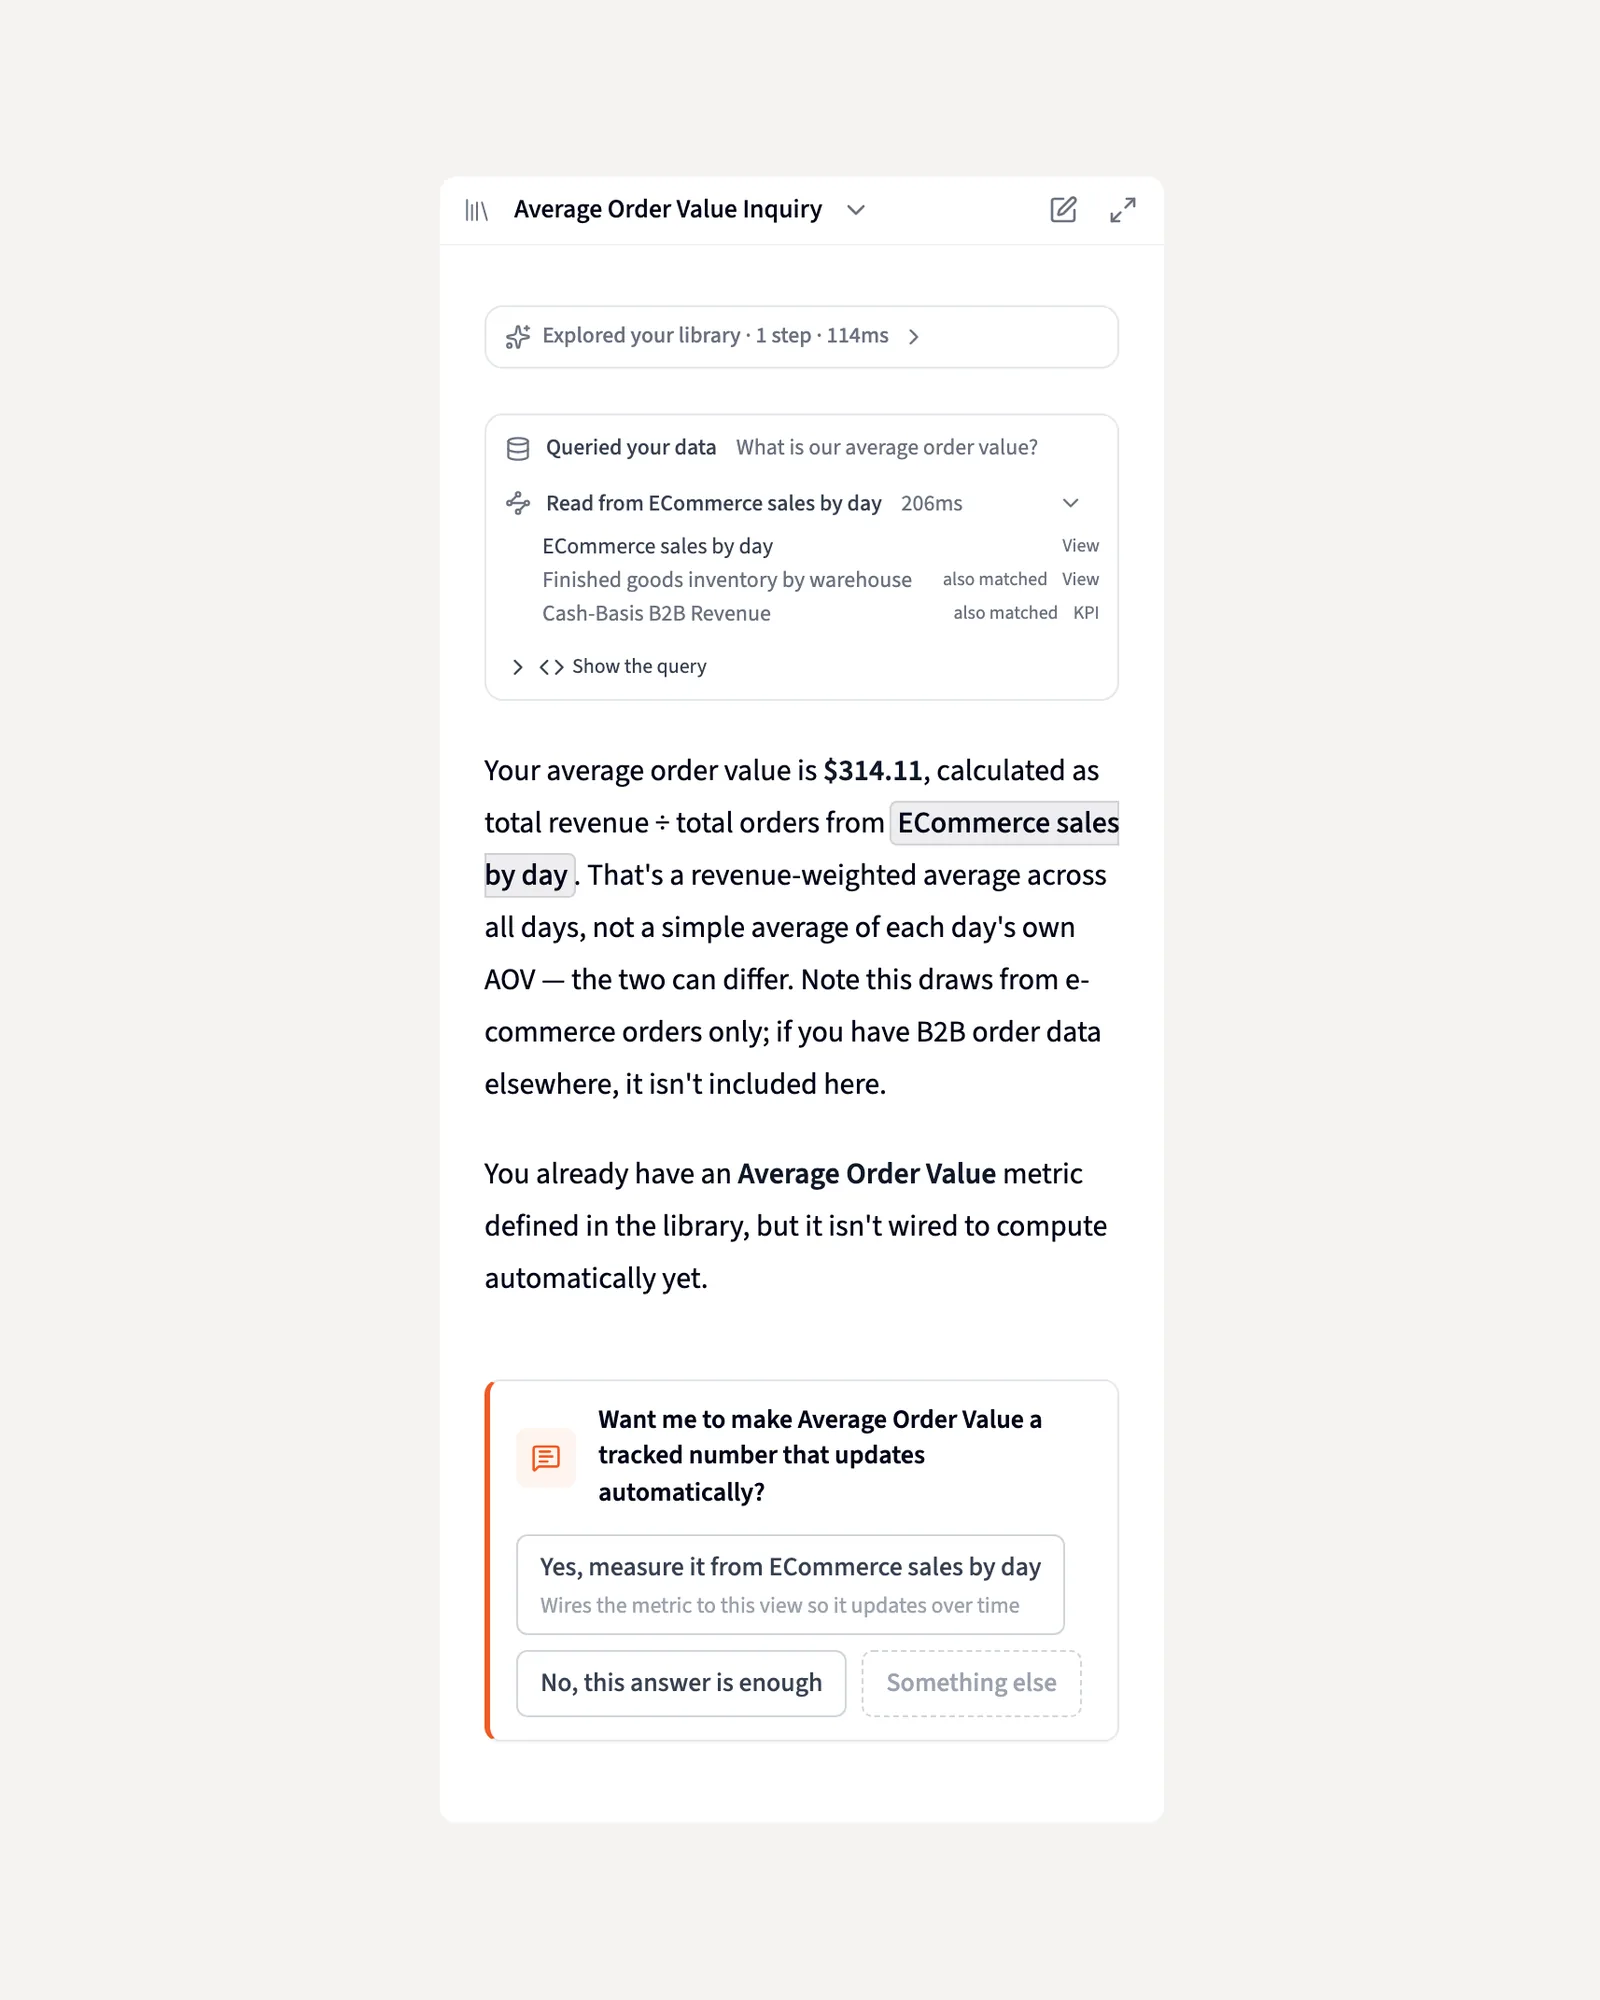
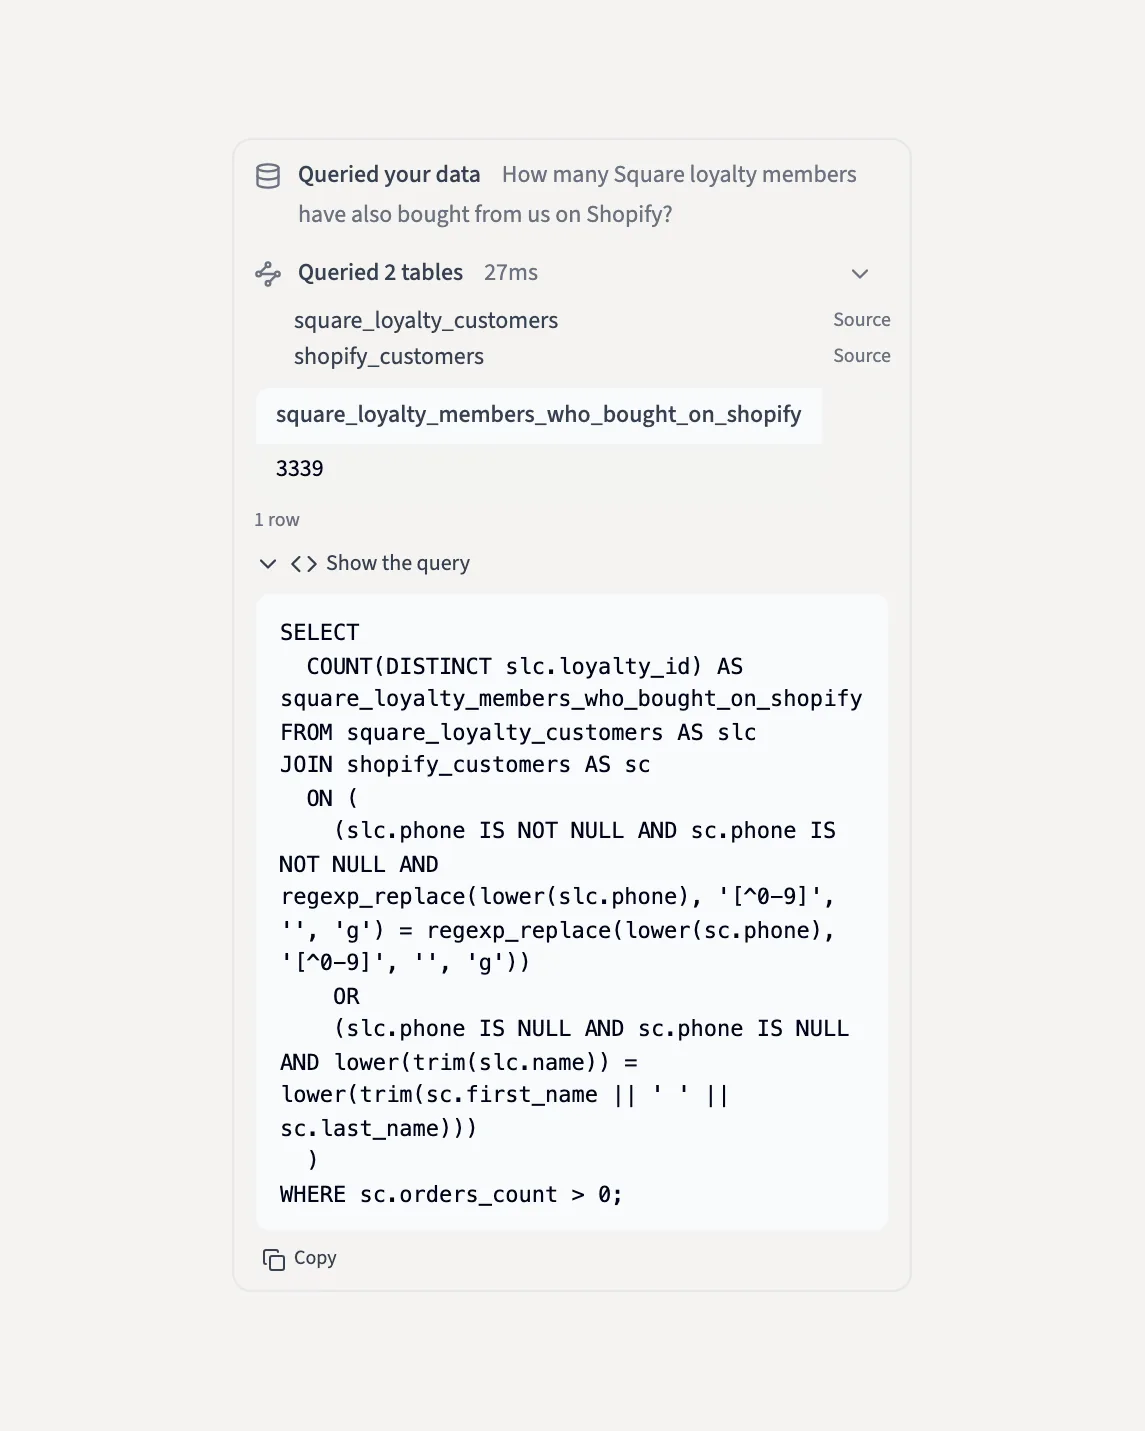
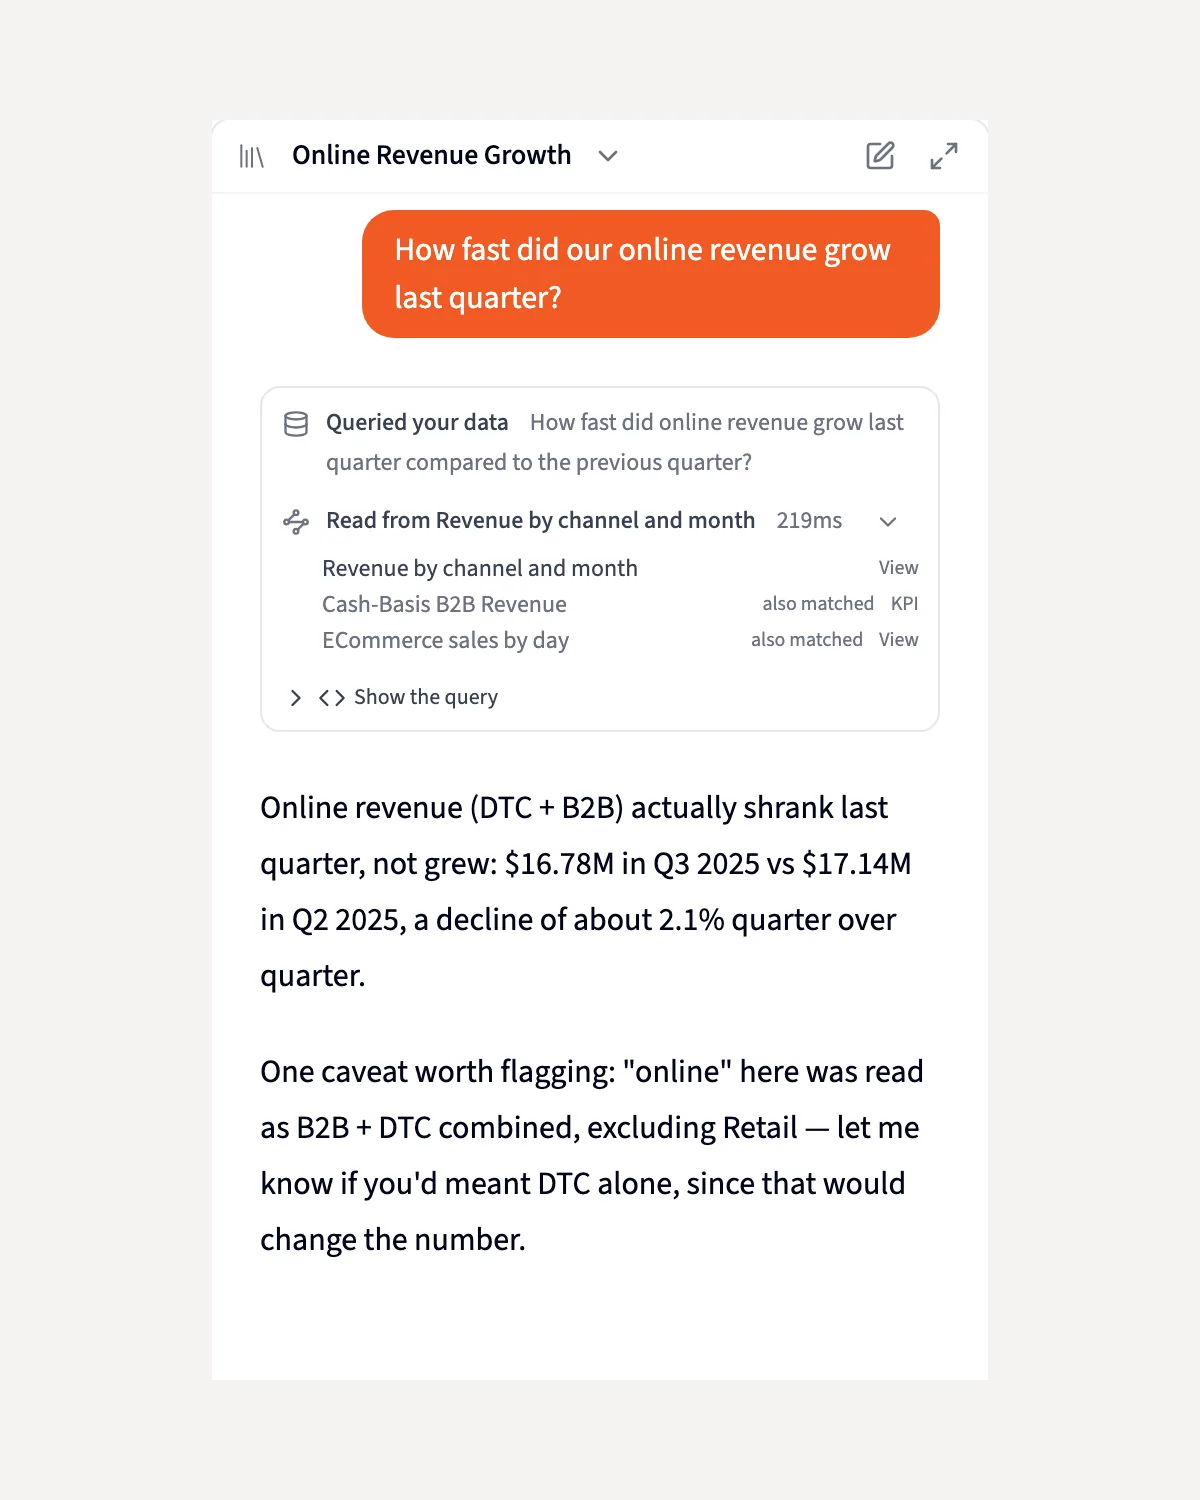
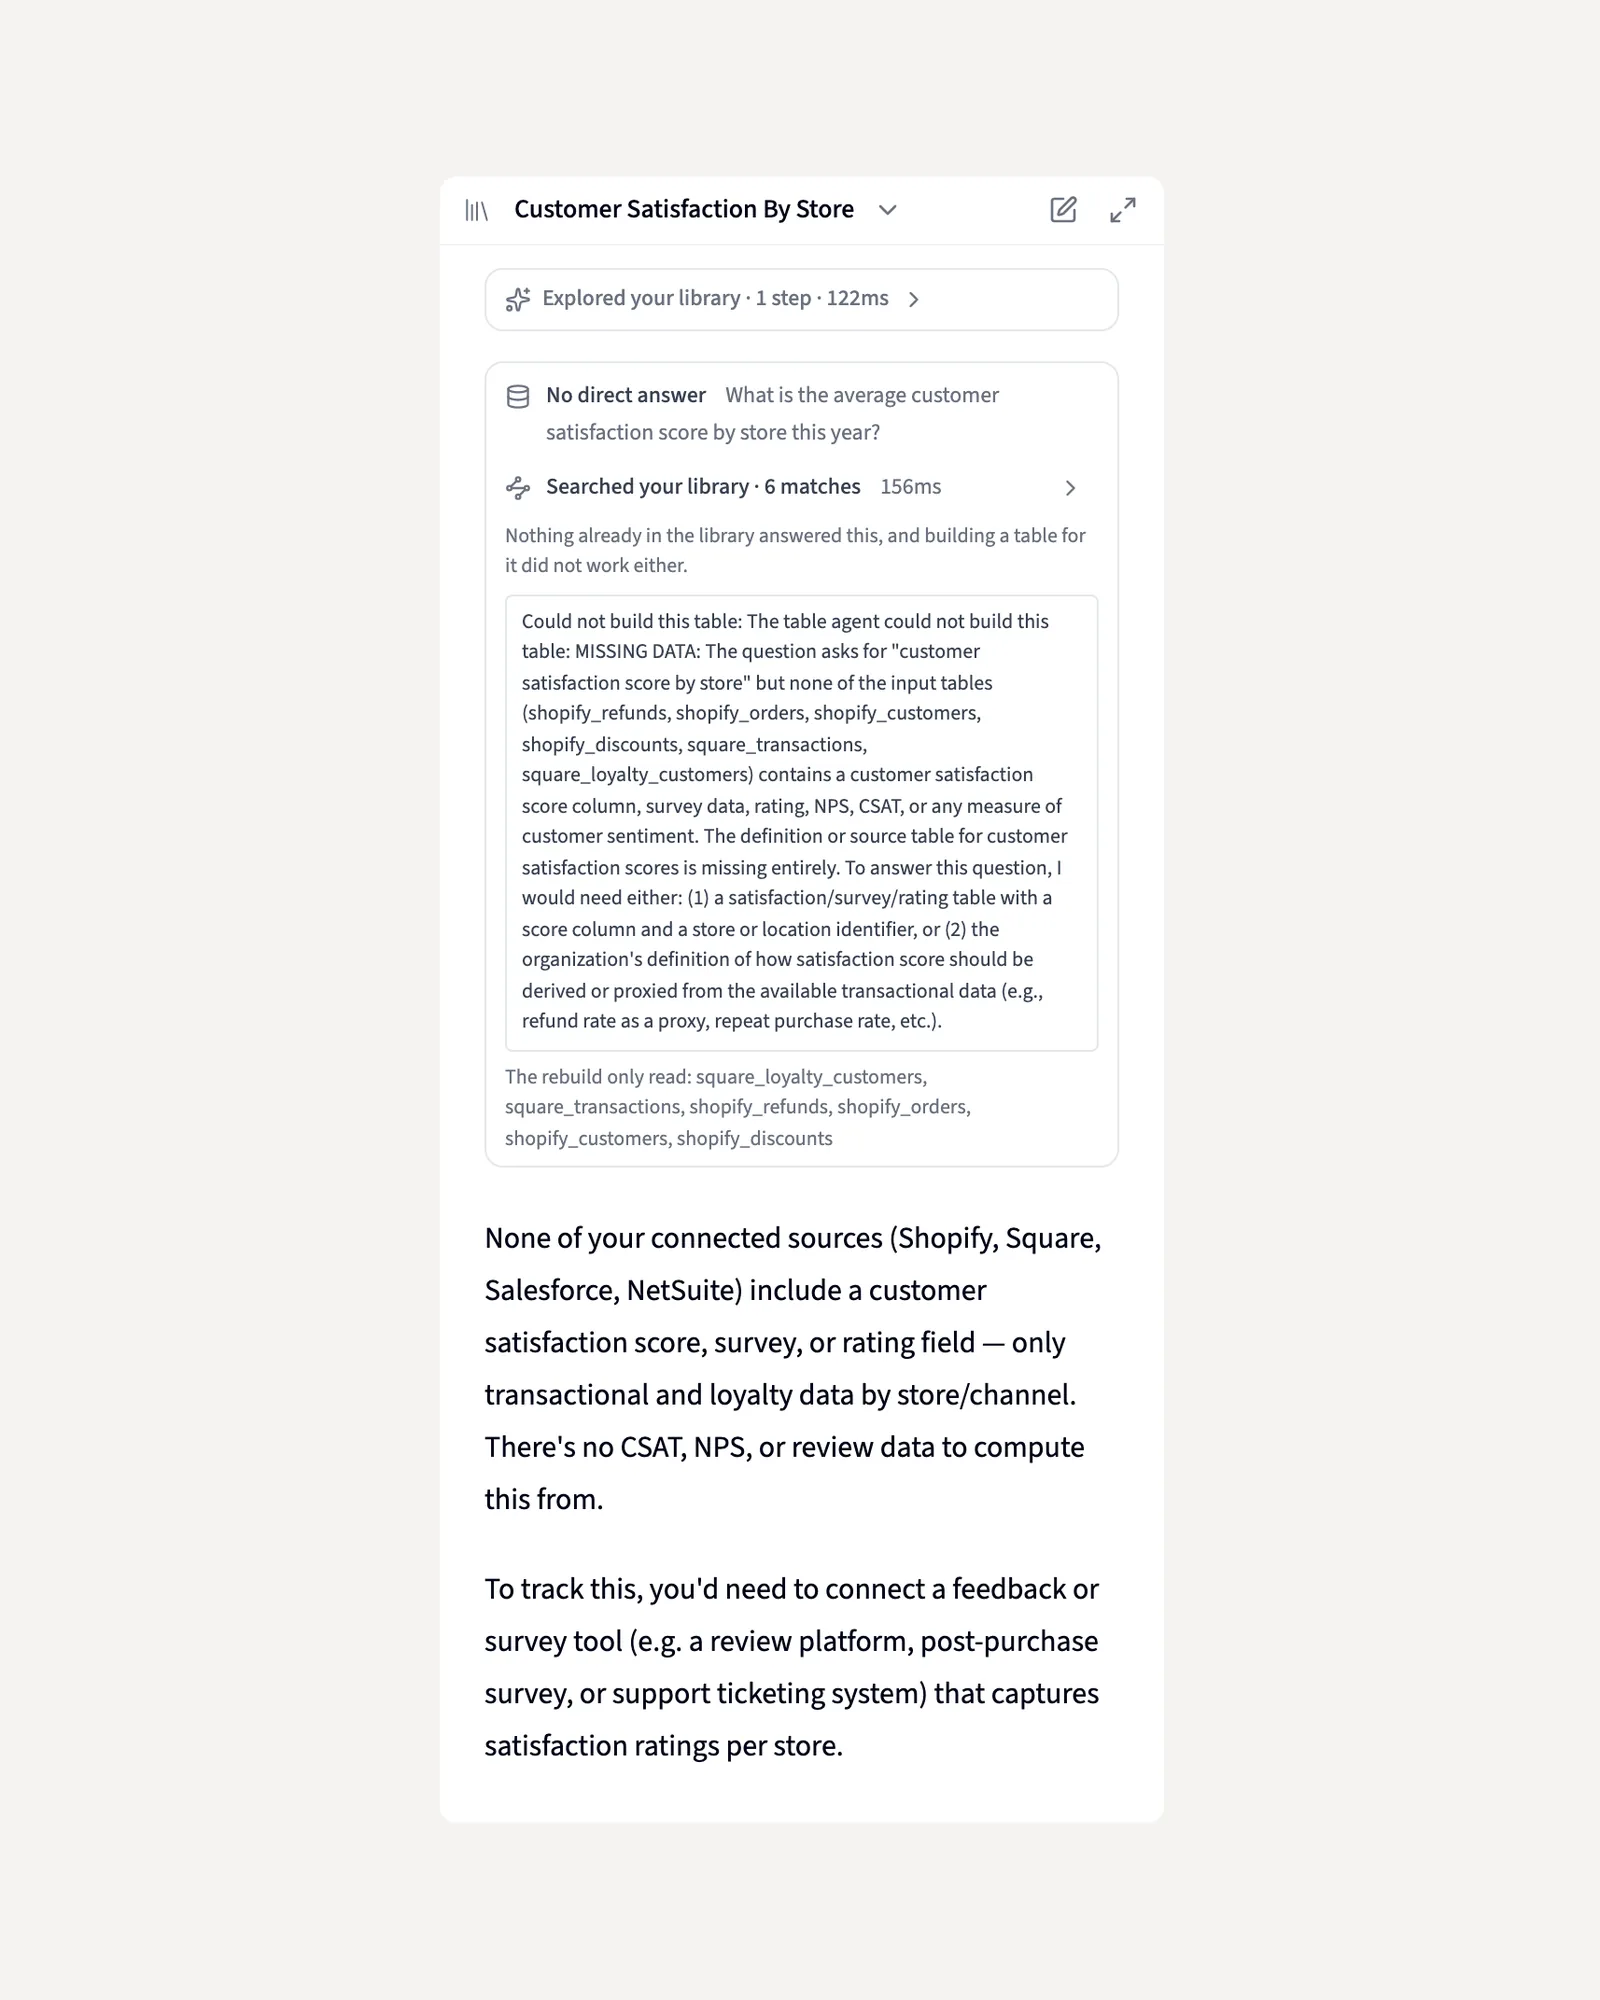
Querri revisa su trabajo, para que tú no tengas que hacerlo.
Revisa tus datos antes del análisis y el resultado después, te dice lo que no pudo resolver y vincula cada cifra con su origen.
Revisa los datos antes de escribir la consulta
Una pasada por las columnas que va a tocar cuenta los IDs duplicados y si se contradicen, el mismo valor escrito de varias formas, el texto que solo parece vacío (“N/A”, “-”) y los valores que no se pueden convertir en número o fecha.
Resuelve la respuesta por un segundo camino
Un camino separado calcula la respuesta con los mismos datos y tus mismas definiciones, sin ver la primera consulta. Los dos resultados se comparan fila por fila, y te enteras cuando no coinciden.
Te dice cuánto movió la cifra una limpieza
Quita los pedidos cancelados y el total cambia. Querri te dice cuánto, así que una limpieza que nadie pidió aparece como advertencia en lugar de cambiar la respuesta en silencio.
Lo dice cuando no pudo revisar algo
Si una revisión no se ejecutó, la respuesta lo dice con claridad. El silencio nunca pasa por datos limpios.
Cuando una pregunta tiene dos respuestas razonables, recibes las dos cifras.
“Entregas diarias promedio” puede significar por día trabajado o por día natural. Querri indica la lectura que usó, calcula la otra y te dice para qué sirve cada una.
En las preguntas del benchmark con más de una respuesta defendible, Querri señaló la otra lectura razonable el 73% de las veces, frente al 12% de un agente de IA de propósito general líder.
Haz tu pregunta. El Bibliotecario sabe dónde está la respuesta.
El Bibliotecario lee primero de una vista guardada o un KPI que claramente responde a la pregunta, y solo después escribe SQL sobre tus tablas de origen. Es el código, no el prompt, el que decide si una vista sirve, así que prefiere declinar antes que adivinar.
- Cada respuesta muestra su ruta: Read from, Queried o Searched your library.
- Show the query abre el SQL, con un botón Copy para la persona técnica del equipo.
- Cuando nada encaja, la respuesta dice No direct answer, sin inventar ninguna cifra.
- Las respuestas solo incluyen datos que la persona que pregunta tiene permiso para ver.
La cifra acordada, con la consulta detrás
Cuando todo el equipo espera a la única persona que sabe dónde están los datos, el Bibliotecario recibe las preguntas y responde con la cifra que tu empresa ya acordó.
Tu empresa no debería tener que resolver dos veces el mismo problema de datos.
Cuando alguien hace una pregunta que el equipo ya respondió, el Bibliotecario la lee de la vista guardada que le corresponde, así que vuelve en segundos y siempre desde el mismo lugar. Y un informe programado no puede darte en silencio otra cifra el mes que viene: al volver a ejecutarlo se repite el código de la primera vez, sin volver a consultar a ningún modelo.
En una pregunta que la empresa ya había respondido, reutilizar la respuesta guardada fue 4,6× más rápido que un agente de IA de propósito general líder, con 2,8× menos tokens y un costo 6,1× menor.
Una pregunta nueva se resuelve desde cero, con las mismas definiciones. Los pasos que usan un modelo a propósito (Researcher, Categorize y las presentaciones Wrapped) lo vuelven a llamar en cada ejecución.
¿No habíamos respondido esto ya?
Sí, y ahora vuelve en segundos. La fila de ruta dice de dónde salió la cifra, y la consulta está a un clic.
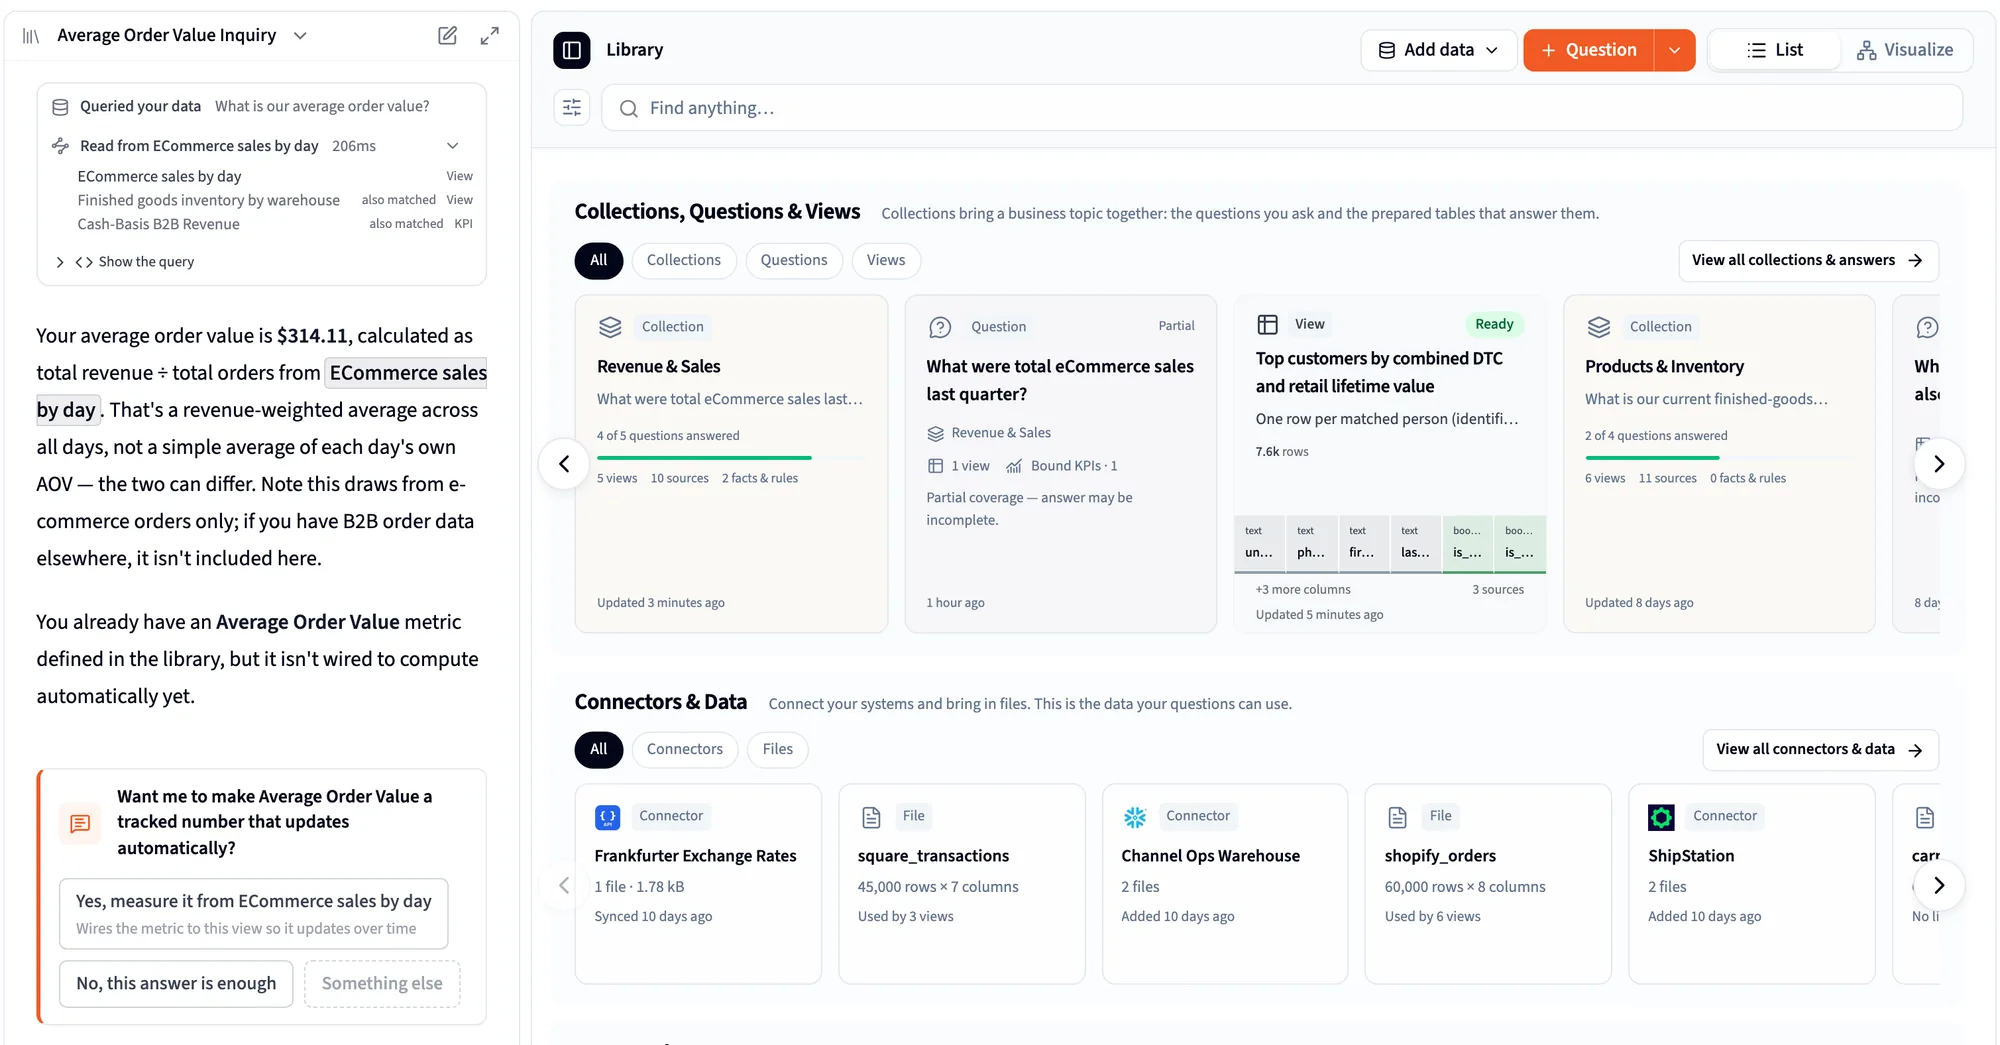
Tú decides cuándo una respuesta pasa la revisión completa.
El modo exhaustivo, el predeterminado, revisa cada tabla que construye con una segunda pasada, la contrasta con un cálculo independiente y reintenta la tabla que falla. El modo rápido es una sola pasada con el mismo contexto y sin nada de esa revisión, y su etiqueta lo indica. Lo eliges en cada mensaje.
Revisa su trabajo como lo haría un analista cuidadoso.
Primero mira los datos
Antes de consultar, Querri mide las columnas que toca la pregunta, con el mismo filtro de filas con el que se ejecutará la consulta.
Lo resuelve por dos caminos
Dos caminos, ambos a partir de tus propias definiciones y reglas, calculan la respuesta por separado y se comparan fila por fila.
Revisa el resumen y conserva la consulta
Cada cifra del resumen escrito se comprueba contra el resultado, y la consulta que hay detrás queda abierta para que cualquiera la lea.
TI pone las reglas. Quienes conocen los datos definen su significado. Los demás solo preguntan.
Consumidor de datos
Entra a la reunión sabiendo que tu cifra va a aguantar. Si una pregunta tiene dos lecturas razonables, Querri te lo dice antes que nadie, y si los datos no pueden responder, lo dice en lugar de adivinar.
Responsable de los datos
Deja de ser el verificador humano de cada respuesta de IA. Querri revisa los datos en busca de huecos y duplicados, resuelve la respuesta por dos caminos y muestra la consulta, así que verificar una cifra lleva un minuto, no una tarde.
Equipo de datos y TI
IA que puedes auditar. El modelo escribe código, el código se ejecuta dentro de Querri aplicando primero las reglas de acceso, y cada cifra se vincula con su consulta y su origen. Un informe guardado se repite exactamente igual.
Lo que la gente pregunta
¿Todas las respuestas pasan la revisión completa?
Todas las tablas que Querri construye la pasan en modo exhaustivo, que es el predeterminado. Los pronósticos y otros pasos en Python reciben la comprobación de cifras en su resumen y muestran su código. Si eliges el modo rápido para una lectura veloz, la etiqueta te indica que se omitió la revisión.
¿Qué pasa cuando mis datos no pueden responder la pregunta?
Querri lo dice en lugar de estimar. En la Biblioteca, la respuesta del Bibliotecario dice No direct answer, sin ninguna cifra inventada. En un proyecto, Querri prueba las demás fuentes que coincidían con la pregunta antes de decir que faltan datos, y nombra las que probó.
¿Un informe guardado me dará otra cifra el mes que viene?
No por sí solo. Volver a ejecutar una vista guardada, un proyecto, la actualización de un dashboard o un informe programado repite el código de la primera vez. Una pregunta nueva se resuelve desde cero, con las mismas definiciones. Los pasos que usan un modelo a propósito, como Researcher, Categorize y las presentaciones Wrapped, lo vuelven a llamar en cada ejecución.
¿La IA hace las cuentas?
No. La IA escribe SQL y Python que se ejecutan sobre tus datos, y los gráficos se dibujan a partir de esos resultados. Por eso cada cifra puede mostrar la consulta que hay detrás.
¿Tantas advertencias no harán que la gente confíe menos en la respuesta?
La respuesta va primero y las advertencias debajo. Una tabla limpia que pasó la revisión no muestra ningún aviso. Una advertencia solo aparece cuando hay algo cierto que decir, y eso es justo lo que querrías saber antes de la reunión.
¿Qué tan preciso es?
Medido contra los datos de origen, Querri acertó el 97% de las preguntas ambiguas del benchmark, frente al 80% de un agente de IA de propósito general líder.
¿Quién puede ver una respuesta? ¿Se usan mis datos para entrenar un modelo?
Las respuestas solo incluyen datos que la persona que pregunta tiene permiso para ver, porque las reglas de acceso se aplican antes de ejecutar cualquier consulta. Tus datos nunca entrenan un modelo. Querri cuenta con las certificaciones SOC 2 Type II, HIPAA e ISO 27001:2022.
Relacionado
Haz la pregunta en la que tropezó tu última IA.
Trae tu pregunta más difícil a una demostración guiada y mira cómo Querri llega a una respuesta, paso a paso.