Querri vs Databricks
Databricks ist ein Lakehouse, das Sie bauen. Querri ist die Antwort, wegen der Sie gekommen sind.
Dasselbe Ziel: verlässliche Antworten. Sehr unterschiedliche Projekte.
Databricks ist eine der leistungsfähigsten Datenplattformen der Welt, gebaut für Engineering-Teams: ein Lakehouse, Pipelines, ein Katalog, kuratierte Tabellen, zwei Rechnungen und die Leute, die alles betreiben. Querri ist die Datenplattform, die bei Ihren Fragen ansetzt. Sie beginnt bei den Fragen, die Ihr Unternehmen stellt, und baut auf, was nötig ist, um sie zu beantworten, in einem Produkt, mit einer planbaren Rechnung. Sie nutzen Databricks bereits? Lassen Sie die Tabellen im Lakehouse und Querri sie direkt abfragen.
Zeit, Kosten und Kontrolle
Antworten in diesem Quartal, eine planbare Rechnung und kein neues Team, das Sie einstellen müssen
Databricks ist eine Plattform, auf der Engineering-Teams aufbauen. Querri ist der fertige Weg von Ihren Systemen zu einer Antwort. Das bedeutet dieser Unterschied für das Geschäft.
-
Antworten in Tagen, nicht in Quartalen
Ein Lakehouse-Projekt läuft Wochen bis Monate, bevor das Geschäft eine verlässliche Antwort erhält. Mit Querri verbinden Sie ein System oder laden eine Datei hoch und fragen noch am selben Tag.
-
Eine planbare Rechnung, ohne Überraschungen
Databricks rechnet DBUs plus die Maschinen Ihres Cloud-Anbieters ab: zwei Rechnungen, die sich mit der Nutzung ändern. Bei Querri gibt es eine planbare Rechnung: ein monatliches Credit-Kontingent, das sich an der Arbeit Ihres Teams orientiert, Warnungen, bevor Sie es erreichen, und keine automatischen Mehrverbrauchsgebühren.
-
Kein Datenteam nötig
Databricks braucht Engineers, die die Tabellen aufbauen, und einen Analysten, der Genie genau hält. In Querri legen die Menschen, die das Geschäft bereits kennen, in einfacher Sprache fest, was die Zahlen bedeuten.
-
Sicher, prüfbar, nichts auszutauschen
SOC 2 Type II, HIPAA und ISO 27001:2022, und Ihre Daten trainieren nie ein Modell. Jede Zahl zeigt ihre Abfrage, und wenn Sie Databricks bereits nutzen, setzt Querri direkt darauf auf, live oder synchronisiert, ohne dass Daten umziehen müssen.
Wofür sich welches eignet
Wählen Sie nach Ihrem Team und Ihrem Zeitplan
Uns ist lieber, Sie wählen das richtige Tool, als dass Sie uns aus dem falschen Grund wählen. Hier sehen Sie, wo welches passt.
Wählen Sie Databricks, wenn
- Sie Data Engineers haben, die Spark-Pipelines, Delta-Tabellen und Unity Catalog aufbauen und betreiben und Genie kuratiert halten.
- Ihre Daten viele Terabyte oder Petabyte umfassen oder Sie Spark für aufwendige Transformationen brauchen.
- Sie Machine-Learning-Modelle trainieren und bereitstellen oder Echtzeit-Streaming mit Latenzen unter einer Sekunde brauchen.
- Sie eine Plattform für Data Engineering, Data Science und KI-Anwendungen wollen, gesteuert in einem Katalog.
- Jemand die Verantwortung für die Rechnung übernimmt: Compute-Richtlinien, automatische Beendigung, Tagging, Budgets und die Cloud-Rechnung.
Wählen Sie Querri, wenn
- Sie geschäftliche Antworten in Tagen wollen, nicht erst nach einem Lakehouse-Projekt, oder Databricks bereits nutzen und das Geschäft es direkt fragen lassen wollen.
- Ihre Daten in Geschäftssystemen liegen (CRM, Buchhaltung, ERP, Zahlungen, Tabellenkalkulationen) und auf eine schnelle Maschine passen.
- Die Menschen, die wissen, was die Zahlen bedeuten, keine Entwickler sind und dafür keine Metric Views schreiben sollten.
- Sie eine planbare Rechnung wollen, statt DBUs plus einer Cloud-Rechnung, die getrennt eintreffen.
- Sie Dashboards, Berichte, einen KI-Agenten, Datenbereinigung und MCP für Claude und ChatGPT eingebaut wollen, nicht zusammengestückelt.
Funktion für Funktion
Der detaillierte Vergleich
Jede Zeile zeigt, wo welches stärker ist. Wo Databricks gewinnt, sagen wir es. Die Fakten sind auf dem Stand von Oktober 2026 und in den Quellen verlinkt.
Die Listenpreise von Databricks variieren je nach Cloud, Region, Tarifstufe und Vertrag, und Databricks veröffentlicht keine einheitliche Preisliste; DBU-Zahlen sind Schätzungen von Dritten für AWS in den USA. Produktfakten stammen aus der Dokumentation von Databricks, Stand 15. Oktober 2026.
Preise
Verbrauchsbasierte Preise belohnen ein Team, das sie im Blick behält
Nur für das zu zahlen, was Sie nutzen, ist ein echter Vorteil, wenn jemand es steuert. Databricks fügt einen zweiten Zähler hinzu: die DBUs auf der Rechnung von Databricks und die Maschinen auf Ihrer Cloud-Rechnung. Ohne jemanden, der beide im Blick behält, folgen die Kosten jedem Cluster, der weiterläuft, und jeder Frage, die ein Agent beantwortet, und die Abrechnungsdaten kommen Stunden später.
So rechnet Databricks ab
- Zwei Rechnungen. DBUs an Databricks, je nach Workload-Typ, plus die virtuellen Maschinen und der Speicher in Ihrem Cloud-Konto. Bei Serverless stecken die Maschinen in einem höheren DBU-Satz.
- Die Sätze unterscheiden sich je nach Workload: etwa $0.15 pro DBU für Jobs bis $0.70 für Serverless SQL (US-Zahlen von Dritten). Jobs auf All-Purpose-Compute laufen zu lassen, kostet „deutlich“ mehr.
- Cluster im Leerlauf kosten weiter bis zur automatischen Beendigung, die zwischen 10 und 10,000 Minuten liegt oder nie greift, wenn sie auf 0 steht.
- Genie enthält ein kostenloses monatliches Kontingent für die Modellnutzung; darüber hinaus wird Genie seit dem 8. Juli 2026 in DBUs abgerechnet, und das SQL-Warehouse dahinter wird separat berechnet.
- Budgets warnen per E-Mail. Genie-Budgets sind „keine absolute Ausgabenobergrenze“, und laufende Anfragen „werden nicht unterbrochen.“
- Abrechnungsdaten kommen „in der Regel innerhalb von 12 Stunden“ an, sodass ein außer Kontrolle geratener Job erst sichtbar wird, wenn das Geld schon ausgegeben ist.
Wann verbrauchsbasierte Preise das bessere Angebot sind
Wenn Sie ein Plattformteam haben, das Jobs auf Job-Compute laufen lässt, Compute-Richtlinien und automatische Beendigung festlegt, vom ersten Tag an alles taggt und die Abrechnungs-Systemtabellen prüft, kann Databricks im großen Maßstab sehr kosteneffizient sein, und die eingesparte Engineering-Zeit kann die Rechnung aufwiegen. Wenn das Ihr Team ist, sind die Leitfäden unten der richtige Einstieg.
Was passiert, wenn niemand hinschaut
Sie wählen Databricks? Halten Sie beide Zähler im Griff.
Wenn Databricks die richtige Wahl für Sie ist, halten diese Kontrollen die Rechnung planbar. Die meisten stammen aus der Dokumentation von Databricks selbst.
- Best Practices zur Kostenoptimierung Job-Compute statt All-Purpose, richtige Dimensionierung und Tagging vom ersten Tag an. Databricks docs
- Compute-Richtlinien festlegen DBUs pro Stunde und die Cluster begrenzen, die jede Person erstellen kann. Databricks docs
- Automatische Beendigung konfigurieren Compute im Leerlauf kostet, bis es stoppt. Halten Sie das Timeout kurz. Databricks docs
- Budgets anlegen E-Mail-Warnungen, wenn die monatlichen Ausgaben einen Schwellenwert überschreiten. Databricks docs
- Die Abrechnungs-Systemtabellen beobachten Nutzung nach Workload, Nutzer und Tag sehen, etwa 12 Stunden verzögert. Databricks docs
- Databricks FinOps in der Praxis Der Praxisleitfaden von Xebia, mit echten Einsparungen bei ungenutztem und überdimensioniertem Compute. Xebia
So hält Querri die Rechnung planbar
- Eine Rechnung, keine Überraschungen. Ein Plan für die ganze Organisation, mit KI, Speicher und unbegrenzten Dashboard-Betrachtern inklusive. Pläne und Preise ansehen.
- Ein einfacher Credit. Ein Credit ist eine Einheit geschäftlicher Arbeit, etwa eine beantwortete Frage oder die Synchronisierung einer Quelle, sodass die Nutzung leicht zu verstehen und leicht zu planen ist.
- Eine Rechnung. Speicher, Compute und KI sind im Plan enthalten. Dahinter steht keine Cloud-Rechnung.
- Nutzungswarnungen bei 80% des Plans, bei Überschreitung und bei sprunghaftem Anstieg, plus ein monatliches Limit für jede Person.
- Keine automatischen Mehrverbrauchsgebühren. Wir sagen Ihnen Bescheid, wenn Sie sich Ihrem Limit nähern, und Sie entscheiden, wie es weitergeht.
- Unbegrenzte Dashboard-Betrachter in jedem Plan. Ansehen, Uploads, Exporte und die Bibliothek kosten nie Credits.
Gesamtkosten
Was es braucht, bis die erste Antwort kommt
Mit einem Lakehouse fängt die Arbeit erst an. Bevor ein Fachanwender von Genie eine verlässliche Antwort erhält, baut jemand die Tabellen, den Katalog und die Metric Views dahinter. Hier ist der typische Databricks-Weg neben Querri.
Der Databricks-Weg ist unsere Schätzung auf Basis von Vertragsdaten von Vendr, einem Kostenmodell aus der Databricks Community und Gehaltsspannen aus den verlinkten Quellen, kein Angebot. Eine kleine, sorgfältige Bereitstellung kostet weniger; wenn Sie das Team schon haben, ist der Personalposten eine Ausgabe, für die Sie sich bereits entschieden haben.
Architektur
Spark für die größten Datenmengen. DuckDB für die Daten, die Sie tatsächlich haben.
Das ist der eigentliche architektonische Unterschied, und er erklärt einen Großteil der Kostenlücke. Databricks hat seine Plattform auf Apache Spark aufgebaut, das Arbeit auf einen Cluster von Maschinen verteilt. Querri nutzt DuckDB, eine In-Process-Analytics-Engine, die auf einer einzelnen Maschine extrem schnell ist, auf offenen Parquet- und Iceberg-Dateien.
Databricks
Verteiltes Spark, auf Clustern, die Sie bezahlen, solange sie laufen
- Spark und die Photon-Engine skalieren über viele Maschinen. Für viele Terabyte, Streaming und ML ist nichts besser.
- Cluster berechnen DBUs und Cloud-Maschinen, solange sie laufen, einschließlich der Leerlaufzeit bis zur automatischen Beendigung, die sich auf bis zu 10,000 Minuten setzen oder ganz abschalten lässt.
- Ein Cluster braucht Minuten zum Starten; Serverless startet schneller, zu einem höheren DBU-Satz.
- Offene Delta- und Iceberg-Tabellen in Ihrem eigenen Cloud-Speicher.
Querri
DuckDB auf offenen Dateien, ausgelegt für Geschäftsdaten
- Die Daten jeder Organisation werden als Parquet in Apache-Iceberg-Tabellen gespeichert, in ihrem eigenen Speicher.
- DuckDB fragt sie in-process ab: kein Cluster, den Sie starten, dimensionieren, warmhalten oder im Leerlauf bezahlen müssen.
- Python kommt dazu, wo ein Dataframe SQL schlägt.
- Durchgehend offene Formate, sodass nichts an Ihren Daten in einer proprietären Engine festsitzt.
Wo welche Engine das richtige Tool ist
Warum sich die Architektur auf der Rechnung zeigt
Ein Spark-Cluster rechnet die Maschinen ab, die laufen, nicht die Arbeit, die sie leisten, und zahlt Start- und Koordinationskosten, um selbst einen kleinen Job aufzuteilen. In einem öffentlichen Benchmark mit derselben 5-GB-Workload verbrauchte DuckDB auf einem einzelnen Knoten etwa ein Fünftel des Computes, das Spark brauchte. Querri baut auf dieser Architektur auf, mit Konnektoren, Bereinigung, Definitionen, Dashboards und KI bereits obendrauf, in einem Plan mit planbaren Kosten.
Eingebaut, nicht zusammengesetzt
Alles zwischen Ihren Daten und der Antwort, in einem Produkt
Auf dem Lakehouse-Weg sind das separate Bausteine, die Sie bauen, verbinden und kuratiert halten müssen. In Querri sind sie eine Kette: Neue Daten bauen die Ansichten darauf neu auf, KPIs werden neu berechnet und jede Dashboard-Aktualisierung spielt ihre gespeicherte Abfrage erneut ab, sodass sich jede Zahl bis zu ihrer Quelle zurückverfolgen lässt.
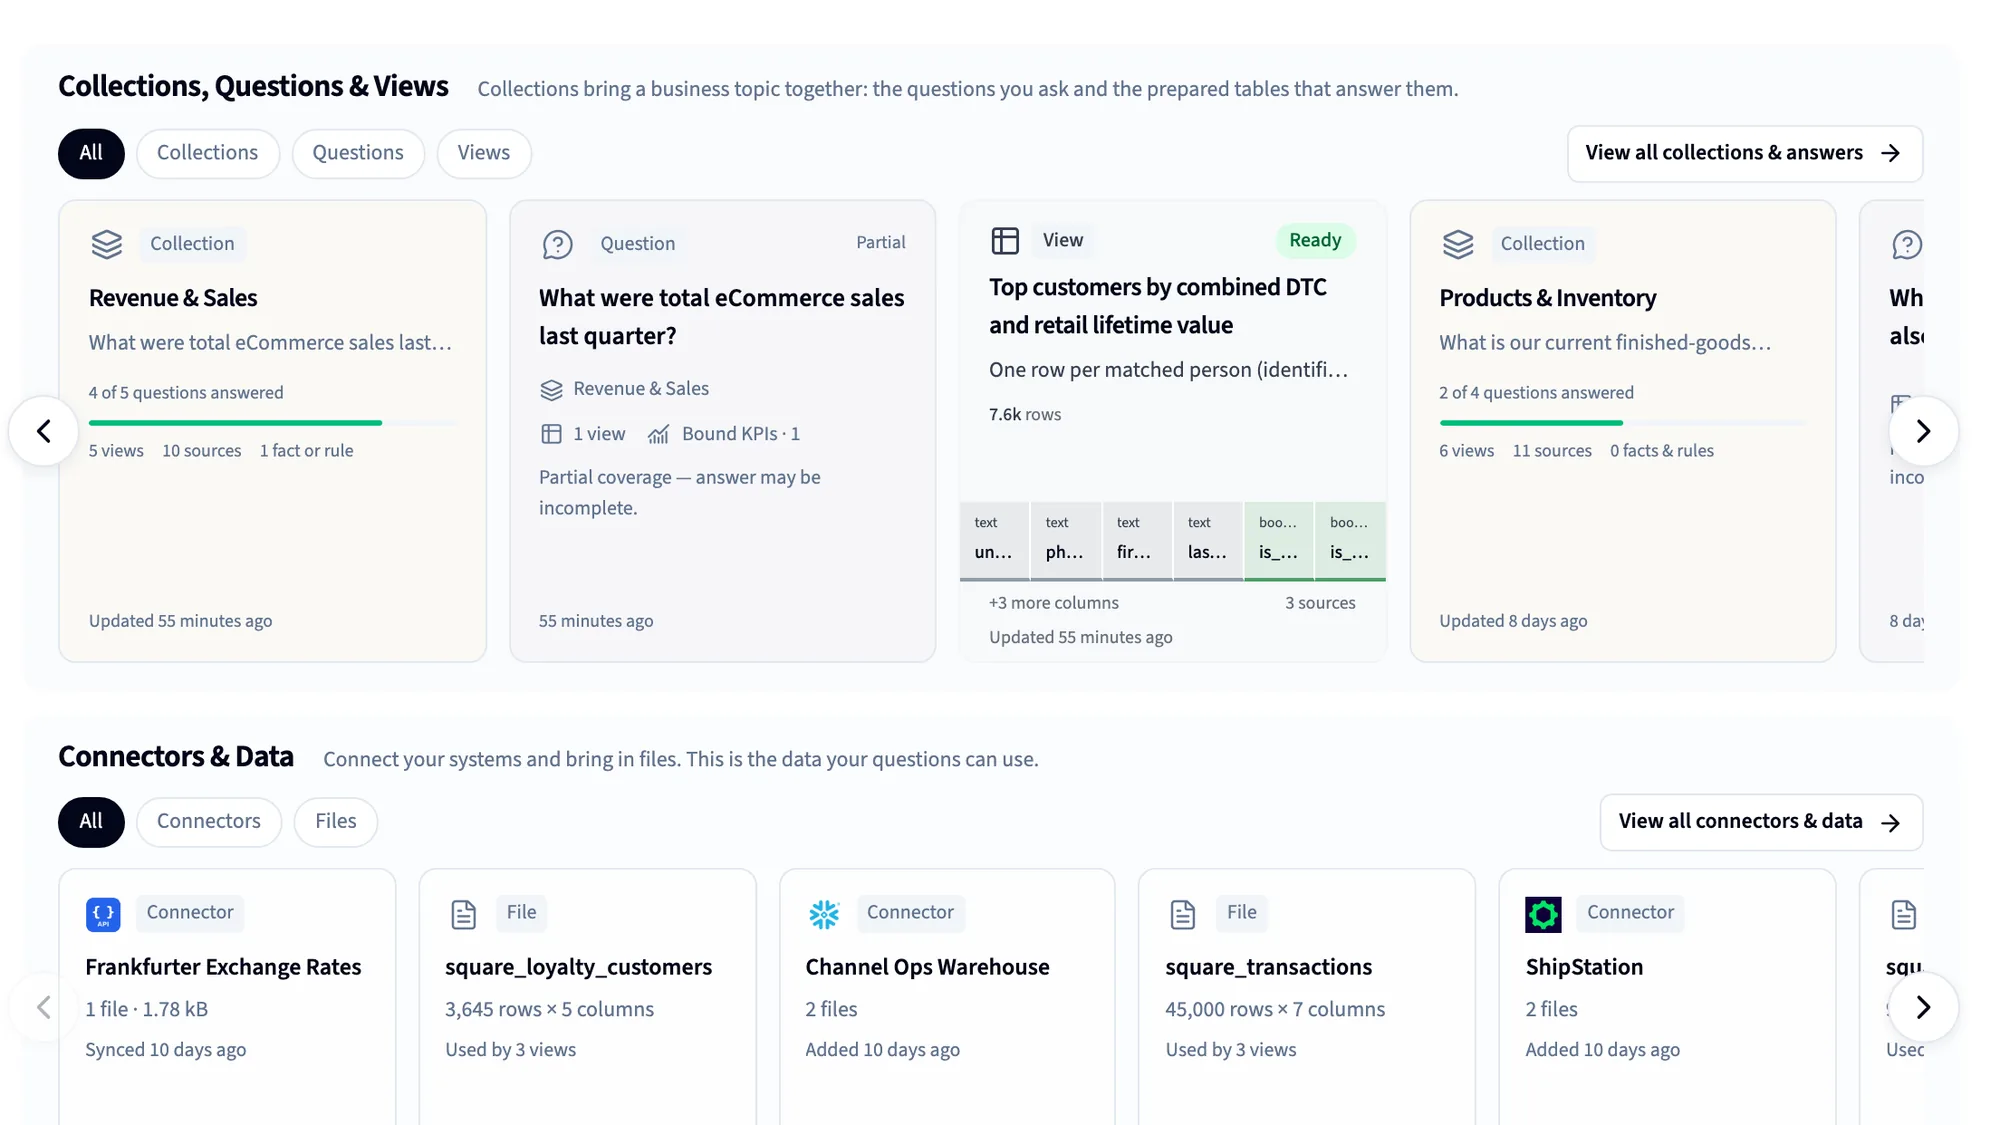
125+ Konnektoren
CRM, Buchhaltung, ERP, Zahlungen, Werbung und Datenbanken, dazu Tabellenkalkulationen und Dateien.
Automatische Datenbereinigung
Mehr als 180 Prüfungen an jeder Tabelle und der Janitor, der behebt, was sie finden.
Die Bibliothek
Eine semantische Schicht, die vom Geschäft ausgeht: Definitionen, KPIs und Regeln, beigebracht, indem Sie sie aussprechen.
Dashboards
Per Frage oder aus einem Screenshot erstellt, geteilt mit unbegrenzten Betrachtern.
Nächtliche Insights und Monitore
Querri arbeitet sich über Nacht durch Ihre Daten und zeigt, was sich geändert hat.
MCP für Claude und ChatGPT
Jeder Assistent antwortet aus denselben Definitionen, mit den Zugriffsrechten der jeweiligen Person.
Berichte und Excel
Geplante Projekte, formatierte Arbeitsmappen und Präsentationen, für Sie zugestellt.
White Label und Einbettung
Bringen Sie dasselbe Verständnis in Ihr eigenes Produkt, unter Ihrer Marke.
Beides nutzen
Wie Databricks und Querri zusammenarbeiten
Viele Teams werden beides betreiben, und das ist ein gutes Setup. Behalten Sie Databricks für Engineering, Machine Learning und die größten Datenmengen, und machen Sie Querri zu dem Ort, an dem das Geschäft fragt. Querri kann direkt auf Databricks aufsetzen: Lassen Sie die Tabellen im Lakehouse und fragen Sie sie live ab, oder synchronisieren Sie diejenigen, die Querri lieber selbst halten soll, neben den Systemen, die es nie ins Lakehouse geschafft haben.
In Databricks behalten
- Spark-Pipelines und sehr große Datenmengen
- Machine Learning, Modelltraining und -bereitstellung
- Echtzeit-Streaming
- Pipelines, die andere Systeme speisen
In Querri erledigen
- Geschäftsfragen über alle Systeme hinweg
- Definitionen, die dem Geschäft gehören, in Klartext
- Dashboards für alle, mit unbegrenzt vielen Betrachtern
- KI-Antworten in Querri, Claude und ChatGPT
So funktioniert die Verbindung
-
Querri liest nur die Tabellen, die Sie auswählen, über einen Service Principal mit OAuth oder ein persönliches Zugriffstoken, jeweils mit Lesezugriff.
-
Jede Tabelle ist Live oder synchronisiert, nach Ihrer Wahl. Eine Live-Tabelle bleibt in Databricks: Jede Frage läuft auf Ihrem SQL Warehouse als eine schreibgeschützte Abfrage in Databricks SQL, mit den Zeilenregeln jeder Person darin, und nur das Ergebnis kommt zurück. Live-Tabellen sind im Scale-Tarif verfügbar.
-
Live-Abfragen nutzen die Rechenleistung Ihres SQL Warehouse, und ein gestopptes Warehouse verlängert die erste Frage um einige Sekunden. Synchronisierte Tabellen berühren Databricks nur bei der Synchronisierung, sodass alltägliche Fragen dazu kein Warehouse am Laufen halten. Sehr große Tabellen eignen sich meist für Live, kleine, die intensiv erkundet werden, meist für die Synchronisierung.
-
Querri schreibt nie zurück in Databricks, und Ihre Daten werden nie zum Training eines Modells verwendet.
FAQ
Häufige Fragen beim Vergleich von Querri und Databricks
Ist Querri ein Ersatz für Databricks?
Für ein Team ohne Data Engineers, das geschäftliche Antworten will, deckt Querri ab, wofür es sonst ein Lakehouse bauen würde: Systeme verbinden, Daten speichern und bereinigen, Kennzahlen definieren, Dashboards und KI. Für Machine Learning, Streaming, intensives Data Engineering oder Daten im Petabyte-Bereich ist Databricks die stärkere Plattform, und Querri setzt direkt darauf auf: Behalten Sie Ihre Daten im Lakehouse und lassen Sie das Geschäft ihnen direkt Fragen stellen.
Was kostet Databricks pro Monat?
Databricks berechnet DBUs je nach Workload-Typ, etwa $0.15 pro DBU für Jobs bis etwa $0.70 für Serverless SQL (US-Zahlen von Dritten), plus die Maschinen und den Speicher in Ihrem eigenen Cloud-Konto auf einer separaten Rechnung. Vendr meldet einen Median-Vertrag von etwa $333,000 pro Jahr, bei einer großen Spannweite. Querri ist ein Plan mit planbaren Kosten, mit KI und Dashboards inklusive; siehe aktuelle Pläne.
Warum ist meine Databricks-Rechnung so hoch?
Meist liegt es an ein paar Mustern: Cluster, die bis zu einer langen automatischen Beendigung weiterlaufen, Jobs auf All-Purpose-Compute statt auf Job-Compute, überdimensionierte Cluster und großzügiges Autoscaling, SQL-Warehouses, die für einen kleinen Bericht rund um die Uhr laufen, und die Cloud-Rechnung, die getrennt von den DBUs kommt. Compute-Richtlinien, eine kurze automatische Beendigung, Tagging und Budgets helfen, und sie brauchen dauerhaft die Aufmerksamkeit von jemandem.
Was kostet Databricks Genie?
Genie enthält ein kostenloses monatliches Kontingent für die Modellnutzung. Darüber hinaus wird die Genie-Nutzung seit dem 8. Juli 2026 in DBUs abgerechnet, und das SQL-Warehouse-Compute hinter jeder Antwort wird separat berechnet. Die Genie-Budgets von Databricks sind keine absolute Ausgabenobergrenze. In Querri ist KI in jedem Plan enthalten, aus einem festen monatlichen Credit-Kontingent.
Ist Databricks für ein kleines Unternehmen überdimensioniert?
Das kann sein. Databricks ist für große Datenmengen, Engineering und Machine Learning gebaut, und seine Best Practices setzen ein Plattformteam voraus. Wenn Ihre Daten Geschäftsdaten aus einer Handvoll Systemen sind und bequem auf eine Maschine passen, bleiben die Stärken der Plattform ungenutzt, ihre Kosten und ihr Pflegeaufwand aber nicht. Querri gibt Ihnen Antworten ohne die Plattform.
Ist DuckDB schneller als Spark?
Für Daten, die auf eine Maschine passen, meist ja. DuckDB läuft in-process, ohne Cluster, der erst starten muss, und spart sich so den Start- und Koordinationsaufwand von Spark; ein Benchmark auf Microsoft Fabric ergab, dass DuckDB auf einem einzelnen Knoten für denselben 5-GB-Job etwa ein Fünftel des Computes von Spark verbrauchte. Für viele Terabyte, Streaming oder ML ist Spark das richtige Tool.
Wie viele Daten kann Querri verarbeiten?
Querri ist für die Daten gebaut, mit denen Unternehmen arbeiten: CRM, Buchhaltung, ERP, Werbung, Zahlungen und Tabellenkalkulationen, typischerweise Megabyte bis Hunderte Gigabyte. Dateien lassen sich mit bis zu 2 GB pro Datei hochladen, und der Speicher wächst mit Ihrem Plan. Wenn Ihre Daten viele Terabyte umfassen, behalten Sie sie im Lakehouse und fragen Sie sie aus Querri live ab, oder synchronisieren Sie die kuratierten Tabellen, die Ihr Team bereits gebaut hat.
Braucht Genie ein Datenteam?
Die Best Practices von Databricks selbst empfehlen, mit höchstens fünf Tabellen zu beginnen, gute Beschreibungen in Unity Catalog zu schreiben und den Agenten von „Datenanalysten, die SQL beherrschen“, kuratieren zu lassen. Partner ergänzen, dass Genie gute Governance vervielfacht, sie aber nicht ersetzt. Querri baut sein Verständnis auf, während Ihr Team fragt, und die Menschen, die das Geschäft kennen, legen fest, was die Zahlen bedeuten.
Kann sich Querri mit Databricks verbinden?
Ja, auf zwei Arten, Tabelle für Tabelle gewählt. Live-Tabellen bleiben in Databricks und werden dort schreibgeschützt abgefragt, mit den Zeilenregeln jeder Person direkt in der Abfrage. Synchronisierte Tabellen werden nach Zeitplan in Querri kopiert, neben 125+ Geschäftssystemen. In beiden Fällen kann das Geschäft Fragen stellen, während Ihre Data Engineers weiterbauen.
Fragt Querri Databricks live ab?
Ja, für die Tabellen Ihrer Wahl. Eine Live-Tabelle bleibt in Ihrem Lakehouse: Querri speichert nur ihre Spalten und eine geschätzte Zeilenzahl, formuliert jede Frage in Databricks SQL, führt sie auf Ihrem SQL Warehouse als einzelnes schreibgeschütztes SELECT aus und holt nur das Ergebnis zurück. Live-Abfragen nutzen Ihr Warehouse-Compute; synchronisierte Tabellen werden aus der Kopie von Querri beantwortet und tun das nicht. Live-Tabellen sind im Scale-Tarif verfügbar.
Kann ich meine Daten in Databricks behalten und trotzdem Querri nutzen?
Ja. Machen Sie die Tabellen Live, dann bleiben sie in Databricks: Querri kopiert nie ihre Zeilen, auch nicht bei geplanten Aktualisierungen. Schreibvorgänge, andere Tabellen, Dateizugriffe und Sitzungseinstellungen werden abgelehnt, bevor irgendetwas das Warehouse erreicht, und die Zeilenregeln jeder Person werden innerhalb der Abfrage angewendet. Die Ergebnisse von Fragen werden wie jede Antwort in Querri gespeichert, sodass Diagramme, Dashboards, Exporte und Folgefragen damit funktionieren.
Verbrauchen Live-Abfragen Databricks-Compute?
Ja. Live-Abfragen laufen auf Ihrem SQL Warehouse und erscheinen daher auf Ihrer Databricks-Rechnung, und ein gestopptes Warehouse verlängert die erste Frage um einige Sekunden; ein kaltes Serverless Warehouse kostete in unseren Tests etwa 5 bis 10 Sekunden zusätzlich. Vor einer geplanten Aktualisierung prüft Querri, ob sich die Tabelle geändert hat, mit einer Metadatenprüfung, die das Warehouse nicht startet, und führt nichts aus, wenn nicht. Wenn Fragen kein Compute verbrauchen sollen, synchronisieren Sie die Tabelle stattdessen.
Brauche ich ein Lakehouse, um KI auf meine Daten anzuwenden?
Nicht für geschäftliche Antworten. Ein Lakehouse ist ein starkes Fundament für Engineering, ML und sehr große Datenmengen, und Aufbau und Betrieb erfordern Data Engineers. Querri gibt Ihnen Speicher, Bereinigung, Definitionen und Antworten in einem Produkt, und Sie können später ein Lakehouse ergänzen, wenn Sie hineinwachsen.
Was ist die beste Databricks-Alternative für ein Team ohne Data Engineers?
Eine, die vor der ersten Antwort keinen Cluster, keinen Katalog und keine kuratierten Tabellen braucht. Querri verbindet Ihre Systeme, bereinigt die Daten automatisch, lernt Ihre Definitionen in einfacher Sprache und erstellt Dashboards per Frage, in einem Plan mit planbaren Kosten. Sie können mit dem kostenlosen Plan starten.
Kann ich Querri zuerst mit meinen eigenen Daten testen?
Ja. Sie können ohne Kreditkarte mit dem kostenlosen Plan starten, eine Quelle verbinden und fragen. Was jeder Plan enthält, sehen Sie unter Pläne ansehen. Oder bringen Sie Ihre schwierigste Frage zu einer 20-minütigen Demo mit.
Quellen
Woher diese Fakten stammen
Geprüft am 15. Oktober 2026. Databricks aktualisiert Preise und Produkte häufig; wenn hier etwas veraltet ist, sagen Sie es uns, und wir korrigieren es.
- Best practices for cost optimization Databricks docs
- Manage compute (auto-termination) Databricks docs
- Compute policies Databricks docs
- Account budgets Databricks docs
- Billable usage system table Databricks docs
- Genie budgets Databricks docs
- Genie pricing Databricks
- Genie agents best practices Databricks docs
- Databricks launches Genie One Databricks, Jun 2026
- Import Power BI and Tableau dashboards Databricks docs
- Real-time mode for Structured Streaming is GA Databricks, Mar 2026
- Standard tier retirement on Azure Databricks Microsoft Learn
- Databricks hits $7B run-rate Constellation Research, Aug 2026
- Databricks contract data (median contract) Vendr
- Estimating Databricks annual costs Databricks Community, Aug 2026
- Genie pricing, capabilities and ROI requirements (a Databricks partner) Addepto, Jul 2026
- Databricks FinOps optimization strategies Xebia, Sep 2026
- "Dumped Databricks once the first bill came" Hacker News, Nov 2025
- "A small server in a cupboard" Hacker News, Aug 2025
- Why TPC is not enough: Redshift fleet analysis (Redset) Amazon, VLDB, 2024
- The hunt for big data in the Redshift files MotherDuck, Aug 2024
- Fabric benchmark: Spark versus Python notebooks endjin, Apr 2026
- Why DuckDB DuckDB
- Big Data is Dead MotherDuck (Jordan Tigani), Feb 2023
- Is Big Data Dead? MotherDuck and the small data manifesto DataCamp podcast (Ryan Boyd), Oct 2024
- Querri pricing Querri
- Predictable credit use Querri docs
Sehen Sie Ihre eigenen Daten antworten, bevor Sie ein Lakehouse-Projekt starten
Verbinden Sie ein System oder laden Sie eine Tabellenkalkulation hoch, stellen Sie die Frage, die am meisten zählt, und sehen Sie die Abfrage hinter der Antwort. Wenn Databricks besser passt, sagen wir es Ihnen.