Querri vs Databricks
Databricks est un lakehouse que vous construisez. Querri est la réponse que vous cherchez.
Même objectif : des réponses fiables. Des projets très différents.
Databricks est l'une des plateformes de données les plus puissantes au monde, conçue pour les équipes d'ingénierie : un lakehouse, des pipelines, un catalogue, des tables préparées, deux factures et les personnes pour faire tourner le tout. Querri est la plateforme de données pensée à partir des questions. Elle part des questions que se pose votre entreprise et construit ce qu'il faut pour y répondre, dans un seul produit, avec une seule facture prévisible. Déjà sur Databricks ? Laissez les tables dans le lakehouse et laissez Querri les interroger directement.
Délais, coûts et contrôle
Des réponses dès ce trimestre, une facture prévisible et aucune nouvelle équipe à recruter
Databricks est une plateforme sur laquelle les équipes d'ingénierie construisent. Querri est le chemin complet de vos systèmes jusqu'à une réponse. Voici ce que cette différence change pour l'entreprise.
-
Des réponses en jours, pas en trimestres
Un projet lakehouse prend des semaines, voire des mois, avant que l'entreprise obtienne une réponse fiable. Avec Querri, vous connectez un système ou importez un fichier et vous posez vos questions le jour même.
-
Une facture que vous pouvez prévoir, sans surprise
Databricks facture des DBU plus les machines de votre fournisseur cloud : deux factures qui varient avec l'usage. Querri, c'est une seule facture prévisible : une enveloppe mensuelle de crédits liée au travail de votre équipe, des alertes avant de l'atteindre, et aucune facturation automatique de dépassement.
-
Aucune équipe data nécessaire
Databricks exige des ingénieurs pour construire les tables et un analyste pour garder Genie fiable. Dans Querri, les personnes qui connaissent déjà l'activité décident de ce que signifient les chiffres, en langage courant.
-
Sécurisé, auditable, rien à remplacer
SOC 2 Type II, HIPAA et ISO 27001:2022, et vos données n'entraînent jamais aucun modèle. Chaque chiffre montre sa requête, et si vous utilisez déjà Databricks, Querri fonctionne directement par-dessus, en direct ou synchronisé, sans rien déplacer.
Où chacun a sa place
Choisissez selon votre équipe et vos délais
Nous préférons que vous choisissiez le bon outil plutôt que de nous choisir pour de mauvaises raisons. Voici où chacun trouve sa place.
Choisissez Databricks si
- Vous avez des ingénieurs data qui construiront et feront tourner des pipelines Spark, des tables Delta et Unity Catalog, et qui garderont Genie bien préparé.
- Vos données se comptent en dizaines de téraoctets ou en pétaoctets, ou vous avez besoin de Spark pour des transformations lourdes.
- Vous entraînez et déployez des modèles de machine learning, ou vous avez besoin de streaming en temps réel avec une latence inférieure à la seconde.
- Vous voulez une seule plateforme pour l'ingénierie des données, la data science et les applications d'IA, gouvernée dans un seul catalogue.
- Quelqu'un prendra la facture en charge : politiques de calcul, arrêt automatique, étiquetage, budgets et facture cloud.
Choisissez Querri si
- Vous voulez des réponses métier en quelques jours, pas à l'issue d'un projet lakehouse, ou vous utilisez déjà Databricks et voulez que le métier l'interroge directement.
- Vos données vivent dans vos systèmes métier (CRM, comptabilité, ERP, paiements, tableurs) et tiennent sur une seule machine rapide.
- Les personnes qui savent ce que signifient les chiffres ne sont pas ingénieurs, et ne devraient pas avoir à écrire des vues de métriques pour le dire.
- Vous voulez une seule facture prévisible, pas des DBU plus une facture cloud qui arrivent séparément.
- Vous voulez des tableaux de bord, des rapports, un agent IA, le nettoyage des données et MCP pour Claude et ChatGPT intégrés, pas assemblés.
Fonction par fonction
La comparaison détaillée
Chaque ligne indique où chacun est le plus fort. Quand Databricks l'emporte, nous le disons. Les faits sont à jour en octobre 2026 et référencés dans les sources.
Les prix catalogue de Databricks varient selon le cloud, la région, le niveau et le contrat, et Databricks ne publie pas de grille tarifaire unique ; les chiffres de DBU sont des estimations tierces pour AWS aux États-Unis. Les informations produit proviennent de la documentation Databricks au 15 octobre 2026.
Tarifs
La tarification à la consommation récompense l'équipe qui la surveille
Ne payer que ce que vous utilisez est un vrai avantage quand quelqu'un s'en occupe. Databricks ajoute un second compteur : les DBU sur la facture de Databricks et les machines sur votre facture cloud. Sans personne pour surveiller les deux, le coût suit chaque cluster resté allumé et chaque question à laquelle un agent répond, et les relevés arrivent des heures plus tard.
Comment Databricks est facturé
- Deux factures. Des DBU à Databricks, selon le type de charge, plus les machines virtuelles et le stockage dans votre compte cloud. Le serverless intègre les machines dans un tarif DBU plus élevé.
- Les tarifs varient selon la charge : environ $0.15 le DBU pour les jobs à $0.70 pour le SQL serverless (chiffres tiers pour les États-Unis). Exécuter des jobs sur du calcul all-purpose coûte « nettement » plus cher.
- Les clusters inactifs continuent d'être facturés jusqu'à l'arrêt automatique, réglable de 10 à 10 000 minutes, ou jamais s'il est réglé sur 0.
- Genie inclut une allocation mensuelle gratuite pour l'usage de son modèle ; au-delà, Genie est facturé en DBU depuis le 8 juillet 2026, et le SQL warehouse qui le sous-tend est facturé séparément.
- Les budgets alertent par e-mail. Les budgets Genie ne sont pas « un plafond de dépense absolu », et les requêtes en cours « ne sont pas interrompues ».
- Les données de facturation arrivent « généralement sous 12 heures » : un job qui s'emballe apparaît une fois l'argent dépensé.
Quand la tarification à la consommation est la meilleure affaire
Si vous avez une équipe plateforme qui exécute les jobs sur du calcul dédié, définit des politiques de calcul et l'arrêt automatique, étiquette tout dès le premier jour et examine les tables système de facturation, Databricks peut être très rentable à grande échelle, et le temps d'ingénierie qu'il fait gagner peut compenser la facture. Si c'est votre équipe, les guides ci-dessous sont le bon point de départ.
Ce qui arrive quand personne ne surveille
Vous choisissez Databricks ? Gardez les deux compteurs sous contrôle.
Si Databricks est le bon choix pour vous, voici les réglages qui rendent la facture prévisible. La plupart proviennent de la documentation de Databricks.
- Bonnes pratiques d'optimisation des coûts Le calcul dédié aux jobs plutôt que l'all-purpose, le bon dimensionnement et l'étiquetage dès le premier jour. Databricks docs
- Définir des politiques de calcul Plafonnez les DBU par heure et les clusters que chaque personne peut créer. Databricks docs
- Configurer l'arrêt automatique Le calcul inactif est facturé jusqu'à son arrêt. Gardez un délai court. Databricks docs
- Créer des budgets Des alertes par e-mail quand la dépense mensuelle dépasse un seuil. Databricks docs
- Surveiller les tables système de facturation Voyez l'usage par charge, utilisateur et étiquette, avec environ 12 heures de décalage. Databricks docs
- Le FinOps Databricks en pratique Le guide de terrain de Xebia, avec de vraies économies sur le calcul inactif et surdimensionné. Xebia
Comment Querri garde la facture prévisible
- Une seule facture, sans surprise. Une seule offre pour toute l'organisation, avec l'IA, le stockage et des lecteurs de tableaux de bord illimités inclus. Voir les offres et les tarifs.
- Un crédit simple. Un crédit est une unité de travail métier, comme répondre à une question ou synchroniser une source, donc l'usage est facile à comprendre et facile à prévoir.
- Une seule facture. Le stockage, le calcul et l'IA sont inclus dans l'offre. Aucune facture cloud derrière.
- Des alertes d'usage à 80 % de l'offre, en cas de dépassement et de pic, plus une limite mensuelle pour chaque personne.
- Aucun dépassement facturé automatiquement. Nous vous prévenons à l'approche de votre limite, et vous décidez de la suite.
- Lecteurs de tableaux de bord illimités sur toutes les offres. La consultation, les imports, les exports et la Bibliothèque ne coûtent jamais de crédits.
Coût total
Ce qu'il faut pour obtenir la première réponse
Un lakehouse n'est que le point de départ. Avant qu'un utilisateur métier obtienne de Genie une réponse fiable, quelqu'un construit les tables, le catalogue et les vues de métriques qui le sous-tendent. Voici le parcours Databricks type, à côté de Querri.
Le parcours Databricks est notre estimation, fondée sur les données de contrats de Vendr, un modèle de coût de la communauté Databricks et les fourchettes de salaires des sources citées ; ce n'est pas un devis. Un déploiement petit et soigné coûte moins cher ; si vous avez déjà l'équipe, la ligne des équipes est un coût que vous avez déjà choisi.
Architecture
Spark pour les plus gros volumes. DuckDB pour les données que vous avez vraiment.
C'est la vraie différence d'architecture, et elle explique une bonne partie de l'écart de coût. Databricks a bâti sa plateforme sur Apache Spark, qui répartit le travail sur un cluster de machines. Querri utilise DuckDB, un moteur analytique embarqué extrêmement rapide sur une seule machine, sur des fichiers ouverts Parquet et Iceberg.
Databricks
Spark distribué, sur des clusters que vous payez tant qu'ils tournent
- Spark et le moteur Photon se répartissent sur de nombreuses machines. Pour des dizaines de téraoctets, le streaming et le ML, rien ne les égale.
- Les clusters facturent des DBU et des machines cloud tant qu'ils sont allumés, y compris le temps d'inactivité avant l'arrêt automatique, qui peut être réglé jusqu'à 10 000 minutes ou désactivé.
- Démarrer un cluster prend plusieurs minutes ; le serverless démarre plus vite, à un tarif DBU plus élevé.
- Des tables Delta et Iceberg ouvertes, dans votre propre stockage cloud.
Querri
DuckDB sur des fichiers ouverts, dimensionné pour les données métier
- Les données de chaque organisation sont stockées en Parquet dans des tables Apache Iceberg, dans son propre stockage.
- DuckDB les interroge dans le processus : aucun cluster à démarrer, dimensionner, garder au chaud ou payer pendant qu'il ne fait rien.
- Python prend le relais quand un dataframe fait mieux que SQL.
- Des formats ouverts de bout en bout : rien de vos données n'est enfermé dans un moteur propriétaire.
Où chaque moteur est le bon outil
Pourquoi l'architecture se retrouve sur la facture
Un cluster Spark facture les machines qui tournent, pas le travail qu'elles font, et il paie un coût de démarrage et de coordination pour répartir même une petite tâche. Dans un benchmark public sur la même charge de 5 GB, DuckDB sur un seul nœud a utilisé environ un cinquième du calcul consommé par Spark. Querri repose sur cette architecture, avec les connecteurs, le nettoyage, les définitions, les tableaux de bord et l'IA déjà intégrés, dans une seule offre prévisible.
Intégré, pas assemblé
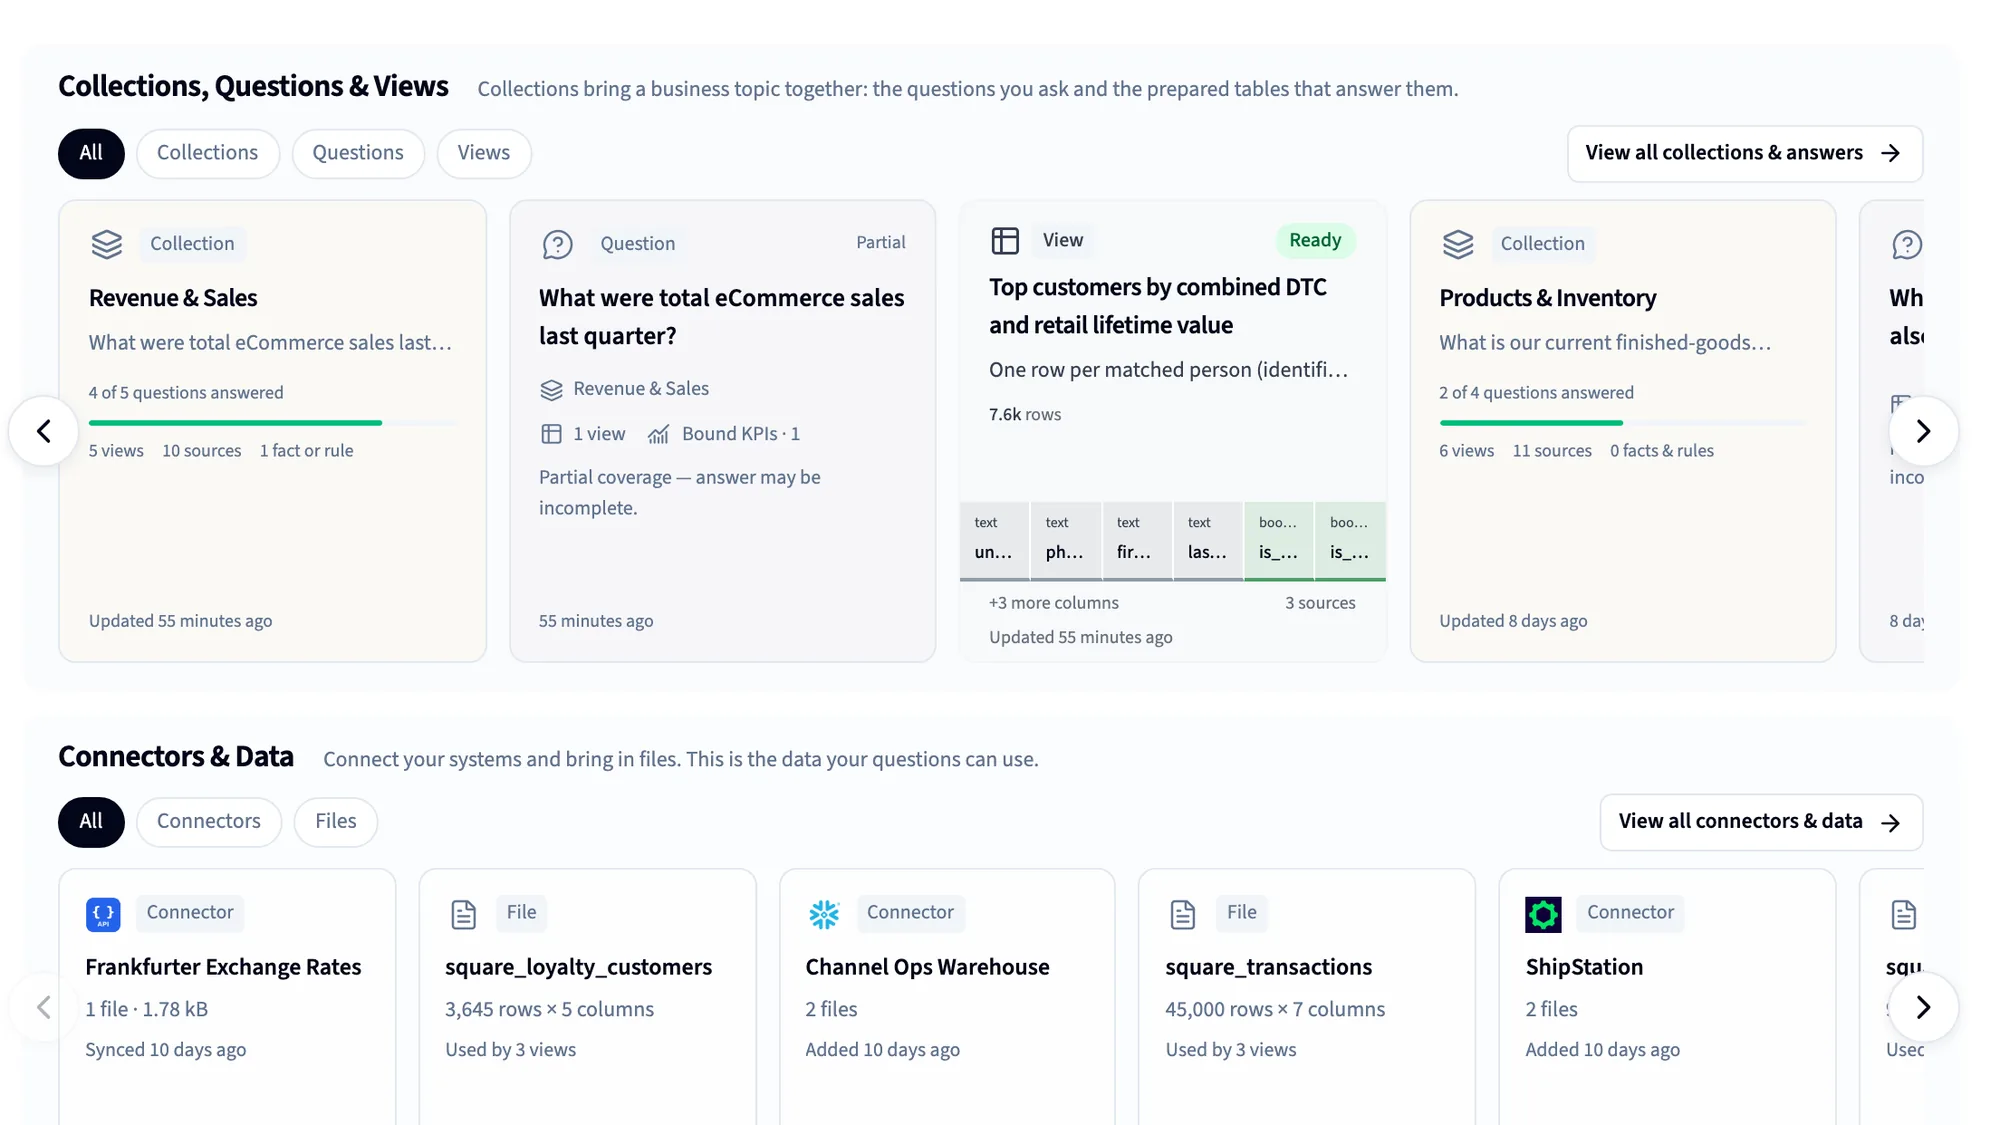
Tout ce qui sépare vos données de la réponse, dans un seul produit
Sur le parcours lakehouse, ce sont des briques distinctes à construire, connecter et tenir à jour. Dans Querri, elles forment une seule chaîne : les nouvelles données reconstruisent les vues qui en dépendent, les KPI se recalculent et chaque actualisation de tableau de bord rejoue sa requête enregistrée, si bien que chaque chiffre remonte jusqu'à sa source.
Plus de 125 connecteurs
CRM, comptabilité, ERP, paiements, publicité et bases de données, plus les tableurs et les fichiers.
Nettoyage automatique des données
Plus de 180 contrôles sur chaque table, et le Janitor pour corriger ce qu'ils trouvent.
La Bibliothèque
Une couche sémantique pensée pour le métier : définitions, KPI et règles, enseignés simplement en les énonçant.
Tableaux de bord
Créés en le demandant ou à partir d'une capture d'écran, partagés avec des lecteurs illimités.
Analyses nocturnes et Moniteurs
Querri parcourt vos données pendant la nuit et vous montre ce qui a changé.
MCP pour Claude et ChatGPT
Chaque assistant répond à partir des mêmes définitions, selon les accès de chaque personne.
Rapports et Excel
Projets planifiés, classeurs mis en forme et présentations, livrés pour vous.
Marque blanche et intégration
Apportez la même compréhension dans votre propre produit, sous votre marque.
Utiliser les deux
Comment Databricks et Querri fonctionnent ensemble
Beaucoup d'équipes utiliseront les deux, et c'est une bonne configuration. Gardez Databricks pour l'ingénierie, le machine learning et les plus gros volumes de données, et faites de Querri l'endroit où le métier pose ses questions. Querri peut fonctionner directement par-dessus Databricks : laissez les tables dans le lakehouse et interrogez-les en direct, ou synchronisez celles que vous préférez confier à Querri, à côté des systèmes qui n'ont jamais rejoint le lakehouse.
À garder dans Databricks
- Les pipelines Spark et les très gros volumes
- Le machine learning, l'entraînement et le déploiement de modèles
- Le streaming en temps réel
- Les pipelines qui alimentent d'autres systèmes
À faire dans Querri
- Les questions métier sur tous les systèmes
- Des définitions qui appartiennent au métier, en langage clair
- Des tableaux de bord pour tous, avec des lecteurs illimités
- Des réponses IA dans Querri, Claude et ChatGPT
Comment fonctionne la connexion
-
Querri ne lit que les tables que vous choisissez, avec un service principal en OAuth ou un jeton d'accès personnel, disposant d'un accès en lecture.
-
Chaque table est Live ou synchronisée, à vous de choisir. Une table Live reste dans Databricks : chaque question s'exécute sur votre SQL warehouse en une seule requête en lecture seule, en Databricks SQL, avec les règles de lignes de chaque personne appliquées à l'intérieur, et seul le résultat revient. Les tables Live sont disponibles avec l'offre Scale.
-
Les requêtes Live consomment le calcul de votre SQL warehouse, et un warehouse arrêté ajoute quelques secondes à la première question. Les tables synchronisées ne touchent Databricks que lors de la synchronisation : les questions du quotidien qui les concernent ne maintiennent donc pas un warehouse allumé. Les très grandes tables conviennent en général au Live ; les petites que vous explorez beaucoup conviennent en général à la synchronisation.
-
Querri n'écrit jamais dans Databricks, et vos données ne servent jamais à entraîner un modèle.
FAQ
Les questions qu'on se pose en comparant Querri et Databricks
Querri remplace-t-il Databricks ?
Pour une équipe sans ingénieurs data qui veut des réponses métier, Querri couvre ce pour quoi elle construirait un lakehouse : connecter les systèmes, stocker et nettoyer les données, définir les indicateurs, les tableaux de bord et l'IA. Pour le machine learning, le streaming, l'ingénierie des données lourde ou des données à l'échelle du pétaoctet, Databricks est la plateforme la plus solide, et Querri fonctionne par-dessus : gardez vos données dans le lakehouse et laissez le métier les interroger directement.
Combien coûte Databricks par mois ?
Databricks facture des DBU selon le type de charge, d'environ $0.15 le DBU pour les jobs à environ $0.70 pour le SQL serverless (chiffres tiers pour les États-Unis), plus les machines et le stockage dans votre propre compte cloud sur une facture séparée. Vendr fait état d'un contrat médian d'environ $333,000 par an, dans une fourchette très large. Querri, c'est une seule offre prévisible, IA et tableaux de bord compris ; consultez les offres actuelles.
Pourquoi ma facture Databricks est-elle si élevée ?
En général, quelques schémas récurrents : des clusters qui restent allumés jusqu'à un arrêt automatique tardif, des jobs exécutés sur du calcul all-purpose au lieu de calcul dédié, des clusters surdimensionnés et un autoscaling généreux, des SQL warehouses qui tournent jour et nuit pour un petit rapport, et la facture cloud qui arrive séparément des DBU. Les politiques de calcul, un arrêt automatique court, l'étiquetage et les budgets aident, mais ils demandent une attention constante.
Combien coûte Databricks Genie ?
Genie inclut une allocation mensuelle gratuite pour l'usage de son modèle. Au-delà, l'usage de Genie est facturé en DBU depuis le 8 juillet 2026, et le calcul SQL warehouse derrière chaque réponse est facturé séparément. Les budgets Genie de Databricks ne sont pas un plafond de dépense absolu. Dans Querri, l'IA est incluse dans toutes les offres, prélevée sur une allocation mensuelle de crédits fixe.
Databricks est-il disproportionné pour une petite entreprise ?
Il peut l'être. Databricks est conçu pour les gros volumes de données, l'ingénierie et le machine learning, et ses bonnes pratiques supposent une équipe plateforme. Si vos données sont des données métier issues d'une poignée de systèmes et tiennent largement sur une seule machine, les points forts de la plateforme restent inutilisés alors que ses coûts et son entretien, eux, demeurent. Querri vous donne les réponses sans la plateforme.
DuckDB est-il plus rapide que Spark ?
Pour des données qui tiennent sur une seule machine, en général oui. DuckDB s'exécute dans le processus, sans cluster à démarrer, et évite donc le coût de démarrage et de coordination de Spark ; un benchmark sur Microsoft Fabric a montré que DuckDB sur un seul nœud utilisait environ un cinquième du calcul de Spark pour la même tâche de 5 GB. Pour des dizaines de téraoctets, le streaming ou le ML, Spark est le bon outil.
Quel volume de données Querri peut-il gérer ?
Querri est conçu pour les données qui font tourner les entreprises : CRM, comptabilité, ERP, publicité, paiements et tableurs, généralement de quelques mégaoctets à des centaines de gigaoctets. Chaque fichier importé peut atteindre 2 GB, et le stockage augmente avec votre offre. Si vos données se comptent en dizaines de téraoctets, gardez-les dans le lakehouse et interrogez-les en direct depuis Querri, ou synchronisez les tables curées que votre équipe a déjà construites.
Genie a-t-il besoin d'une équipe data ?
Les bonnes pratiques de Databricks elles-mêmes recommandent de commencer avec cinq tables ou moins, de rédiger de bonnes descriptions dans Unity Catalog et de confier la préparation de l'agent à des « analystes de données compétents en SQL ». Les partenaires ajoutent que Genie démultiplie une bonne gouvernance, sans la remplacer. Querri construit sa compréhension au fil des questions de votre équipe, et ce sont les personnes qui connaissent l'activité qui fixent le sens des chiffres.
Querri peut-il se connecter à Databricks ?
Oui, de deux façons, au choix table par table. Les tables Live restent dans Databricks et sont interrogées sur place, en lecture seule, avec les règles de lignes de chaque personne appliquées à l'intérieur de la requête. Les tables synchronisées sont copiées dans Querri selon un calendrier, aux côtés de plus de 125 systèmes métier. Dans les deux cas, le métier peut poser ses questions pendant que vos ingénieurs continuent de construire.
Querri interroge-t-il Databricks en direct ?
Oui, pour les tables que vous choisissez. Une table Live reste dans votre lakehouse : Querri n'en garde que les colonnes et une estimation du nombre de lignes, écrit chaque question en Databricks SQL, l'exécute sur votre SQL warehouse en un seul SELECT en lecture seule et ne rapporte que le résultat. Les requêtes Live consomment le calcul de votre entrepôt ; les tables synchronisées reçoivent une réponse tirée de la copie de Querri et n'en consomment pas. Les tables Live sont disponibles avec l'offre Scale.
Puis-je garder mes données dans Databricks et utiliser Querri quand même ?
Oui. Passez les tables en Live et elles restent dans Databricks : Querri ne copie jamais leurs lignes, y compris lors des actualisations planifiées. Les écritures, les autres tables, les lectures de fichiers et les paramètres de session sont refusés avant que quoi que ce soit n'atteigne l'entrepôt, et les règles de lignes de chaque personne sont appliquées à l'intérieur de la requête. Les résultats des questions sont stockés dans Querri comme toute réponse : graphiques, tableaux de bord, exports et questions de suivi fonctionnent dessus.
Les requêtes Live consomment-elles du calcul Databricks ?
Oui. Les requêtes Live s'exécutent sur votre SQL warehouse : elles apparaissent donc sur votre facture Databricks, et un warehouse arrêté ajoute quelques secondes à la première question ; dans nos tests, un warehouse serverless à froid ajoutait environ 5 à 10 secondes. Avant une actualisation planifiée, Querri vérifie si la table a changé, par une vérification des métadonnées qui ne démarre pas le warehouse, et n'exécute rien si ce n'est pas le cas. Si vous préférez que les questions ne consomment pas de calcul, synchronisez plutôt la table.
Ai-je besoin d'un lakehouse pour utiliser l'IA sur mes données ?
Pas pour obtenir des réponses métier. Un lakehouse est une base solide pour l'ingénierie, le ML et les très gros volumes de données, et il faut des ingénieurs pour le construire et le faire tourner. Querri vous apporte le stockage, le nettoyage, les définitions et les réponses dans un seul produit, et vous pourrez ajouter un lakehouse plus tard si votre croissance le justifie.
Quelle est la meilleure alternative à Databricks pour une équipe sans ingénieurs data ?
Une alternative qui n'exige ni cluster, ni catalogue, ni tables préparées avant la première réponse. Querri connecte vos systèmes, nettoie les données automatiquement, apprend vos définitions en langage courant et crée des tableaux de bord à la demande, avec une seule offre prévisible. Vous pouvez commencer avec l'offre gratuite.
Puis-je d'abord essayer Querri sur mes propres données ?
Oui. Vous pouvez commencer avec l'offre gratuite, sans carte de crédit, connecter une source et poser votre question. Voir les offres pour savoir ce que chacune comprend. Vous pouvez aussi apporter votre question la plus difficile à une présentation de 20 minutes.
Sources
D'où viennent ces informations
Vérifié le 15 octobre 2026. Databricks met souvent à jour ses tarifs et ses produits ; si quelque chose ici n'est plus à jour, dites-le-nous et nous le corrigerons.
- Best practices for cost optimization Databricks docs
- Manage compute (auto-termination) Databricks docs
- Compute policies Databricks docs
- Account budgets Databricks docs
- Billable usage system table Databricks docs
- Genie budgets Databricks docs
- Genie pricing Databricks
- Genie agents best practices Databricks docs
- Databricks launches Genie One Databricks, Jun 2026
- Import Power BI and Tableau dashboards Databricks docs
- Real-time mode for Structured Streaming is GA Databricks, Mar 2026
- Standard tier retirement on Azure Databricks Microsoft Learn
- Databricks hits $7B run-rate Constellation Research, Aug 2026
- Databricks contract data (median contract) Vendr
- Estimating Databricks annual costs Databricks Community, Aug 2026
- Genie pricing, capabilities and ROI requirements (a Databricks partner) Addepto, Jul 2026
- Databricks FinOps optimization strategies Xebia, Sep 2026
- "Dumped Databricks once the first bill came" Hacker News, Nov 2025
- "A small server in a cupboard" Hacker News, Aug 2025
- Why TPC is not enough: Redshift fleet analysis (Redset) Amazon, VLDB, 2024
- The hunt for big data in the Redshift files MotherDuck, Aug 2024
- Fabric benchmark: Spark versus Python notebooks endjin, Apr 2026
- Why DuckDB DuckDB
- Big Data is Dead MotherDuck (Jordan Tigani), Feb 2023
- Is Big Data Dead? MotherDuck and the small data manifesto DataCamp podcast (Ryan Boyd), Oct 2024
- Querri pricing Querri
- Predictable credit use Querri docs
Continuer la comparaison
Comparaisons associées
Voyez vos propres données répondre avant de lancer un projet lakehouse
Connectez un système ou déposez un tableur, posez la question qui compte le plus, et voyez la requête derrière la réponse. Si Databricks vous convient mieux, nous vous le dirons.