Pular para o conteúdo

Amazon Redshift + Querri

Analytics do Amazon Redshift,sem um chamado na fila dos analistas.

Os times de operações, finanças e clientes perguntam ao data warehouse em palavras simples e recebem respostas que usam as suas definições. O Querri copia as tabelas do Redshift que você escolher num agendamento, então as perguntas deles não aumentam a fila no seu cluster.

O Querri só lê o Redshift e nunca altera uma tabela ou uma linha. A senha do seu banco é guardada criptografada. Certificações SOC 2 Type II, HIPAA e ISO 27001:2022.

Por que os relatórios do Amazon Redshift ficam difíceis

O Redshift guarda o histórico. O negócio ainda espera na fila por ele.

Times na AWS colocam o Redshift no centro por bons motivos. As lentidões aparecem ao redor dele: quem consegue escrever a consulta, em que fila ela cai, quanto custa olhar e onde o resultado vai parar.

01

Uma pergunta precisa de alguém que conheça o schema

O Query editor v2 é um editor de SQL, e as tabelas têm os nomes dos pipelines que as carregam. A pergunta de um gerente de loja vira um pedido, e o pedido entra num backlog que o time de dados já não consegue zerar.

02

Consultas avulsas dividem filas com ETL e dashboards

As consultas esperam por um slot livre no WLM. Com o WLM manual, todas as filas de usuário juntas têm no máximo 50 slots, e a fila padrão roda cinco por vez. Um analista curioso pode deixar a carga da manhã mais lenta.

03

Explorar tem um taxímetro ligado

O Redshift Serverless cobra a computação por segundo com um mínimo de 60 segundos, e uma consulta cancelada ainda é cobrada pelo tempo em que rodou. Num cluster provisionado, mais gente explorando significa aumentar o tamanho ou pagar pelo concurrency scaling.

04

O que um número significa fica fora do Redshift

Receita líquida, cliente ativo, pedido atrasado: as definições ficam em modelos do dbt, na camada de BI ou na cabeça de um analista. A planilha do time de operações usa uma versão um pouco diferente e ninguém percebe.

05

Os resultados saem como CSV e começam a divergir

O Query editor v2 limita um resultado baixado a 5 MB, então extrações maiores passam por UNLOAD para o S3 ou são divididas à mão. Quando o arquivo chega ao Excel, ele nunca mais se atualiza.

O que você finalmente consegue responder

Oito perguntas sobre o Amazon Redshift que param de esperar por um engenheiro de dados

Cada uma vem de times que rodam na AWS: o que eles perguntam, por que isso trava no Redshift hoje e o que o Querri faz com isso.

Operações consegue respostas sobre pedidos e envios no Redshift sem aprender SQL?

Por que é difícil

A resposta é um join entre tabelas de pedidos, envios e armazéns cujos nomes só o autor do pipeline lembra. Operações espera dias por algo que leva dez minutos para um analista.

Com o Querri

O Querri copia as tabelas que você escolher para a Biblioteca, e qualquer pessoa com acesso pergunta no chat. Toda resposta lista as etapas que seguiu, então o time de dados revisa em vez de escrever.

O que é receita líquida depois de devoluções, descontos e cancelamentos?

Por que é difícil

Cada autor de SQL trata devoluções e reembolsos parciais de um jeito um pouco diferente. Finanças, operações e a apresentação para o conselho acabam com três números de receita líquida, todos vindos do Redshift.

Com o Querri

Defina a regra uma vez em Fatos e regras e acompanhe a receita líquida como um KPI. Chat, dashboards e relatórios agendados aplicam a mesma definição a partir daí.

Os pedidos no Redshift batem com o que finanças faturou no NetSuite?

Por que é difícil

As linhas de pedido chegam ao data warehouse vindas do app; as faturas ficam no ERP. Conciliar os dois é uma exportação mensal, um PROCV pelos números de pedido e uma longa lista de exceções.

Com o Querri

Conecte o NetSuite ao lado do Redshift e o Querri cruza pedidos com faturas, dizendo por qual campo fez o cruzamento. Os pedidos sem fatura voltam como uma lista, não como um total.

Quais clientes estão escorregando, olhando uso do produto e tickets de suporte juntos?

Por que é difícil

Os eventos de uso ficam no Redshift e as conversas ficam na ferramenta de suporte. Um score de saúde que use os dois normalmente significa comprar uma plataforma de CS ou um projeto paralelo que ninguém termina.

Com o Querri

Traga o Intercom para a mesma Biblioteca e monte o score uma vez. O playbook de score de saúde do cliente mostra as etapas.

A taxa de devolução de qual categoria de produto disparou durante a noite?

Por que é difícil

Os dados de devolução estão no Redshift de manhã, mas ninguém roda uma consulta para cada categoria todo dia. Um pico só é notado quando o total de reembolsos aparece no fechamento do mês.

Com o Querri

Os monitores noturnos comparam cada categoria com o próprio histórico usando aritmética simples. Uma categoria que foge do padrão aparece na sua Caixa de entrada de manhã, e nenhuma descoberta age sobre nada até você mandar.

Cada gerente regional pode receber os próprios números do Redshift no Excel toda segunda?

Por que é difícil

Alguém roda a consulta, filtra por região, cola num modelo e arruma a formatação. Quando essa pessoa falta, os arquivos de segunda não saem.

Com o Querri

Configure o relatório uma vez como um projeto. Um agendamento o executa de novo depois da sincronização e envia a cada gerente uma pasta de trabalho formatada só com a região dele. Veja relatórios e automação.

Quais campanhas de marketing trazem clientes que continuam comprando?

Por que é difícil

Os toques de campanha ficam no HubSpot e os pedidos recorrentes ficam no Redshift. A atribuição para na primeira compra, porque juntar os dois não é trabalho de ninguém.

Com o Querri

Conecte o HubSpot e o Querri acompanha os contatos da campanha até os pedidos seguintes deles, apontando correspondências que podem estar erradas. O playbook do canal à receita traz as etapas para a atribuição de pedidos recorrentes.

O nosso time pode perguntar ao Claude ou ao ChatGPT sobre dados do Redshift e receber o número do data warehouse?

Por que é difícil

Um assistente apontado direto para o cluster adivinha o que cada coluna significa e escreve o próprio SQL. Cada prompt pode cair numa definição diferente.

Com o Querri

Adicione o Querri ao Claude ou ao ChatGPT e as suas tabelas sincronizadas do Redshift vêm junto. Ele trabalha com as definições da Biblioteca e fica dentro das linhas que cada pessoa pode ver no Querri, então a taxa de atraso perguntada no Claude é a mesma do painel de operações.

O Amazon Redshift e o resto

O data warehouse raramente guarda a história inteira

O Redshift tem os pedidos, eventos e dados de uso que os seus pipelines carregam. Contratos, faturas, campanhas e conversas de suporte muitas vezes ficam nos próprios sistemas. O Querri mantém tudo lado a lado em uma só Biblioteca, então uma pergunta entre sistemas não espera por mais um pipeline.

O Amazon Redshift combina bem com

Respostas que você pode defender

Duas leituras justas da mesma pergunta, e o Querri diz qual usou

"Receita em setembro" pode contar os pedidos feitos em setembro ou os pedidos enviados em setembro. As tabelas do data warehouse têm as duas datas, as duas leituras são razoáveis, e os totais são diferentes. O Querri responde com uma, diz qual é e coloca o outro total ao lado, para que a revisão de operações e a de finanças discutam o negócio, não a coluna de data. Veja como as respostas funcionam.

Acorde sabendo o que mudou

O Querri revisa os dados da noite no data warehouse antes da daily

Depois da sincronização da madrugada, o Querri compara cada KPI com o próprio histórico e procura movimentos sobre os quais ninguém perguntou. As descobertas esperam na sua Caixa de entrada, e nenhuma delas muda nada até você aprovar.

Dashboards personalizados do Amazon Redshift

Dashboards do Redshift que mudam quando alguém pede

Diga o que o painel de operações deve mostrar, ou entregue ao Querri um print daquele que está na TV do armazém. As pessoas o alteram digitando o que querem diferente, os gráficos usam a mesma Biblioteca que o chat, e um líder regional pode ficar limitado às linhas da própria região.

  • Nenhuma camada de modelagem para montar antes do primeiro gráfico
  • Tabelas do Redshift ao lado dos dados de CRM, finanças e suporte
  • Um filtro de linhas por pessoa, do dashboard ao Claude
Cada mudança é uma frase: diga o que deve ficar diferente, o dashboard acompanha, e desfazer está logo ali.

Relatórios que você não precisa mais puxar à mão

Seis relatórios do Amazon Redshift que rodam depois de cada sincronização

O que é sincronizado

O schema que você escolher, copiado num agendamento

O Querri copia as tabelas e views que você escolher de um banco e schema do Redshift para o próprio armazenamento e depois responde a partir dessa cópia, em vez de consultar o Redshift ao vivo. Ele só consegue ler o que o usuário do banco usado na conexão tem permissão para ver.

O que você pode sincronizar

  • Tabelas
  • Views
  • Todas as tabelas do schema
  • Um conjunto de tabelas escolhidas a dedo
  • Tabelas incrementais, pela coluna updated_at ou por uma coluna que você escolher
  • Leitura em blocos para tabelas muito grandes
  • Os bancos e schemas de sistema do Redshift ficam ocultos no seletor.

Completa ou incremental

Atualização completa por padrão. Escolha uma coluna como updated_at e as sincronizações incrementais trazem só as linhas mais novas, até de hora em hora. Uma atualização completa também remove as linhas excluídas no Redshift.

Feito para tabelas grandes

As linhas vão direto para Parquet em fluxo, nunca guardadas na memória de uma só vez. Para tabelas com dezenas de milhões de linhas, um modo em blocos lê 100.000 linhas por vez e retoma de onde uma sincronização com falha parou.

Somente leitura

O Querri só roda leituras com SELECT e cursor, além de uma configuração de sessão para nomes que diferenciam maiúsculas de minúsculas. Ele nunca cria, altera ou exclui uma tabela ou uma linha.

Credenciais guardadas criptografadas

Você se conecta com um usuário e uma senha do banco, guardados criptografados. O SSL vem ativado por padrão, e um cluster numa rede privada pode ser acessado por um túnel OpenVPN.

Como conectar o Amazon Redshift

Um endpoint, um usuário do banco e uma aprovação

  1. 1

    Peça ao Connector Agent

    Abra Connect e diga "conecte o nosso Redshift", ou escolha o Amazon Redshift no catálogo.

  2. 2

    Informe o endpoint

    Adicione o host do cluster, a porta (5439 por padrão), o banco de dados e o schema. O SSL fica ativado, a menos que você o desligue.

  3. 3

    Adicione um usuário do banco

    Informe o usuário e a senha; a senha é guardada criptografada. Um cluster numa rede privada pode se conectar por um túnel OpenVPN.

  4. 4

    Escolha as tabelas e aprove

    Leve todas as tabelas do schema ou escolha algumas, defina como cada uma sincroniza e escolha um agendamento. Nada é carregado até você aprovar.

  5. 5

    Faça a sua primeira pergunta

    Quando a primeira sincronização termina, as suas tabelas do Redshift estão na Biblioteca, prontas para o chat, dashboards e relatórios agendados.

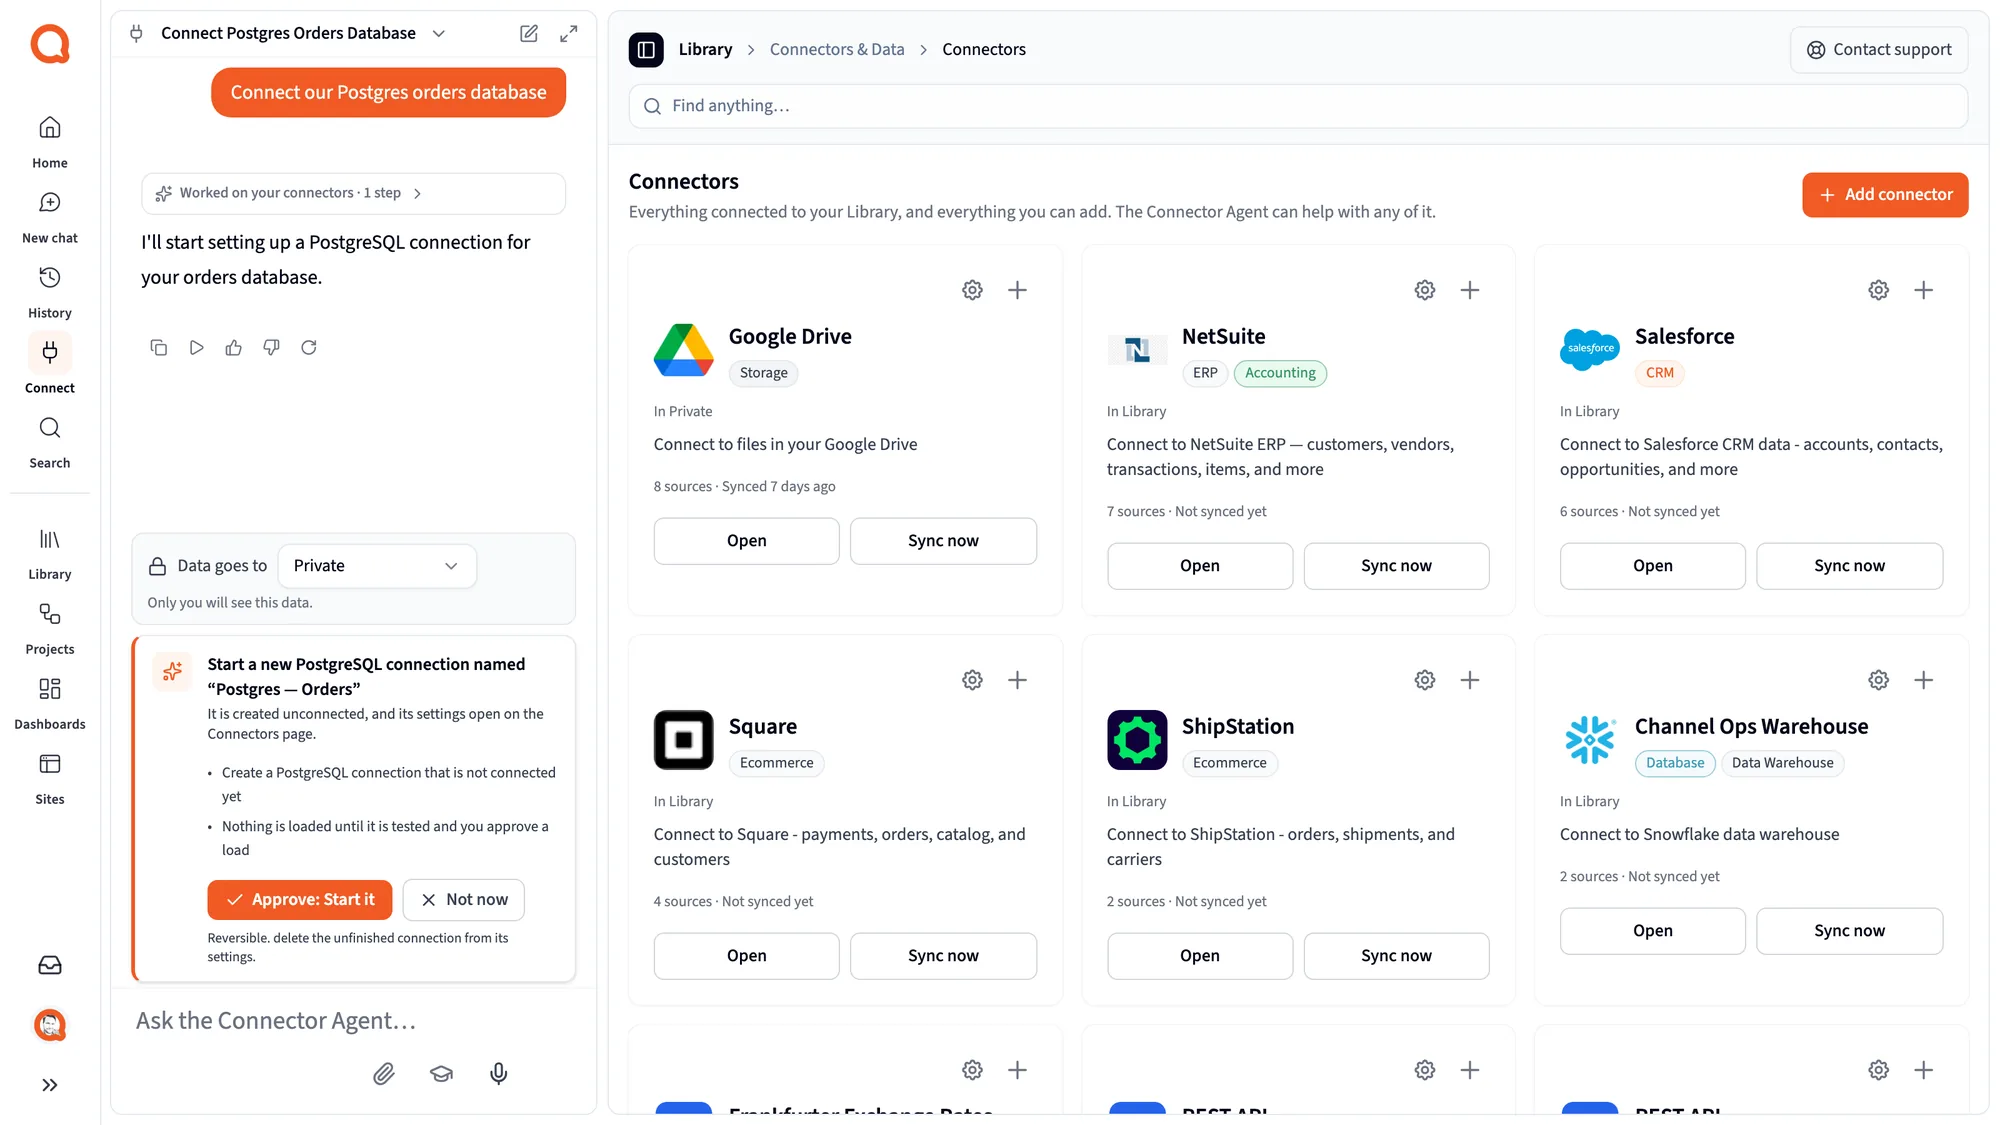
A página Connect do Querri: o Connector Agent pede aprovação antes de iniciar uma conexão, ao lado de cartões de conectores para Google Drive, NetSuite, Salesforce, Square, ShipStation e Snowflake
Antes de criar qualquer conexão, o Connector Agent pede a sua aprovação.

Perguntas frequentes sobre o Amazon Redshift

Perguntas sobre o Amazon Redshift e o Querri

Como conectar o Amazon Redshift ao Querri?

Peça ao Connector Agent para conectar o Redshift, ou escolha-o no catálogo. Informe o host do cluster, a porta (5439 por padrão), o banco de dados, o schema e um usuário e senha do banco. Depois escolha todas as tabelas ou algumas, defina um agendamento e aprove. Nenhum dado se move até você aprovar a carga.

Quais dados do Amazon Redshift o Querri sincroniza?

Tabelas e views do banco e do schema que você escolher, todas elas ou um conjunto selecionado no seletor de tabelas. Os bancos e schemas de sistema do Redshift ficam ocultos. O Querri só consegue sincronizar o que o usuário do banco usado na conexão tem permissão para ler.

Com que frequência os dados do Amazon Redshift são sincronizados?

Uma atualização completa pode ser diária, semanal ou mensal. Tabelas com uma coluna de alteração confiável, updated_at por padrão, podem sincronizar de forma incremental a cada hora, dia ou semana, trazendo só as linhas além da marca máxima anterior. Uma sincronização manual está lá para o dia em que um relatório não pode esperar.

O Querri escreve ou altera os meus dados no Redshift?

Não. O Querri só lê os seus dados; ele nunca altera os seus registros. Ele roda leituras com SELECT e cursor, além de uma configuração de sessão que faz os nomes de tabelas e colunas diferenciarem maiúsculas de minúsculas naquela conexão. Ele nunca cria, atualiza ou exclui uma tabela ou uma linha no Redshift.

O Querri consulta o Redshift toda vez que alguém faz uma pergunta?

Não. O Querri responde a partir da própria cópia das tabelas que você escolheu, atualizada no seu agendamento. Só as sincronizações rodam consultas no seu cluster, então você pode agendá-las para horários tranquilos. As respostas são tão recentes quanto a última sincronização.

Como as permissões do Redshift valem no Querri?

O Querri só consegue ler o que foi concedido ao usuário do banco conectado, então dê a esse usuário os schemas e as tabelas que você quer no Querri. Os grants do Redshift não acompanham cada pessoa no Querri; lá, o compartilhamento do próprio Querri e um filtro de linhas por pessoa decidem quem vê o quê, no chat, nos dashboards, no Claude e na API.

Como combinar dados do Amazon Redshift e do Salesforce?

Conecte o Salesforce ao lado do Redshift e os dois chegam à mesma Biblioteca. O Querri cruza as contas do data warehouse com as contas do Salesforce, de preferência por um ID de conta guardado nos dois, e diz como fez o cruzamento. Aí você pode perguntar sobre uso frente a contratos, renovações ou negócios em aberto numa só pergunta.

Como combinar dados do Amazon Redshift e do NetSuite?

Conecte o NetSuite ao lado do Redshift. O Querri alinha os pedidos do data warehouse com as faturas do NetSuite pelo número do pedido ou pelo cliente e informa qual campo usou. Pedidos sem fatura, ou faturas sem pedido, voltam como uma lista para você trabalhar.

Como ter um relatório de envios atrasados a partir do Amazon Redshift?

Sincronize as suas tabelas de pedidos e de envios e diga ao Querri uma vez o que significa atraso, por exemplo enviado depois da data prometida. Peça a taxa de atraso por centro de distribuição ou por transportadora, fixe-a num dashboard e agende para chegar toda segunda.

Os dados de uso do Redshift podem alimentar um score de saúde do cliente?

Sincronize as tabelas de uso e conecte a sua ferramenta de suporte, como o Intercom. Monte o score uma vez a partir de uso, tickets e faturamento e deixe os monitores noturnos sinalizarem as contas cujo score cair. O playbook de score de saúde do cliente cobre cada etapa.

Dá para exportar dados do Amazon Redshift para o Excel automaticamente?

Sim. Salve a extração como um projeto e coloque-a num agendamento. Quando a sincronização mais recente chega, o Querri a executa de novo e envia por e-mail uma pasta de trabalho formatada, dividida em um arquivo por região ou destinatário quando você pedir. Ninguém exporta pelo Query editor v2 nem contorna o limite de 5 MB de download dele.

Dá para criar dashboards personalizados do Amazon Redshift sem SQL?

Sim. Descreva o painel numa frase, ou comece de um print de um dashboard em que o seu time já confia. As edições são pedidos em palavras simples, os gráficos podem colocar tabelas do data warehouse ao lado de dados do CRM e do ERP, e um filtro de linhas limita cada pessoa à sua parte.

Posso perguntar ao ChatGPT ou ao Claude sobre os meus dados do Amazon Redshift?

Sim, pela conexão MCP do Querri. O Claude ou o ChatGPT passa a ler as tabelas sincronizadas do Redshift pela sua Biblioteca, aplica as definições que você registrou e vê só as linhas que aquela pessoa pode ver no Querri. Ele não escreve SQL novo contra o cluster, então a taxa de atraso dele bate com a do dashboard.

O Querri consegue entrar no Redshift com IAM ou AWS SSO?

Hoje, não. O conector usa um usuário e uma senha do banco do Redshift, que o Querri guarda criptografados. Ele não usa roles do IAM, credenciais temporárias nem AWS SSO. Crie um usuário de banco dedicado com acesso de leitura aos schemas que você quer no Querri.

O Querri consegue acessar um cluster do Redshift numa rede privada?

Sim, pela configuração opcional de VPN. Você fornece um arquivo de configuração OpenVPN com a CA, o certificado e a chave, todos guardados criptografados, e o Querri se conecta por esse túnel. Isso cobre clusters que só são acessíveis dentro da sua VPC, por exemplo atrás do PrivateLink.

Como o Querri lida com tabelas muito grandes do Redshift?

As linhas vão direto para Parquet em fluxo, então uma tabela nunca fica inteira na memória. Para tabelas com dezenas de milhões de linhas, um modo em blocos lê em lotes ordenados, de 100.000 linhas por padrão, salva cada lote assim que termina e retoma do último se uma sincronização falhar.

Quais são os limites do conector do Amazon Redshift?

Cada conexão lê um banco e um schema. As sincronizações incrementais pulam as linhas cuja coluna de cursor é NULL, então escolha uma coluna que esteja sempre preenchida. As sincronizações incrementais não enxergam exclusões até a próxima atualização completa. Com o SSL ativado, o tráfego é criptografado, mas o certificado do servidor não é verificado.

Os meus dados do Amazon Redshift ficam seguros no Querri?

Sim. O Querri tem certificação SOC 2 Type II, HIPAA e ISO 27001:2022. A senha do seu banco e quaisquer chaves de VPN são guardadas criptografadas, o Querri só lê o Redshift, e os seus dados nunca são usados para treinar um modelo.

Deixe operações, finanças e CS perguntarem ao Redshift por conta própria.

Conecte com um endpoint e um usuário do banco. O Querri lê o Redshift e deixa cada tabela exatamente como encontrou.