सामग्री पर जाएँ

Amazon Redshift + Querri

Amazon Redshift एनालिटिक्स,एनालिस्ट की कतार में टिकट डाले बिना।

ऑपरेशंस, फ़ाइनेंस और कस्टमर टीमें वेयरहाउस से आम शब्दों में पूछती हैं और ऐसे जवाब पाती हैं जो आपकी परिभाषाएँ इस्तेमाल करते हैं। Querri आपकी चुनी हुई Redshift टेबल को शेड्यूल पर कॉपी करता है, इसलिए उनके सवाल आपके क्लस्टर की कतार नहीं बढ़ाते।

Querri, Redshift से सिर्फ़ पढ़ता है और कभी कोई टेबल या पंक्ति नहीं बदलता। आपका डेटाबेस पासवर्ड एन्क्रिप्ट करके सेव होता है। SOC 2 Type II, HIPAA और ISO 27001:2022 प्रमाणित।

Amazon Redshift रिपोर्टिंग मुश्किल क्यों हो जाती है

Redshift में इतिहास है। फिर भी बिज़नेस को उसके लिए कतार में इंतज़ार करना पड़ता है।

AWS टीमें सही वजहों से Redshift को केंद्र में रखती हैं। रुकावटें उसके आसपास दिखती हैं: क्वेरी कौन लिख सकता है, वह किस कतार में जाती है, देखने में कितना खर्च होता है, और नतीजा आखिर कहाँ पहुँचता है।

01

सवाल के लिए स्कीमा जानने वाला चाहिए

Query editor v2 एक SQL एडिटर है, और टेबल के नाम उन pipelines पर रखे गए हैं जो उन्हें लोड करती हैं। स्टोर मैनेजर का सवाल एक अनुरोध बन जाता है, और वह अनुरोध उस बैकलॉग में जुड़ जाता है जिसे डेटा टीम पहले ही खत्म नहीं कर पा रही।

02

Ad-hoc क्वेरी ETL और डैशबोर्ड के साथ कतार साझा करती हैं

क्वेरी खाली WLM स्लॉट का इंतज़ार करती हैं। Manual WLM में सभी यूज़र कतारों को मिलाकर ज़्यादा से ज़्यादा 50 स्लॉट मिलते हैं, और डिफ़ॉल्ट कतार एक बार में पाँच चलाती है। एक जिज्ञासु एनालिस्ट सुबह का लोड धीमा कर सकता है।

03

खोजबीन पर मीटर चलता रहता है

Redshift Serverless कंप्यूट का बिल हर सेकंड के हिसाब से बनाता है, कम से कम 60 सेकंड, और रद्द हुई क्वेरी का भी उतने समय का बिल बनता है जितनी देर वह चली। Provisioned क्लस्टर पर, ज़्यादा लोगों के खोजबीन करने का मतलब है साइज़ बढ़ाना या concurrency scaling के पैसे देना।

04

किसी आँकड़े का मतलब Redshift के बाहर रहता है

शुद्ध राजस्व, सक्रिय ग्राहक, देर से आया ऑर्डर: परिभाषाएँ dbt models, BI लेयर या किसी एनालिस्ट के दिमाग में होती हैं। ऑप्स टीम की स्प्रेडशीट थोड़ा अलग वर्शन इस्तेमाल करती है और किसी को पता नहीं चलता।

05

नतीजे CSV बनकर निकलते हैं और बिखरने लगते हैं

Query editor v2 डाउनलोड किए गए नतीजे को 5 MB तक सीमित रखता है, इसलिए बड़े नतीजे UNLOAD से S3 में जाते हैं या हाथ से बाँटे जाते हैं। फ़ाइल एक बार Excel में पहुँची, तो फिर कभी रिफ़्रेश नहीं होती।

जिनका जवाब आखिरकार मिल सकता है

Amazon Redshift के आठ सवाल जिन्हें अब डेटा इंजीनियर का इंतज़ार नहीं करना पड़ता

हर एक AWS पर चलने वाली टीमों से आता है: वे क्या पूछती हैं, आज Redshift पर यह क्यों अटकता है, और Querri इसे कैसे संभालता है।

क्या ऑपरेशंस टीम SQL सीखे बिना Redshift से ऑर्डर और शिपमेंट के जवाब पा सकती है?

मुश्किल क्यों है

जवाब ऑर्डर, शिपमेंट और वेयरहाउस टेबल के join से निकलता है, जिनके नाम सिर्फ़ pipeline लिखने वाले को याद हैं। जो काम एक एनालिस्ट दस मिनट में करता है, उसके लिए ऑप्स दिनों इंतज़ार करती है।

Querri के साथ

Querri आपकी चुनी हुई टेबल को Library में कॉपी करता है, और एक्सेस वाला कोई भी व्यक्ति चैट में पूछता है। हर जवाब अपने उठाए कदमों की सूची देता है, इसलिए डेटा टीम लिखने के बजाय समीक्षा करती है।

रिटर्न, डिस्काउंट और कैंसलेशन के बाद शुद्ध राजस्व का मतलब क्या है?

मुश्किल क्यों है

हर SQL लिखने वाला रिटर्न और आंशिक रिफ़ंड को थोड़ा अलग ढंग से संभालता है। फ़ाइनेंस, ऑप्स और बोर्ड डेक के पास शुद्ध राजस्व के तीन आँकड़े हो जाते हैं, और तीनों Redshift से आए होते हैं।

Querri के साथ

नियम एक बार फ़ैक्ट्स और नियम में बताएँ और शुद्ध राजस्व को एक KPI के रूप में ट्रैक करें। उसके बाद चैट, डैशबोर्ड और शेड्यूल की गई रिपोर्ट्स सभी वही परिभाषा लागू करते हैं।

क्या Redshift के ऑर्डर उससे मेल खाते हैं जो फ़ाइनेंस ने NetSuite में इनवॉइस किया?

मुश्किल क्यों है

ऑर्डर लाइनें ऐप से वेयरहाउस में आती हैं; इनवॉइस ERP में रहते हैं। उनका मिलान हर महीने एक एक्सपोर्ट, ऑर्डर नंबरों पर एक lookup और अपवादों की लंबी सूची है।

Querri के साथ

Redshift के साथ NetSuite कनेक्ट करें और Querri ऑर्डर का इनवॉइस से मिलान करता है, और बताता है कि किस फ़ील्ड पर मिलान किया। बिना इनवॉइस वाले ऑर्डर एक सूची के रूप में आते हैं, कुल के रूप में नहीं।

प्रोडक्ट इस्तेमाल और सपोर्ट टिकट दोनों को साथ देखें, तो कौन-से ग्राहक फिसल रहे हैं?

मुश्किल क्यों है

इस्तेमाल के इवेंट Redshift में हैं और बातचीत सपोर्ट टूल में। दोनों का इस्तेमाल करने वाले हेल्थ स्कोर का मतलब आमतौर पर एक CS प्लेटफ़ॉर्म खरीदना या ऐसा साइड प्रोजेक्ट होता है जिसे कोई पूरा नहीं करता।

Querri के साथ

Intercom को उसी Library में लाएँ और स्कोर एक बार बनाएँ। कस्टमर हेल्थ स्कोर प्लेबुक कदम दिखाती है।

किस प्रोडक्ट कैटेगरी की रिटर्न दर रातों-रात उछल गई?

मुश्किल क्यों है

रिटर्न का डेटा सुबह तक Redshift में होता है, लेकिन कोई भी हर दिन हर कैटेगरी पर क्वेरी नहीं चलाता। उछाल तब पकड़ में आता है जब रिफ़ंड का कुल महीने के क्लोज़ में दिखता है।

Querri के साथ

रात के monitors हर कैटेगरी की तुलना उसके अपने इतिहास से सीधे गणित से करते हैं। जो कैटेगरी अपने पैटर्न से हटती है, वह सुबह तक आपके Inbox में होती है, और आपके कहे बिना कोई भी खोज किसी चीज़ पर कदम नहीं उठाती।

क्या हर क्षेत्रीय मैनेजर को हर सोमवार Excel में अपने Redshift आँकड़े मिल सकते हैं?

मुश्किल क्यों है

कोई क्वेरी चलाता है, उसे हर क्षेत्र के लिए फ़िल्टर करता है, एक टेम्पलेट में चिपकाता है और फ़ॉर्मैटिंग ठीक करता है। वह व्यक्ति छुट्टी पर हो, तो सोमवार की फ़ाइलें नहीं जातीं।

Querri के साथ

रिपोर्ट को एक बार प्रोजेक्ट के रूप में सेट करें। एक शेड्यूल उसे सिंक के बाद दोबारा चलाता है और हर मैनेजर को सिर्फ़ उसके क्षेत्र वाली फ़ॉर्मैट की हुई वर्कबुक भेजता है। देखें रिपोर्ट्स और ऑटोमेशन।

कौन-से मार्केटिंग कैंपेन ऐसे ग्राहक लाते हैं जो बार-बार ऑर्डर करते हैं?

मुश्किल क्यों है

कैंपेन के टच HubSpot में हैं और दोबारा के ऑर्डर Redshift में। एट्रिब्यूशन पहली खरीद पर रुक जाता है क्योंकि दोनों को जोड़ना किसी का काम नहीं है।

Querri के साथ

HubSpot कनेक्ट करें और Querri संपर्कों को कैंपेन से उनके बाद के ऑर्डर तक ट्रैक करता है, और उन मिलानों को नोट करता है जो गलत हो सकते हैं। चैनल से राजस्व तक की प्लेबुक में दोबारा के ऑर्डर के एट्रिब्यूशन के कदम हैं।

क्या हमारी टीम Claude या ChatGPT से Redshift डेटा के बारे में पूछकर वेयरहाउस वाला आँकड़ा पा सकती है?

मुश्किल क्यों है

सीधे क्लस्टर से जोड़ा गया असिस्टेंट अंदाज़ा लगाता है कि हर कॉलम का क्या मतलब है और अपनी SQL खुद लिखता है। हर प्रॉम्प्ट अलग परिभाषा पर पहुँच सकता है।

Querri के साथ

Querri को Claude या ChatGPT में जोड़ें और आपकी सिंक की हुई Redshift टेबल साथ आ जाती हैं। यह Library की परिभाषाओं से काम करता है और उन्हीं पंक्तियों के अंदर रहता है जिनकी हर व्यक्ति को Querri में अनुमति है, इसलिए Claude में पूछी गई देरी की दर वही है जो ऑप्स बोर्ड पर है।

Amazon Redshift और बाकी सब

वेयरहाउस में शायद ही कभी पूरी कहानी होती है

Redshift में वे ऑर्डर, इवेंट और इस्तेमाल हैं जो आपकी pipelines लोड करती हैं। कॉन्ट्रैक्ट, इनवॉइस, कैंपेन और सपोर्ट बातचीत अक्सर अपने-अपने सिस्टम में रहते हैं। Querri इन्हें एक Library में साथ-साथ रखता है, ताकि कई सिस्टमों वाला सवाल किसी और pipeline का इंतज़ार न करे।

Amazon Redshift इनके साथ अच्छा काम करता है

ऐसे जवाब जिनके पीछे आप खड़े रह सकें

एक सवाल के दो सही अर्थ, और Querri बताता है कि उसने कौन-सा इस्तेमाल किया

"सितंबर का राजस्व" में सितंबर में दिए गए ऑर्डर गिने जा सकते हैं या सितंबर में शिप हुए ऑर्डर। वेयरहाउस टेबल में दोनों तारीखें होती हैं, दोनों वाजिब हैं, और कुल अलग आते हैं। Querri एक के साथ जवाब देता है, उसका नाम बताता है, और दूसरा कुल उसके साथ रखता है, ताकि ऑप्स और फ़ाइनेंस की समीक्षा में बहस तारीख वाले कॉलम पर नहीं, बिज़नेस पर हो। देखें जवाब कैसे काम करते हैं।

जागें तो जानें क्या बदला

Querri स्टैंडअप से पहले पिछली रात का वेयरहाउस डेटा देख लेता है

रात के सिंक के बाद, Querri हर KPI को उसके अपने रिकॉर्ड से जाँचता है और ऐसे बदलाव ढूँढता है जिनके बारे में किसी ने नहीं पूछा। खोजें आपके Inbox में इंतज़ार करती हैं, और आपकी मंज़ूरी तक उनमें से कोई कुछ नहीं बदलती।

कस्टम Amazon Redshift डैशबोर्ड

Redshift डैशबोर्ड जो किसी के पूछने पर बदल जाते हैं

बताएँ कि ऑप्स बोर्ड में क्या दिखना चाहिए, या Querri को वेयरहाउस फ़्लोर के TV पर चल रहे बोर्ड का स्क्रीनशॉट दें। लोग जो अलग चाहते हैं वह टाइप करके उसे बदलते हैं, उसके चार्ट उसी Library से आते हैं जिसे चैट इस्तेमाल करती है, और किसी क्षेत्रीय लीड को उसके क्षेत्र की पंक्तियों तक सीमित किया जा सकता है।

  • पहले चार्ट से पहले कोई मॉडलिंग लेयर नहीं बनानी
  • CRM, फ़ाइनेंस और सपोर्ट डेटा के साथ Redshift टेबल
  • हर व्यक्ति के लिए एक रो फ़िल्टर, डैशबोर्ड से Claude तक
हर बदलाव एक वाक्य है: बताएँ कि क्या अलग दिखना चाहिए, डैशबोर्ड वैसा हो जाता है, और undo वहीं मौजूद है।

ऐसी रिपोर्ट्स जिन्हें हाथ से निकालना बंद कर सकें

Amazon Redshift की छह रिपोर्ट्स जो हर सिंक के बाद चलती हैं

साप्ताहिक ऑपरेशंस पैक

हफ़्ते के ऑर्डर, फ़ुलफ़िलमेंट और रिटर्न, ताज़ा डेटा पर दोबारा चलाकर सोमवार की मीटिंग से पहले ईमेल किए गए।

रिपोर्ट्स देखें

फ़ुलफ़िलमेंट सेंटर के हिसाब से देर से हुए शिपमेंट

हर साइट और कैरियर की देरी की दर, देरी की आपकी अपनी परिभाषा के साथ।

डैशबोर्ड देखें

क्षेत्रीय वर्कबुक

हर क्षेत्र के लिए एक फ़ॉर्मैट की हुई Excel फ़ाइल, जिसमें सिर्फ़ उसी क्षेत्र की पंक्तियाँ हों।

Excel टूल्स देखें

कस्टमर हेल्थ स्कोर

Redshift से इस्तेमाल, टिकट और बिलिंग, हर अकाउंट के लिए एक स्कोर में।

प्लेबुक पढ़ें

चैनल से राजस्व तक

कौन-से कैंपेन ऐसे ग्राहक लाते हैं जिनके ऑर्डर आते रहते हैं।

प्लेबुक पढ़ें

टिकट की संख्या की वजहें

सपोर्ट बातचीत, उनके पीछे के ऑर्डर और प्रोडक्ट के हिस्सों से जुड़ी हुई।

प्लेबुक पढ़ें

क्या-क्या आता है

आपका चुना हुआ स्कीमा, शेड्यूल पर कॉपी किया हुआ

Querri एक Redshift डेटाबेस और स्कीमा से आपकी चुनी हुई टेबल और व्यू अपने स्टोरेज में कॉपी करता है, फिर Redshift पर लाइव क्वेरी करने के बजाय उसी कॉपी से जवाब देता है। यह सिर्फ़ वही पढ़ सकता है जो आपके कनेक्ट किए गए डेटाबेस यूज़र को देखने की अनुमति है।

आप क्या सिंक कर सकते हैं

  • टेबल
  • व्यू
  • स्कीमा की हर टेबल
  • हाथ से चुनी गई टेबल का सेट
  • Incremental टेबल, updated_at या आपके चुने कॉलम के आधार पर
  • बहुत बड़ी टेबल के लिए टुकड़ों में रीड
  • Redshift के system डेटाबेस और स्कीमा पिकर में नहीं दिखते।

पूरा या incremental

डिफ़ॉल्ट रूप से पूरा रिफ़्रेश। updated_at जैसा कोई कॉलम चुनें और incremental सिंक सिर्फ़ नई पंक्तियाँ लाते हैं, हर घंटे तक। पूरा रिफ़्रेश Redshift में डिलीट की गई पंक्तियाँ भी हटा देता है।

बड़ी टेबल के लिए बना

पंक्तियाँ सीधे Parquet में स्ट्रीम होती हैं, कभी एक साथ मेमोरी में नहीं रखी जातीं। करोड़ों पंक्तियों वाली टेबल के लिए, एक chunked मोड एक बार में 100,000 पंक्तियाँ पढ़ता है और फ़ेल हुए सिंक को वहीं से फिर शुरू करता है जहाँ वह रुका था।

सिर्फ़ पढ़ता है

Querri सिर्फ़ SELECT और cursor रीड चलाता है, साथ में case-sensitive नामों के लिए एक session setting। यह कभी कोई टेबल या पंक्ति बनाता, बदलता या डिलीट नहीं करता।

क्रेडेंशियल एन्क्रिप्ट करके रखे जाते हैं

आप डेटाबेस यूज़रनेम और पासवर्ड से कनेक्ट करते हैं, जो एन्क्रिप्ट करके सेव होते हैं। SSL डिफ़ॉल्ट रूप से चालू है, और प्राइवेट नेटवर्क पर मौजूद क्लस्टर तक OpenVPN टनल से पहुँचा जा सकता है।

Amazon Redshift कैसे कनेक्ट करें

एक endpoint, एक डेटाबेस यूज़र और एक मंज़ूरी

  1. 1

    Connector Agent से कहें

    Connect खोलें और कहें "हमारा Redshift कनेक्ट करो," या कैटलॉग से Amazon Redshift चुनें।

  2. 2

    Endpoint डालें

    क्लस्टर होस्ट, पोर्ट (डिफ़ॉल्ट 5439), डेटाबेस और स्कीमा जोड़ें। SSL तब तक चालू रहता है जब तक आप उसे बंद न करें।

  3. 3

    एक डेटाबेस यूज़र जोड़ें

    यूज़रनेम और पासवर्ड डालें; पासवर्ड एन्क्रिप्ट करके सेव होता है। प्राइवेट नेटवर्क पर मौजूद क्लस्टर OpenVPN टनल से कनेक्ट हो सकता है।

  4. 4

    टेबल चुनें और मंज़ूर करें

    स्कीमा की हर टेबल लें या कुछ चुनें, हर एक कैसे सिंक हो यह सेट करें, और एक शेड्यूल चुनें। आपकी मंज़ूरी तक कुछ भी लोड नहीं होता।

  5. 5

    अपना पहला सवाल पूछें

    पहला सिंक पूरा होने पर, आपकी Redshift टेबल Library में होती हैं, चैट, डैशबोर्ड और शेड्यूल की गई रिपोर्ट्स के लिए तैयार।

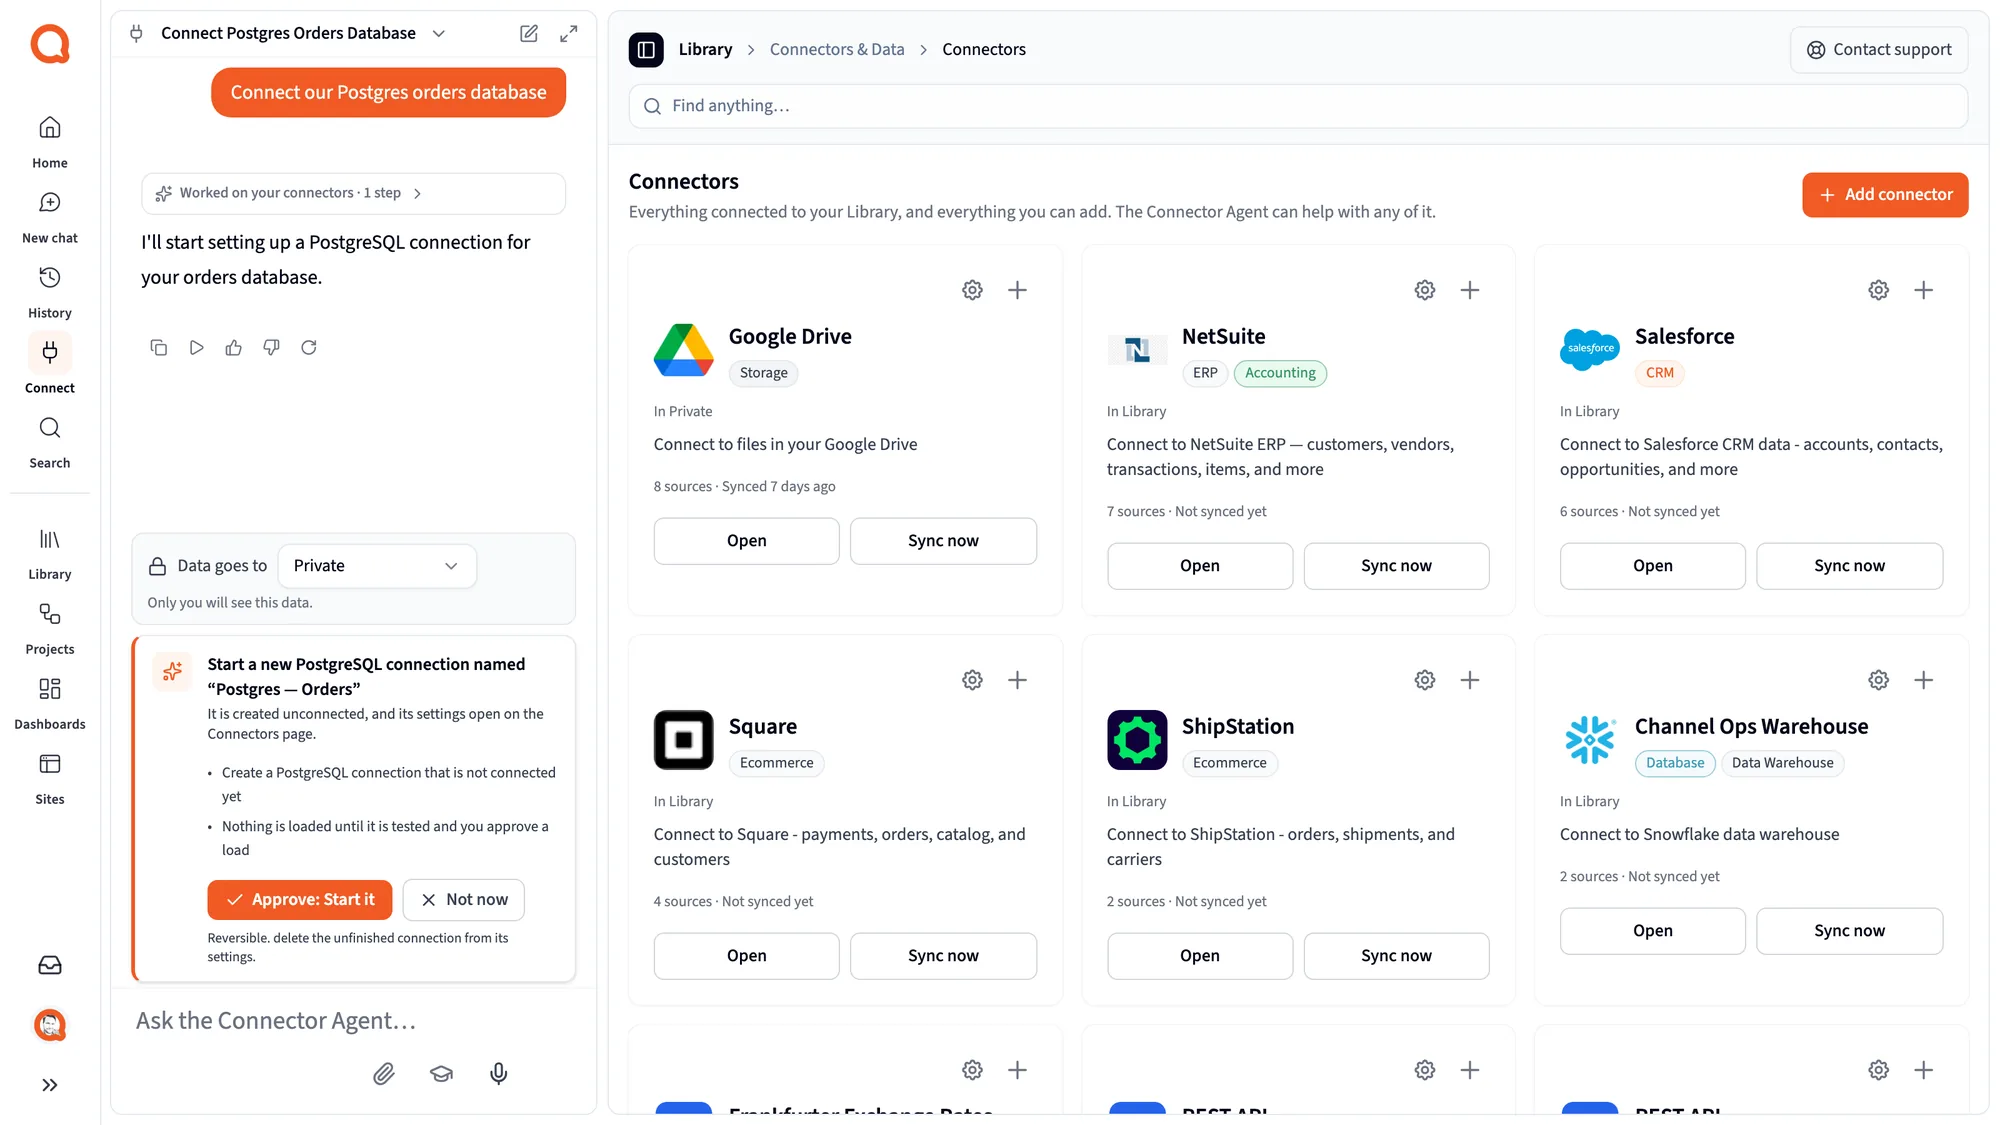
Querri का Connect पेज: Connector Agent कनेक्शन शुरू करने से पहले मंज़ूरी माँग रहा है, बगल में Google Drive, NetSuite, Salesforce, Square, ShipStation और Snowflake के कनेक्टर कार्ड
कोई भी कनेक्शन बनाने से पहले, Connector Agent आपसे उसे मंज़ूर करने को कहता है।

Amazon Redshift FAQ

Amazon Redshift और Querri के बारे में सवाल

Amazon Redshift को Querri से कैसे कनेक्ट करें?

Connector Agent से Redshift कनेक्ट करने को कहें, या कैटलॉग से उसे चुनें। क्लस्टर होस्ट, पोर्ट (डिफ़ॉल्ट 5439), डेटाबेस, स्कीमा और एक डेटाबेस यूज़रनेम और पासवर्ड डालें। फिर सभी टेबल या कुछ चुनें, शेड्यूल सेट करें और मंज़ूर करें। जब तक आप लोड मंज़ूर न करें, कोई डेटा नहीं जाता।

Querri, Amazon Redshift का कौन-सा डेटा सिंक करता है?

आपके चुने हुए डेटाबेस और स्कीमा से टेबल और व्यू, या तो सभी या वह सेट जो आप टेबल पिकर में चुनते हैं। Redshift के system डेटाबेस और स्कीमा छिपे रहते हैं। Querri सिर्फ़ वही सिंक कर सकता है जिसे पढ़ने की आपके कनेक्ट किए गए डेटाबेस यूज़र को अनुमति है।

Amazon Redshift डेटा कितनी बार सिंक होता है?

पूरा रिफ़्रेश रोज़, हर हफ़्ते या हर महीने के लिए सेट किया जा सकता है। भरोसेमंद change कॉलम वाली टेबल, डिफ़ॉल्ट रूप से updated_at, हर घंटे, दिन या हफ़्ते incremental रूप से सिंक हो सकती हैं, और सिर्फ़ पिछले high-water mark के बाद की पंक्तियाँ लाती हैं। जिस दिन कोई रिपोर्ट इंतज़ार न कर सके, उसके लिए हाथ से सिंक मौजूद है।

क्या Querri मेरे Redshift डेटा में लिखता या उसे बदलता है?

नहीं। Querri आपका डेटा सिर्फ़ पढ़ता है; यह कभी आपके रिकॉर्ड नहीं बदलता। यह SELECT और cursor रीड चलाता है, साथ में एक session setting जो उस कनेक्शन के लिए टेबल और कॉलम के नाम case-sensitive बनाती है। यह Redshift में कभी कोई टेबल या पंक्ति बनाता, अपडेट या डिलीट नहीं करता।

क्या हर बार किसी के सवाल पूछने पर Querri, Redshift पर क्वेरी करता है?

नहीं। Querri आपकी चुनी हुई टेबल की अपनी कॉपी से जवाब देता है, जो आपके शेड्यूल पर ताज़ा होती है। आपके क्लस्टर पर सिर्फ़ सिंक क्वेरी चलाते हैं, इसलिए आप उन्हें शांत घंटों के लिए शेड्यूल कर सकते हैं। जवाब उतने ही ताज़ा होते हैं जितना पिछला सिंक।

Redshift की अनुमतियाँ Querri में कैसे आती हैं?

Querri सिर्फ़ वही पढ़ सकता है जिसकी अनुमति कनेक्ट किए गए डेटाबेस यूज़र को दी गई है, इसलिए उस यूज़र को वे स्कीमा और टेबल दें जो आप Querri में चाहते हैं। Redshift grants अलग-अलग लोगों के साथ Querri में नहीं आते; वहाँ, Querri की अपनी शेयरिंग और हर व्यक्ति का रो फ़िल्टर तय करते हैं कि कौन क्या देखता है, चाहे चैट हो, डैशबोर्ड, Claude या API।

Amazon Redshift और Salesforce का डेटा एक साथ कैसे जोड़ें?

Redshift के साथ Salesforce कनेक्ट करें और दोनों उसी Library में आ जाते हैं। Querri वेयरहाउस अकाउंट का Salesforce अकाउंट से मिलान करता है, सबसे अच्छा दोनों में रखे अकाउंट ID पर, और बताता है कि मिलान कैसे किया। फिर आप एक ही सवाल में कॉन्ट्रैक्ट, रिन्यूअल या खुली डील के मुकाबले इस्तेमाल के बारे में पूछ सकते हैं।

Amazon Redshift और NetSuite का डेटा एक साथ कैसे जोड़ें?

Redshift के साथ NetSuite कनेक्ट करें। Querri ऑर्डर नंबर या ग्राहक के आधार पर वेयरहाउस के ऑर्डर को NetSuite इनवॉइस के साथ मिलाता है और बताता है कि उसने कौन-सा फ़ील्ड इस्तेमाल किया। बिना इनवॉइस वाले ऑर्डर, या बिना ऑर्डर वाले इनवॉइस, एक सूची के रूप में आते हैं जिस पर आप काम कर सकें।

Amazon Redshift से देर से हुए शिपमेंट की रिपोर्ट कैसे पाएँ?

अपनी ऑर्डर और शिपमेंट टेबल सिंक करें, फिर Querri को एक बार बताएँ कि देरी का क्या मतलब है, जैसे वादे की तारीख के बाद शिप हुआ। फ़ुलफ़िलमेंट सेंटर या कैरियर के हिसाब से देरी की दर पूछें, उसे डैशबोर्ड पर पिन करें, और हर सोमवार आने के लिए शेड्यूल करें।

क्या Redshift का इस्तेमाल डेटा कस्टमर हेल्थ स्कोर में काम आ सकता है?

इस्तेमाल वाली टेबल सिंक करें और अपना सपोर्ट टूल, जैसे Intercom, कनेक्ट करें। इस्तेमाल, टिकट और बिलिंग से स्कोर एक बार बनाएँ, फिर रात के monitors को उन अकाउंट को चिह्नित करने दें जिनका स्कोर गिरता है। कस्टमर हेल्थ स्कोर प्लेबुक हर कदम समझाती है।

क्या मैं Amazon Redshift डेटा को अपने आप Excel में एक्सपोर्ट कर सकता हूँ?

हाँ। डेटा निकालने के काम को एक प्रोजेक्ट के रूप में सेव करें और शेड्यूल पर लगा दें। सबसे नया सिंक आते ही Querri उसे फिर चलाता है और फ़ॉर्मैट की हुई वर्कबुक भेजता है, कहें तो हर क्षेत्र या प्राप्तकर्ता के लिए अलग फ़ाइल में बाँटकर। किसी को query editor v2 से एक्सपोर्ट नहीं करना पड़ता, न उसकी 5 MB डाउनलोड सीमा से जूझना पड़ता है।

क्या मैं SQL के बिना कस्टम Amazon Redshift डैशबोर्ड बना सकता हूँ?

हाँ। एक वाक्य में बोर्ड का वर्णन करें, या उस डैशबोर्ड के स्क्रीनशॉट से शुरू करें जिस पर आपकी टीम पहले से निर्भर है। बदलाव आम शब्दों में किए गए अनुरोध हैं, चार्ट वेयरहाउस टेबल को CRM और ERP डेटा के साथ रख सकते हैं, और एक रो फ़िल्टर हर देखने वाले को उसके हिस्से तक सीमित रखता है।

क्या मैं ChatGPT या Claude से अपने Amazon Redshift डेटा के बारे में पूछ सकता हूँ?

हाँ, Querri के MCP कनेक्शन के ज़रिए। फिर Claude या ChatGPT आपकी Library के ज़रिए सिंक की हुई Redshift टेबल पढ़ता है, आपकी लिखी परिभाषाएँ लागू करता है, और सिर्फ़ वही पंक्तियाँ देखता है जो वह व्यक्ति Querri में देख सकता है। यह क्लस्टर पर नई SQL नहीं लिखता, इसलिए उसकी देरी की दर डैशबोर्ड से मेल खाती है।

क्या Querri, IAM या AWS SSO से Redshift में साइन इन कर सकता है?

अभी नहीं। कनेक्टर Redshift डेटाबेस यूज़रनेम और पासवर्ड इस्तेमाल करता है, जिन्हें Querri एन्क्रिप्ट करके सेव करता है। यह IAM roles, temporary credentials या AWS SSO इस्तेमाल नहीं करता। उन स्कीमा पर पढ़ने के एक्सेस वाला एक अलग डेटाबेस यूज़र बनाएँ जो आप Querri में चाहते हैं।

क्या Querri प्राइवेट नेटवर्क पर मौजूद Redshift क्लस्टर तक पहुँच सकता है?

हाँ, वैकल्पिक VPN सेटिंग के ज़रिए। आप एक OpenVPN कॉन्फ़िगरेशन फ़ाइल उसके CA, सर्टिफ़िकेट और key के साथ देते हैं, जो सब एन्क्रिप्ट करके सेव होते हैं, और Querri उस टनल से कनेक्ट होता है। इसमें वे क्लस्टर आते हैं जो सिर्फ़ आपके VPC के अंदर से पहुँचे जा सकते हैं, जैसे PrivateLink के पीछे वाले।

Querri बहुत बड़ी Redshift टेबल को कैसे संभालता है?

पंक्तियाँ सीधे Parquet में स्ट्रीम होती हैं, इसलिए कोई टेबल कभी एक साथ मेमोरी में नहीं रखी जाती। करोड़ों पंक्तियों वाली टेबल के लिए, एक chunked मोड क्रम से बैच में पढ़ता है, डिफ़ॉल्ट रूप से 100,000 पंक्तियाँ, हर बैच पूरा होते ही सेव करता है और सिंक फ़ेल होने पर आखिरी बैच से फिर शुरू करता है।

Amazon Redshift कनेक्टर की सीमाएँ क्या हैं?

हर कनेक्शन एक डेटाबेस और स्कीमा पढ़ता है। Incremental सिंक उन पंक्तियों को छोड़ देते हैं जिनका cursor कॉलम NULL है, इसलिए ऐसा कॉलम चुनें जो हमेशा भरा हो। Incremental सिंक अगले पूरे रिफ़्रेश तक डिलीट नहीं देखते। SSL चालू होने पर ट्रैफ़िक एन्क्रिप्टेड रहता है, लेकिन सर्वर सर्टिफ़िकेट की जाँच नहीं होती।

क्या Querri में मेरा Amazon Redshift डेटा सुरक्षित है?

हाँ। Querri के पास SOC 2 Type II, HIPAA और ISO 27001:2022 प्रमाणन है। आपका डेटाबेस पासवर्ड और कोई भी VPN key एन्क्रिप्ट करके सेव होते हैं, Querri, Redshift से सिर्फ़ पढ़ता है, और आपका डेटा कभी किसी मॉडल को ट्रेन करने में इस्तेमाल नहीं होता।

ऑप्स, फ़ाइनेंस और CS को खुद Redshift से पूछने दें।

एक endpoint और एक डेटाबेस यूज़र से कनेक्ट करें। Querri, Redshift से पढ़ता है और हर टेबल को वैसा ही छोड़ता है जैसी वह मिली थी।