Saltar al contenido

Amazon Redshift + Querri

Analítica de Amazon Redshift,sin un ticket en la cola de los analistas.

Los equipos de operaciones, finanzas y clientes le preguntan al data warehouse en lenguaje natural y obtienen respuestas que usan tus definiciones. Querri copia las tablas de Redshift que elijas según una programación, así que sus preguntas no se suman a la cola de tu clúster.

Querri solo lee de Redshift y nunca modifica una tabla ni una fila. La contraseña de tu base de datos se guarda cifrada. Certificado SOC 2 Type II, HIPAA e ISO 27001:2022.

Por qué los informes de Amazon Redshift se complican

Redshift guarda el historial. El negocio sigue haciendo cola para llegar a él.

Los equipos de AWS ponen Redshift en el centro por buenas razones. Las demoras aparecen a su alrededor: quién puede escribir la consulta, en qué cola cae, cuánto cuesta mirar y dónde acaba el resultado.

01

Una pregunta necesita a alguien que conozca el esquema

Query editor v2 es un editor de SQL, y las tablas llevan el nombre de los pipelines que las cargan. La pregunta de un gerente de tienda se convierte en una solicitud, y la solicitud se suma a un backlog que el equipo de datos ya no puede vaciar.

02

Las consultas puntuales comparten colas con el ETL y los dashboards

Las consultas esperan un slot libre de WLM. Con WLM manual, todas las colas de usuario juntas tienen como máximo 50 slots, y la cola por defecto ejecuta cinco a la vez. Un analista curioso puede ralentizar la carga de la mañana.

03

Explorar tiene el taxímetro en marcha

Redshift Serverless cobra el cómputo por segundo con un mínimo de 60 segundos, y una consulta cancelada se cobra igual por el tiempo que se ejecutó. En un clúster aprovisionado, más gente explorando significa ampliar el tamaño o pagar por concurrency scaling.

04

Lo que significa una cifra vive fuera de Redshift

Ingresos netos, un cliente activo, un pedido con retraso: las definiciones están en modelos de dbt, en la capa de BI o en la cabeza de un analista. La hoja de cálculo del equipo de operaciones usa una versión ligeramente distinta y nadie se da cuenta.

05

Los resultados salen como CSV y empiezan a desviarse

Query editor v2 limita un resultado descargado a 5 MB, así que las extracciones más grandes pasan por UNLOAD a S3 o se dividen a mano. Una vez que el archivo está en Excel, nunca vuelve a actualizarse.

Lo que por fin puedes responder

Ocho preguntas de Amazon Redshift que dejan de esperar a un ingeniero de datos

Cada una viene de equipos que trabajan sobre AWS: lo que preguntan, por qué hoy se atasca en Redshift y lo que Querri hace con ella.

¿Puede operaciones obtener respuestas sobre pedidos y envíos desde Redshift sin aprender SQL?

Por qué es difícil

La respuesta es un join entre tablas de pedidos, envíos y almacenes cuyos nombres solo recuerda quien escribió el pipeline. Operaciones espera días por algo que a un analista le lleva diez minutos.

Con Querri

Querri copia las tablas que elijas en la Biblioteca, y cualquiera con acceso pregunta en el chat. Cada respuesta enumera los pasos que siguió, así que el equipo de datos revisa en lugar de escribir.

¿Qué significan los ingresos netos después de devoluciones, descuentos y cancelaciones?

Por qué es difícil

Cada autor de SQL trata las devoluciones y los reembolsos parciales de forma un poco distinta. Finanzas, operaciones y la presentación para el consejo acaban con tres cifras de ingresos netos que salieron todas de Redshift.

Con Querri

Indica la regla una sola vez en Hechos y reglas y sigue los ingresos netos como un KPI. A partir de ahí, el chat, los dashboards y los informes programados aplican la misma definición.

¿Los pedidos de Redshift coinciden con lo que finanzas facturó en NetSuite?

Por qué es difícil

Las líneas de pedido llegan al data warehouse desde la aplicación; las facturas viven en el ERP. Conciliarlas es una exportación mensual, una búsqueda por número de pedido y una larga lista de excepciones.

Con Querri

Conecta NetSuite junto a Redshift y Querri relaciona los pedidos con las facturas, indicando por qué campo los relacionó. Los pedidos sin factura vuelven como una lista, no como un total.

¿Qué clientes van a la baja, según el uso del producto y los tickets de soporte juntos?

Por qué es difícil

Los eventos de uso están en Redshift y las conversaciones están en la herramienta de soporte. Una puntuación de salud que use ambos suele implicar comprar una plataforma de CS o un proyecto paralelo que nadie termina.

Con Querri

Trae Intercom a la misma Biblioteca y crea la puntuación una vez. El playbook de puntuación de salud del cliente muestra los pasos.

¿La tasa de devoluciones de qué categoría de producto se disparó de un día para otro?

Por qué es difícil

Los datos de devoluciones están en Redshift por la mañana, pero nadie ejecuta una consulta sobre cada categoría todos los días. Un pico se nota cuando el total de reembolsos aparece en el cierre mensual.

Con Querri

Los monitores nocturnos comparan cada categoría con su propio historial usando aritmética simple. Una categoría que rompe su patrón aparece en tu Bandeja de entrada por la mañana, y ningún hallazgo actúa sobre nada hasta que tú lo dices.

¿Puede cada gerente regional recibir sus propias cifras de Redshift en Excel cada lunes?

Por qué es difícil

Alguien ejecuta la consulta, la filtra por región, la pega en una plantilla y arregla el formato. Cuando esa persona no está, los archivos del lunes no salen.

Con Querri

Configura el informe una vez como proyecto. Una programación lo vuelve a ejecutar después de la sincronización y le envía a cada gerente un libro con formato que contiene solo su región. Consulta informes y automatización.

¿Qué campañas de marketing traen clientes que siguen comprando?

Por qué es difícil

Los contactos de las campañas viven en HubSpot y los pedidos repetidos viven en Redshift. La atribución se detiene en la primera compra porque unir las dos cosas no es trabajo de nadie.

Con Querri

Conecta HubSpot y Querri sigue a los contactos desde la campaña hasta sus pedidos posteriores, señalando las coincidencias que podrían estar mal. El playbook del canal a los ingresos tiene los pasos para atribuir los pedidos repetidos.

¿Puede nuestro equipo preguntarle a Claude o ChatGPT por los datos de Redshift y obtener la cifra del data warehouse?

Por qué es difícil

Un asistente apuntado directamente al clúster adivina qué significa cada columna y escribe su propio SQL. Cada prompt puede acabar con una definición distinta.

Con Querri

Agrega Querri a Claude o ChatGPT y tus tablas de Redshift sincronizadas vienen con él. Trabaja con las definiciones de la Biblioteca y se mantiene dentro de las filas que cada persona tiene permitidas en Querri, así que la tasa de retraso que preguntas en Claude es la misma del panel de operaciones.

Amazon Redshift y todo lo demás

El data warehouse rara vez tiene la historia completa

Redshift tiene los pedidos, los eventos y el uso que cargan tus pipelines. Los contratos, las facturas, las campañas y las conversaciones de soporte suelen quedarse en sus propios sistemas. Querri los mantiene uno al lado del otro en una sola Biblioteca, así que una pregunta entre sistemas no espera a otro pipeline.

Amazon Redshift combina bien con

Respuestas que puedes defender

Dos lecturas razonables de una misma pregunta, y Querri te dice cuál usó

"Los ingresos de septiembre" pueden contar los pedidos hechos en septiembre o los pedidos enviados en septiembre. Las tablas del data warehouse tienen las dos fechas, las dos lecturas son razonables y los totales difieren. Querri responde con una, la nombra y pone el otro total al lado, para que la revisión de operaciones y la de finanzas discutan sobre el negocio y no sobre la columna de fecha. Consulta cómo funcionan las respuestas.

Despierta sabiendo qué cambió

Querri revisa los datos de anoche del data warehouse antes de la reunión diaria

Después de la sincronización nocturna, Querri compara cada KPI con su propio historial y busca movimientos por los que nadie preguntó. Los hallazgos te esperan en tu Bandeja de entrada, y ninguno cambia nada hasta que lo apruebas.

Dashboards de Amazon Redshift a medida

Dashboards de Redshift que cambian cuando alguien lo pide

Di qué debe mostrar el panel de operaciones, o dale a Querri una captura del que está en la pantalla del almacén. La gente lo cambia escribiendo qué quiere distinto, sus gráficos leen de la Biblioteca que usa el chat, y un responsable regional puede quedar limitado a las filas de su región.

  • Sin capa de modelado que construir antes del primer gráfico
  • Tablas de Redshift junto a datos de CRM, finanzas y soporte
  • Un filtro de filas por persona, del dashboard a Claude
Cada cambio es una frase: di qué debe verse distinto, el dashboard te sigue y deshacer está ahí mismo.

Informes que puedes dejar de sacar a mano

Seis informes de Amazon Redshift que se ejecutan después de cada sincronización

Qué se sincroniza

El esquema que elijas, copiado según una programación

Querri copia las tablas y vistas que elijas de una base de datos y un esquema de Redshift a su propio almacenamiento, y luego responde desde esa copia en lugar de consultar Redshift en vivo. Solo puede leer lo que el usuario de base de datos con el que te conectas tiene permiso para ver.

Qué puedes sincronizar

  • Tablas
  • Vistas
  • Todas las tablas del esquema
  • Un conjunto de tablas elegido a mano
  • Tablas incrementales, por updated_at o por una columna que elijas
  • Lecturas por bloques para tablas muy grandes
  • Las bases de datos y los esquemas del sistema de Redshift no aparecen en el selector.

Completa o incremental

Actualización completa por defecto. Elige una columna como updated_at y las sincronizaciones incrementales traen solo las filas más nuevas, hasta cada hora. Una actualización completa también quita las filas eliminadas en Redshift.

Hecho para tablas grandes

Las filas se transmiten directamente a Parquet, nunca se guardan en memoria todas a la vez. Para tablas con decenas de millones de filas, un modo por bloques lee 100,000 filas a la vez y retoma donde se detuvo una sincronización fallida.

Solo lectura

Querri solo ejecuta SELECT y lecturas con cursor, además de un ajuste de sesión para los nombres que distinguen mayúsculas y minúsculas. Nunca crea, modifica ni elimina una tabla ni una fila.

Credenciales guardadas cifradas

Te conectas con un usuario y una contraseña de base de datos, guardados cifrados. SSL está activado por defecto, y a un clúster en una red privada se puede llegar mediante un túnel OpenVPN.

Cómo conectar Amazon Redshift

Un endpoint, un usuario de base de datos y una aprobación

  1. 1

    Pídeselo al Connector Agent

    Abre Connect y di "conecta nuestro Redshift", o elige Amazon Redshift en el catálogo.

  2. 2

    Introduce el endpoint

    Agrega el host del clúster, el puerto (5439 por defecto), la base de datos y el esquema. SSL sigue activado salvo que lo desactives.

  3. 3

    Agrega un usuario de base de datos

    Introduce el usuario y la contraseña; la contraseña se guarda cifrada. Un clúster en una red privada puede conectarse mediante un túnel OpenVPN.

  4. 4

    Elige las tablas y aprueba

    Toma todas las tablas del esquema o elige algunas, define cómo se sincroniza cada una y elige una programación. Nada se carga hasta que lo apruebas.

  5. 5

    Haz tu primera pregunta

    Cuando termina la primera sincronización, tus tablas de Redshift están en la Biblioteca, listas para el chat, los dashboards y los informes programados.

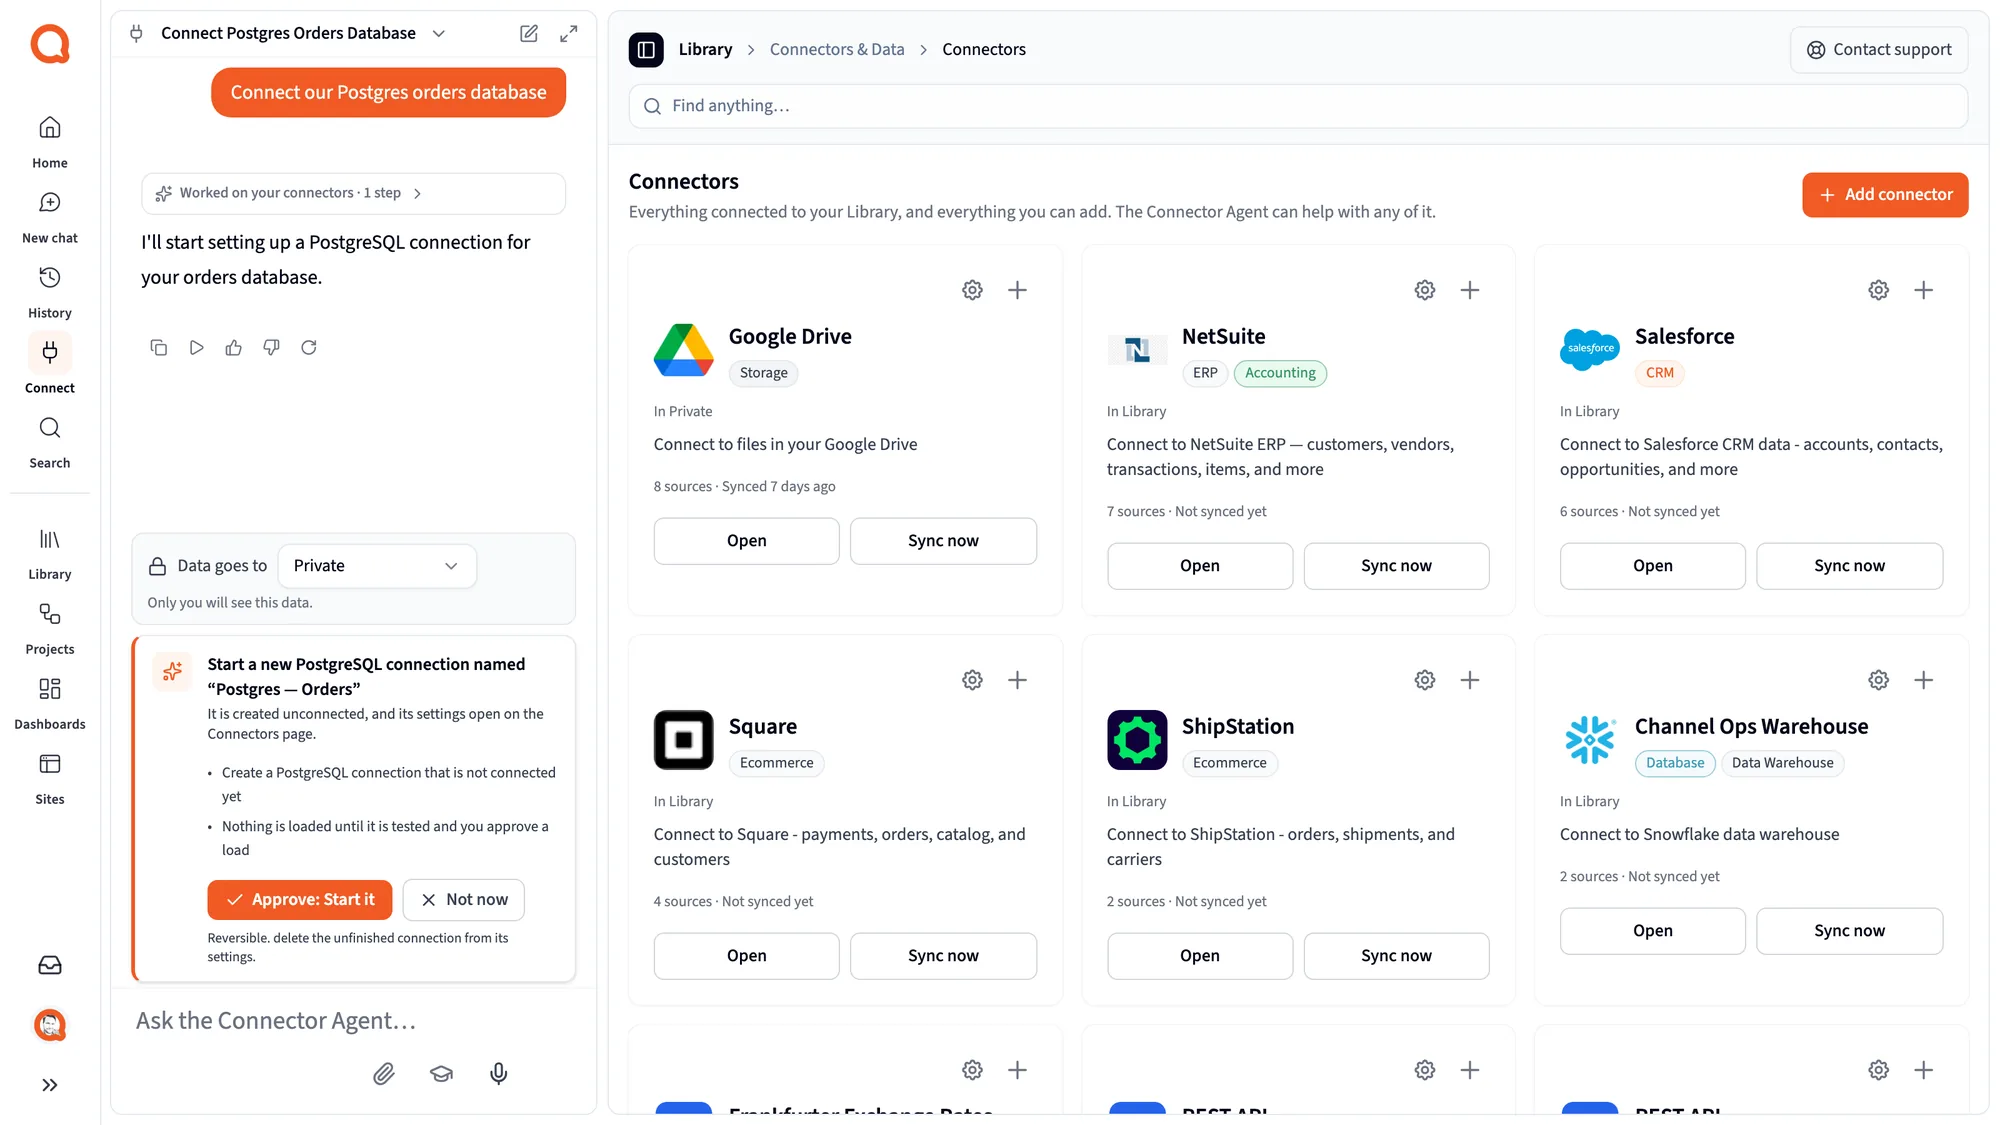
La página Connect de Querri: el Connector Agent pide aprobación antes de iniciar una conexión, junto a tarjetas de conectores de Google Drive, NetSuite, Salesforce, Square, ShipStation y Snowflake
Antes de crear cualquier conexión, el Connector Agent te pide que la apruebes.

Preguntas frecuentes sobre Amazon Redshift

Preguntas sobre Amazon Redshift y Querri

¿Cómo conecto Amazon Redshift a Querri?

Pídele al Connector Agent que conecte Redshift, o elígelo en el catálogo. Introduce el host del clúster, el puerto (5439 por defecto), la base de datos, el esquema y un usuario y una contraseña de base de datos. Luego elige todas las tablas o algunas, define una programación y aprueba. No se mueve ningún dato hasta que apruebas la carga.

¿Qué datos de Amazon Redshift sincroniza Querri?

Tablas y vistas de la base de datos y el esquema que elijas, todas o un conjunto que escoges en el selector de tablas. Las bases de datos y los esquemas del sistema de Redshift están ocultos. Querri solo puede sincronizar lo que el usuario de base de datos con el que te conectas tiene permiso para leer.

¿Cada cuánto se sincronizan los datos de Amazon Redshift?

Una actualización completa puede programarse a diario, cada semana o cada mes. Las tablas con una columna de cambios fiable, updated_at por defecto, pueden sincronizarse de forma incremental cada hora, cada día o cada semana, trayendo solo las filas posteriores a la marca de agua anterior. Hay una sincronización manual para el día en que un informe no puede esperar.

¿Querri escribe o modifica mis datos de Redshift?

No. Querri solo lee tus datos; nunca modifica tus registros. Ejecuta SELECT y lecturas con cursor, además de un ajuste de sesión que hace que los nombres de tablas y columnas distingan mayúsculas y minúsculas en esa conexión. Nunca crea, actualiza ni elimina una tabla ni una fila en Redshift.

¿Querri consulta Redshift cada vez que alguien hace una pregunta?

No. Querri responde desde su propia copia de las tablas que elegiste, actualizada según tu programación. Solo las sincronizaciones ejecutan consultas en tu clúster, así que puedes programarlas para horas tranquilas. Las respuestas son tan recientes como la última sincronización.

¿Cómo se trasladan los permisos de Redshift a Querri?

Querri solo puede leer lo que se le ha concedido al usuario de base de datos conectado, así que dale a ese usuario los esquemas y las tablas que quieres en Querri. Los permisos de Redshift no siguen a cada persona dentro de Querri; ahí, el uso compartido de Querri y un filtro de filas por persona deciden quién ve qué, por igual en el chat, los dashboards, Claude y la API.

¿Cómo combino datos de Amazon Redshift y Salesforce?

Conecta Salesforce junto a Redshift y los dos llegan a la misma Biblioteca. Querri relaciona las cuentas del data warehouse con las cuentas de Salesforce, idealmente por un ID de cuenta guardado en ambos, y dice cómo las relacionó. Luego puedes preguntar por el uso frente a contratos, renovaciones o negocios abiertos en una sola pregunta.

¿Cómo combino datos de Amazon Redshift y NetSuite?

Conecta NetSuite junto a Redshift. Querri alinea los pedidos del data warehouse con las facturas de NetSuite por número de pedido o por cliente, e indica qué campo usó. Los pedidos sin factura, o las facturas sin pedido, vuelven como una lista que puedes ir resolviendo.

¿Cómo obtengo un informe de envíos con retraso desde Amazon Redshift?

Sincroniza tus tablas de pedidos y envíos, y luego dile a Querri una sola vez qué significa con retraso, por ejemplo enviado después de la fecha prometida. Pide la tasa de retraso por centro de distribución o por transportista, fíjala en un dashboard y prográmala para que llegue cada lunes.

¿Pueden los datos de uso de Redshift alimentar una puntuación de salud del cliente?

Sincroniza las tablas de uso y conecta tu herramienta de soporte, como Intercom. Crea la puntuación una vez a partir del uso, los tickets y la facturación, y deja que los monitores nocturnos señalen las cuentas cuya puntuación baja. El playbook de puntuación de salud del cliente cubre cada paso.

¿Puedo exportar datos de Amazon Redshift a Excel automáticamente?

Sí. Guarda la extracción como proyecto y ponla en una programación. Cuando llega la última sincronización, Querri la vuelve a ejecutar y envía por correo un libro con formato, dividido en un archivo por región o destinatario si lo pides. Nadie exporta desde query editor v2 ni sortea su límite de descarga de 5 MB.

¿Puedo crear dashboards de Amazon Redshift a medida sin SQL?

Sí. Describe el panel en una frase, o parte de una captura de un dashboard en el que tu equipo ya confía. Las ediciones son peticiones en lenguaje natural, los gráficos pueden poner tablas del data warehouse junto a datos de CRM y ERP, y un filtro de filas limita a cada persona a su parte.

¿Puedo preguntarle a ChatGPT o a Claude por mis datos de Amazon Redshift?

Sí, mediante la conexión MCP de Querri. Claude o ChatGPT lee entonces las tablas de Redshift sincronizadas a través de tu Biblioteca, aplica las definiciones que dejaste escritas y ve solo las filas que esa persona puede ver en Querri. No escribe SQL nuevo contra el clúster, así que su tasa de retraso coincide con la del dashboard.

¿Querri puede iniciar sesión en Redshift con IAM o AWS SSO?

Hoy no. El conector usa un usuario y una contraseña de base de datos de Redshift, que Querri guarda cifrados. No usa roles de IAM, credenciales temporales ni AWS SSO. Crea un usuario de base de datos dedicado con acceso de lectura a los esquemas que quieres en Querri.

¿Querri puede llegar a un clúster de Redshift en una red privada?

Sí, mediante el ajuste opcional de VPN. Proporcionas un archivo de configuración de OpenVPN con su CA, certificado y clave, todos guardados cifrados, y Querri se conecta a través de ese túnel. Esto cubre los clústeres a los que solo se puede llegar desde dentro de tu VPC, por ejemplo detrás de PrivateLink.

¿Cómo maneja Querri las tablas muy grandes de Redshift?

Las filas se transmiten directamente a Parquet, así que una tabla nunca se guarda entera en memoria. Para tablas de decenas de millones de filas, un modo por bloques lee en lotes ordenados, de 100,000 filas por defecto, guarda cada lote al terminarlo y retoma desde el último si una sincronización falla.

¿Cuáles son los límites del conector de Amazon Redshift?

Cada conexión lee una base de datos y un esquema. Las sincronizaciones incrementales omiten las filas cuya columna de cursor es NULL, así que elige una columna que siempre esté llena. Las sincronizaciones incrementales no ven las eliminaciones hasta la siguiente actualización completa. Con SSL activado el tráfico va cifrado, pero el certificado del servidor no se verifica.

¿Mis datos de Amazon Redshift están seguros en Querri?

Sí. Querri cuenta con las certificaciones SOC 2 Type II, HIPAA e ISO 27001:2022. La contraseña de tu base de datos y cualquier clave de VPN se guardan cifradas, Querri solo lee de Redshift y tus datos nunca se usan para entrenar un modelo.

Deja que operaciones, finanzas y CS le pregunten a Redshift por su cuenta.

Conéctate con un endpoint y un usuario de base de datos. Querri lee de Redshift y deja cada tabla tal como la encontró.