Zum Inhalt springen

Amazon Redshift + Querri

Amazon Redshift-Analysen,ohne Ticket in der Warteschlange der Analysten.

Operations-, Finanz- und Kundenteams fragen das Data Warehouse in einfachen Worten und erhalten Antworten, die Ihre Definitionen verwenden. Querri kopiert die Redshift-Tabellen Ihrer Wahl nach Zeitplan, sodass ihre Fragen die Warteschlange auf Ihrem Cluster nicht verlängern.

Querri liest aus Redshift nur und ändert nie eine Tabelle oder Zeile. Ihr Datenbankpasswort wird verschlüsselt gespeichert. Zertifiziert nach SOC 2 Type II, HIPAA und ISO 27001:2022.

Warum Amazon Redshift-Reporting schwierig wird

Redshift enthält die Historie. Das Geschäft wartet trotzdem in der Schlange darauf.

AWS-Teams stellen Redshift aus guten Gründen ins Zentrum. Die Verzögerungen entstehen drumherum: wer die Abfrage schreiben kann, in welcher Warteschlange sie landet, was das Nachsehen kostet und wo das Ergebnis endet.

01

Eine Frage braucht jemanden, der das Schema kennt

Query Editor v2 ist ein SQL-Editor, und die Tabellen sind nach den Pipelines benannt, die sie befüllen. Die Frage einer Filialleitung wird zur Anfrage, und die Anfrage reiht sich in einen Rückstand ein, den das Datenteam schon jetzt nicht abarbeiten kann.

02

Ad-hoc-Abfragen teilen sich Warteschlangen mit ETL und Dashboards

Abfragen warten auf einen freien WLM-Slot. Mit manuellem WLM haben alle Benutzer-Warteschlangen zusammen höchstens 50 Slots, und die Standard-Warteschlange führt fünf gleichzeitig aus. Ein neugieriger Analyst kann das morgendliche Laden ausbremsen.

03

Beim Erkunden läuft der Zähler

Redshift Serverless rechnet Rechenleistung sekundengenau ab, mit einem Minimum von 60 Sekunden, und eine abgebrochene Abfrage wird trotzdem für ihre Laufzeit berechnet. Auf einem bereitgestellten Cluster heißt mehr Erkunden: größer dimensionieren oder für Concurrency Scaling bezahlen.

04

Was eine Zahl bedeutet, steht außerhalb von Redshift

Nettoumsatz, ein aktiver Kunde, eine verspätete Bestellung: Die Definitionen stecken in dbt-Modellen, in der BI-Schicht oder im Kopf eines Analysten. Die Tabelle des Operations-Teams nutzt eine leicht andere Version, und niemand merkt es.

05

Ergebnisse gehen als CSV hinaus und laufen auseinander

Query Editor v2 begrenzt ein heruntergeladenes Ergebnis auf 5 MB, also laufen größere Abzüge über UNLOAD nach S3 oder werden von Hand aufgeteilt. Sobald die Datei in Excel ist, wird sie nie wieder aktualisiert.

Was Sie endlich beantworten können

Acht Amazon Redshift-Fragen, die nicht mehr auf einen Data Engineer warten

Jede stammt von Teams, die auf AWS arbeiten: was sie fragen, warum es heute bei Redshift hängen bleibt und was Querri damit macht.

Kann Operations Antworten zu Bestellungen und Lieferungen aus Redshift bekommen, ohne SQL zu lernen?

Warum es schwierig ist

Die Antwort ist ein Join über Bestell-, Versand- und Lagertabellen, deren Namen nur der Autor der Pipeline kennt. Operations wartet Tage auf etwas, das einen Analysten zehn Minuten kostet.

Mit Querri

Querri kopiert die Tabellen Ihrer Wahl in die Bibliothek, und jeder mit Zugriff fragt im Chat. Jede Antwort listet die Schritte auf, die sie genommen hat, sodass das Datenteam prüft, statt zu schreiben.

Was bedeutet Nettoumsatz nach Retouren, Rabatten und Stornierungen?

Warum es schwierig ist

Jeder, der SQL schreibt, behandelt Retouren und Teilerstattungen ein wenig anders. Finanzen, Operations und die Präsentation für den Vorstand haben am Ende drei Nettoumsätze, die alle aus Redshift stammen.

Mit Querri

Legen Sie die Regel einmal in Fakten und Regeln fest und verfolgen Sie den Nettoumsatz als KPI. Chat, Dashboards und geplante Berichte wenden ab dann alle dieselbe Definition an.

Stimmen die Bestellungen in Redshift mit dem überein, was die Finanzabteilung in NetSuite fakturiert hat?

Warum es schwierig ist

Bestellpositionen kommen aus der App ins Data Warehouse; Rechnungen liegen im ERP. Sie abzugleichen, heißt jeden Monat ein Export, ein Abgleich über Bestellnummern und eine lange Liste von Ausnahmen.

Mit Querri

Verbinden Sie NetSuite neben Redshift, und Querri ordnet Bestellungen Rechnungen zu und sagt, über welches Feld. Die Bestellungen ohne Rechnung kommen als Liste zurück, nicht als Summe.

Welche Kunden rutschen ab, gemessen an Produktnutzung und Supporttickets zusammen?

Warum es schwierig ist

Nutzungs-Events liegen in Redshift, Gespräche im Support-Tool. Ein Health Score, der beides nutzt, bedeutet meist den Kauf einer CS-Plattform oder ein Nebenprojekt, das nie fertig wird.

Mit Querri

Holen Sie Intercom in dieselbe Bibliothek und bauen Sie den Score einmal. Das Playbook zum Kunden-Health-Score zeigt die Schritte.

Bei welcher Produktkategorie ist die Retourenquote über Nacht gesprungen?

Warum es schwierig ist

Die Retourendaten sind morgens in Redshift, aber niemand führt jeden Tag eine Abfrage für jede Kategorie aus. Ein Ausreißer fällt auf, wenn die Erstattungssumme im Monatsabschluss auftaucht.

Mit Querri

Nächtliche Monitore vergleichen jede Kategorie mit ihrer eigenen Historie, mit einfacher Arithmetik. Eine Kategorie, die aus ihrem Muster ausbricht, steht morgens in Ihrem Posteingang, und kein Befund löst etwas aus, bevor Sie es sagen.

Kann jede Regionalleitung jeden Montag ihre eigenen Redshift-Zahlen in Excel bekommen?

Warum es schwierig ist

Jemand führt die Abfrage aus, filtert sie pro Region, fügt sie in eine Vorlage ein und korrigiert die Formatierung. Fällt diese Person aus, gehen die Montagsdateien nicht raus.

Mit Querri

Richten Sie den Bericht einmal als Projekt ein. Ein Zeitplan führt ihn nach der Synchronisierung erneut aus und sendet jeder Führungskraft eine formatierte Arbeitsmappe nur mit ihrer Region. Siehe Berichte und Automatisierung.

Welche Marketingkampagnen bringen Kunden, die immer wieder bestellen?

Warum es schwierig ist

Kampagnenkontakte liegen in HubSpot, Folgebestellungen in Redshift. Die Attribution endet beim ersten Kauf, weil es niemandes Aufgabe ist, beides zu verknüpfen.

Mit Querri

Verbinden Sie HubSpot, und Querri verfolgt Kontakte von der Kampagne bis zu ihren späteren Bestellungen und vermerkt Zuordnungen, die falsch sein könnten. Das Playbook vom Kanal zum Umsatz enthält die Schritte für die Attribution von Folgebestellungen.

Kann unser Team Claude oder ChatGPT nach Redshift-Daten fragen und die Zahl aus dem Data Warehouse bekommen?

Warum es schwierig ist

Ein Assistent, der direkt auf den Cluster zeigt, rät, was jede Spalte bedeutet, und schreibt sein eigenes SQL. Jeder Prompt kann bei einer anderen Definition landen.

Mit Querri

Fügen Sie Querri zu Claude oder ChatGPT hinzu, und Ihre synchronisierten Redshift-Tabellen kommen mit. Der Assistent arbeitet mit den Definitionen der Bibliothek und bleibt innerhalb der Zeilen, die jede Person in Querri sehen darf, sodass die in Claude erfragte Verspätungsquote die Verspätungsquote auf dem Operations-Board ist.

Amazon Redshift und der Rest

Das Data Warehouse enthält selten die ganze Geschichte

Redshift hat die Bestellungen, Events und Nutzungsdaten, die Ihre Pipelines laden. Verträge, Rechnungen, Kampagnen und Supportgespräche bleiben oft in ihren eigenen Systemen. Querri hält alles nebeneinander in einer Bibliothek, sodass eine systemübergreifende Frage nicht auf eine weitere Pipeline wartet.

Amazon Redshift passt gut zu

Antworten, für die Sie einstehen können

Zwei faire Lesarten einer Frage, und Querri sagt Ihnen, welche es verwendet hat

„Umsatz im September“ kann im September aufgegebene oder im September versendete Bestellungen zählen. Die Tabellen im Data Warehouse enthalten beide Datumsangaben, beides ist vernünftig, und die Summen unterscheiden sich. Querri antwortet mit einer Lesart, benennt sie und stellt die andere Summe daneben, damit im Operations- und im Finanz-Review über das Geschäft diskutiert wird statt über die Datumsspalte. Siehe wie Antworten funktionieren.

Morgens sehen, was sich geändert hat

Querri geht die Daten der letzten Nacht vor dem Standup durch

Nach der nächtlichen Synchronisierung prüft Querri jeden KPI an seiner eigenen Historie und sucht nach Bewegungen, nach denen niemand gefragt hat. Die Befunde warten in Ihrem Posteingang, und keiner davon ändert etwas, bevor Sie zustimmen.

Eigene Amazon Redshift-Dashboards

Redshift-Dashboards, die sich ändern, wenn jemand fragt

Sagen Sie, was das Operations-Board zeigen soll, oder geben Sie Querri einen Screenshot des Boards, das auf dem Bildschirm in der Lagerhalle läuft. Wer etwas anders haben möchte, tippt es einfach ein, die Diagramme greifen auf die Bibliothek zu, die auch der Chat nutzt, und eine Regionalleitung lässt sich auf die Zeilen ihrer Region beschränken.

  • Keine Modellierungsschicht, bevor das erste Diagramm entsteht
  • Redshift-Tabellen neben CRM-, Finanz- und Supportdaten
  • Ein Zeilenfilter pro Person, vom Dashboard bis zu Claude
Jede Änderung ist ein Satz: Sagen Sie, was anders aussehen soll, das Dashboard folgt, und Rückgängigmachen ist gleich zur Hand.

Berichte, die Sie nicht mehr von Hand abziehen müssen

Sechs Amazon Redshift-Berichte, die nach jeder Synchronisierung laufen

Was übertragen wird

Das Schema Ihrer Wahl, nach Zeitplan kopiert

Querri kopiert die Tabellen und Views Ihrer Wahl aus einer Redshift-Datenbank und einem Schema in seinen eigenen Speicher und antwortet dann aus dieser Kopie, statt Redshift live abzufragen. Es kann nur lesen, was der Datenbankbenutzer, mit dem Sie verbinden, sehen darf.

Was Sie synchronisieren können

  • Tabellen
  • Views
  • Alle Tabellen des Schemas
  • Eine handverlesene Auswahl von Tabellen
  • Inkrementelle Tabellen, anhand von updated_at oder einer Spalte Ihrer Wahl
  • Lesen in Blöcken für sehr große Tabellen
  • Die Systemdatenbanken und -schemas von Redshift sind in der Auswahl ausgeblendet.

Vollständig oder inkrementell

Standardmäßig vollständige Aktualisierung. Wählen Sie eine Spalte wie updated_at, und inkrementelle Synchronisierungen holen nur neuere Zeilen, bis zu stündlich. Eine vollständige Aktualisierung entfernt auch Zeilen, die in Redshift gelöscht wurden.

Für große Tabellen gemacht

Zeilen werden direkt nach Parquet gestreamt und nie alle auf einmal im Arbeitsspeicher gehalten. Für Tabellen mit zig Millionen Zeilen liest ein Blockmodus jeweils 100.000 Zeilen und setzt dort fort, wo eine fehlgeschlagene Synchronisierung aufgehört hat.

Nur lesend

Querri führt nur SELECT- und Cursor-Lesevorgänge aus, dazu eine Sitzungseinstellung für Namen mit Groß- und Kleinschreibung. Es legt nie eine Tabelle oder Zeile an, ändert oder löscht sie.

Zugangsdaten verschlüsselt gespeichert

Sie verbinden sich mit Benutzername und Passwort eines Datenbankbenutzers, verschlüsselt gespeichert. SSL ist standardmäßig aktiviert, und ein Cluster in einem privaten Netzwerk lässt sich über einen OpenVPN-Tunnel erreichen.

So verbinden Sie Amazon Redshift

Ein Endpunkt, ein Datenbankbenutzer und eine Bestätigung

  1. 1

    Den Connector Agent fragen

    Öffnen Sie Connect und sagen Sie „Verbinde unser Redshift“, oder wählen Sie Amazon Redshift aus dem Katalog.

  2. 2

    Den Endpunkt eingeben

    Tragen Sie Cluster-Host, Port (standardmäßig 5439), Datenbank und Schema ein. SSL bleibt aktiviert, sofern Sie es nicht ausschalten.

  3. 3

    Einen Datenbankbenutzer hinzufügen

    Geben Sie Benutzername und Passwort ein; das Passwort wird verschlüsselt gespeichert. Ein Cluster in einem privaten Netzwerk kann sich über einen OpenVPN-Tunnel verbinden.

  4. 4

    Tabellen auswählen und bestätigen

    Übernehmen Sie alle Tabellen des Schemas oder wählen Sie einige aus, legen Sie fest, wie jede synchronisiert wird, und wählen Sie einen Zeitplan. Nichts wird geladen, bevor Sie bestätigen.

  5. 5

    Die erste Frage stellen

    Wenn die erste Synchronisierung fertig ist, liegen Ihre Redshift-Tabellen in der Bibliothek, bereit für Chat, Dashboards und geplante Berichte.

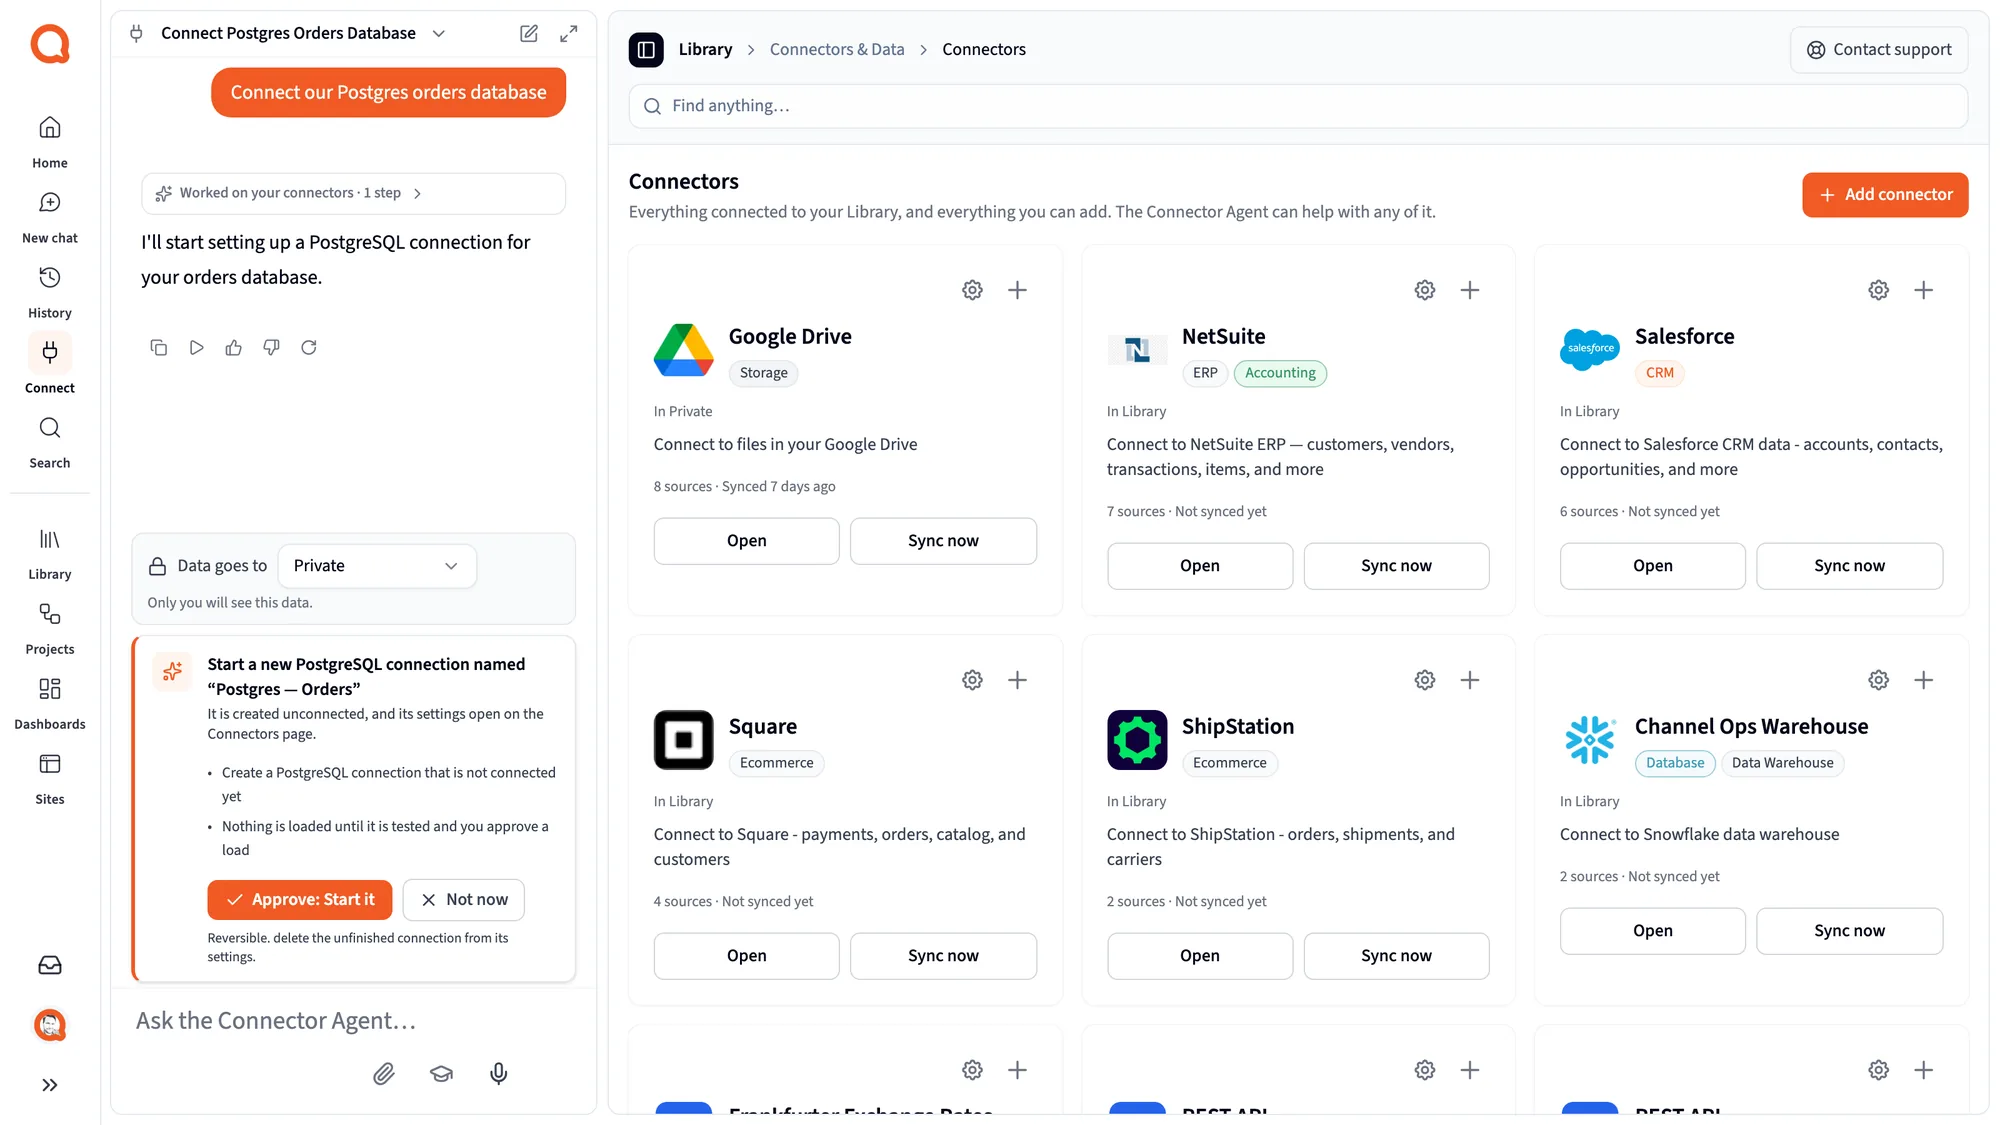
Die Connect-Seite von Querri: Der Connector Agent bittet um Bestätigung, bevor er eine Verbindung startet, neben Connector-Karten für Google Drive, NetSuite, Salesforce, Square, ShipStation und Snowflake
Bevor eine Verbindung angelegt wird, bittet der Connector Agent Sie um Bestätigung.

Amazon Redshift-FAQ

Fragen zu Amazon Redshift und Querri

Wie verbinde ich Amazon Redshift mit Querri?

Bitten Sie den Connector Agent, Redshift zu verbinden, oder wählen Sie es aus dem Katalog. Geben Sie Cluster-Host, Port (standardmäßig 5439), Datenbank, Schema sowie Benutzername und Passwort eines Datenbankbenutzers ein. Wählen Sie dann alle Tabellen oder einige aus, legen Sie einen Zeitplan fest und bestätigen Sie. Keine Daten werden übertragen, bevor Sie das Laden bestätigen.

Welche Amazon Redshift-Daten synchronisiert Querri?

Tabellen und Views aus der Datenbank und dem Schema Ihrer Wahl, entweder alle oder eine Auswahl, die Sie in der Tabellenauswahl treffen. Die Systemdatenbanken und -schemas von Redshift sind ausgeblendet. Querri kann nur synchronisieren, was der Datenbankbenutzer, mit dem Sie verbinden, lesen darf.

Wie oft werden Amazon Redshift-Daten synchronisiert?

Eine vollständige Aktualisierung lässt sich täglich, wöchentlich oder monatlich einstellen. Tabellen mit einer verlässlichen Änderungsspalte, standardmäßig updated_at, können stündlich, täglich oder wöchentlich inkrementell synchronisieren und holen nur Zeilen jenseits des vorherigen Höchststands. Eine manuelle Synchronisierung steht für den Tag bereit, an dem ein Bericht nicht warten kann.

Schreibt Querri in meine Redshift-Daten oder ändert es sie?

Nein. Querri liest Ihre Daten nur; es ändert Ihre Datensätze nie. Es führt SELECT- und Cursor-Lesevorgänge aus, dazu eine Sitzungseinstellung, die Tabellen- und Spaltennamen für diese Verbindung case-sensitiv macht. Es legt in Redshift nie eine Tabelle oder Zeile an, aktualisiert oder löscht sie.

Fragt Querri Redshift bei jeder Frage ab, die jemand stellt?

Nein. Querri antwortet aus seiner eigenen Kopie der Tabellen Ihrer Wahl, aktualisiert nach Ihrem Zeitplan. Nur Synchronisierungen führen Abfragen auf Ihrem Cluster aus, Sie können sie also für ruhige Stunden planen. Die Antworten sind so aktuell wie die letzte Synchronisierung.

Wie werden Redshift-Berechtigungen in Querri übernommen?

Querri kann nur lesen, wofür der verbundene Datenbankbenutzer Rechte hat, geben Sie diesem Benutzer also die Schemas und Tabellen, die Sie in Querri haben möchten. Redshift-Berechtigungen folgen einzelnen Personen nicht in Querri; dort bestimmen Querris eigene Freigaben und ein Zeilenfilter pro Person, wer was sieht, im Chat, in Dashboards, in Claude und in der API gleichermaßen.

Wie kombiniere ich Daten aus Amazon Redshift und Salesforce?

Verbinden Sie Salesforce neben Redshift, und beides landet in derselben Bibliothek. Querri ordnet Accounts aus dem Data Warehouse Salesforce-Accounts zu, am besten über eine Account-ID, die in beiden gespeichert ist, und sagt, wie es zugeordnet hat. Dann können Sie in einer einzigen Frage nach Nutzung im Vergleich zu Verträgen, Verlängerungen oder offenen Deals fragen.

Wie kombiniere ich Daten aus Amazon Redshift und NetSuite?

Verbinden Sie NetSuite neben Redshift. Querri stellt Bestellungen aus dem Data Warehouse über Bestellnummer oder Kunde NetSuite-Rechnungen gegenüber und gibt an, welches Feld es verwendet hat. Bestellungen ohne Rechnung oder Rechnungen ohne Bestellung kommen als Liste zurück, die Sie abarbeiten können.

Wie erhalte ich aus Amazon Redshift einen Bericht zu verspäteten Lieferungen?

Synchronisieren Sie Ihre Bestell- und Versandtabellen und sagen Sie Querri einmal, was verspätet bedeutet, zum Beispiel nach dem zugesagten Datum versendet. Fragen Sie nach der Verspätungsquote nach Fulfillment-Center oder Versanddienstleister, heften Sie sie an ein Dashboard und planen Sie den Versand jeden Montag.

Können Nutzungsdaten aus Redshift in einen Kunden-Health-Score einfließen?

Synchronisieren Sie die Nutzungstabellen und verbinden Sie Ihr Support-Tool, etwa Intercom. Bauen Sie den Score einmal aus Nutzung, Tickets und Abrechnung, und lassen Sie dann nächtliche Monitore Accounts markieren, deren Score sinkt. Das Playbook zum Kunden-Health-Score deckt jeden Schritt ab.

Kann ich Amazon Redshift-Daten automatisch nach Excel exportieren?

Ja. Speichern Sie den Abzug als Projekt und legen Sie einen Zeitplan fest. Sobald die neueste Synchronisierung da ist, führt Querri ihn erneut aus und sendet eine formatierte Arbeitsmappe, auf Wunsch aufgeteilt in eine Datei pro Region oder Empfänger. Niemand exportiert mehr aus Query Editor v2 oder umgeht dessen Download-Grenze von 5 MB.

Kann ich eigene Amazon Redshift-Dashboards ohne SQL erstellen?

Ja. Beschreiben Sie das Board in einem Satz, oder starten Sie mit einem Screenshot eines Dashboards, auf das sich Ihr Team bereits verlässt. Änderungen sind Anfragen in einfachen Worten, Diagramme können Tabellen aus dem Data Warehouse neben CRM- und ERP-Daten stellen, und ein Zeilenfilter beschränkt jeden Betrachter auf seinen Ausschnitt.

Kann ich ChatGPT oder Claude nach meinen Amazon Redshift-Daten fragen?

Ja, über die MCP-Verbindung von Querri. Claude oder ChatGPT liest dann die synchronisierten Redshift-Tabellen über Ihre Bibliothek, wendet die Definitionen an, die Sie festgehalten haben, und sieht nur die Zeilen, die diese Person in Querri sehen darf. Es schreibt kein neues SQL gegen den Cluster, daher stimmt seine Verspätungsquote mit der des Dashboards überein.

Kann sich Querri mit IAM oder AWS SSO bei Redshift anmelden?

Derzeit nicht. Der Connector nutzt Benutzername und Passwort eines Redshift-Datenbankbenutzers, die Querri verschlüsselt speichert. IAM-Rollen, temporäre Zugangsdaten oder AWS SSO werden nicht genutzt. Legen Sie einen eigenen Datenbankbenutzer mit Lesezugriff auf die Schemas an, die Sie in Querri haben möchten.

Kann Querri einen Redshift-Cluster in einem privaten Netzwerk erreichen?

Ja, über die optionale VPN-Einstellung. Sie stellen eine OpenVPN-Konfigurationsdatei mit CA, Zertifikat und Schlüssel bereit, alles verschlüsselt gespeichert, und Querri verbindet sich durch diesen Tunnel. Das deckt Cluster ab, die nur innerhalb Ihrer VPC erreichbar sind, zum Beispiel hinter PrivateLink.

Wie geht Querri mit sehr großen Redshift-Tabellen um?

Zeilen werden direkt nach Parquet gestreamt, eine Tabelle wird also nie auf einmal im Arbeitsspeicher gehalten. Für Tabellen mit zig Millionen Zeilen liest ein Blockmodus in geordneten Stapeln, standardmäßig 100.000 Zeilen, speichert jeden Stapel, sobald er fertig ist, und setzt beim letzten fort, wenn eine Synchronisierung fehlschlägt.

Welche Grenzen hat der Amazon Redshift-Connector?

Jede Verbindung liest eine Datenbank und ein Schema. Inkrementelle Synchronisierungen überspringen Zeilen, deren Cursor-Spalte NULL ist, wählen Sie also eine Spalte, die immer gefüllt ist. Inkrementelle Synchronisierungen sehen Löschungen erst bei der nächsten vollständigen Aktualisierung. Mit aktiviertem SSL ist der Datenverkehr verschlüsselt, das Serverzertifikat wird aber nicht verifiziert.

Sind meine Amazon Redshift-Daten in Querri sicher?

Ja. Querri ist nach SOC 2 Type II, HIPAA und ISO 27001:2022 zertifiziert. Ihr Datenbankpasswort und alle VPN-Schlüssel werden verschlüsselt gespeichert, Querri liest aus Redshift nur, und Ihre Daten werden nie zum Trainieren eines Modells verwendet.

Lassen Sie Operations, Finanzen und Customer Success Redshift selbst fragen.

Verbinden Sie sich mit einem Endpunkt und einem Datenbankbenutzer. Querri liest aus Redshift und lässt jede Tabelle so, wie es sie vorgefunden hat.