डेटा ऑडिट और Janitor
ऑटोमैटिक डेटा क्लीनिंग
यह ढूँढता है कि आपके डेटा में क्या गड़बड़ है। फिर आपके साथ मिलकर उसे साफ़ करता है।
हर टेबल के आते ही उस पर 180 से ज़्यादा जाँचें। डेटा ऑडिट अपनी खोजों को इस हिसाब से क्रम देता है कि वे किन जवाबों पर असर डालती हैं, और Janitor आपसे सिर्फ़ वही फ़ैसले पूछता है जो सिर्फ़ आप ले सकते हैं। फिर वह एक साफ़ व्यू बनाता है, जिसे हर जवाब इस्तेमाल करता है।
एजेंटिक डेटा क्लीनिंग
मिलिए अपने Janitor से
इस तालिका को साफ़ करें दबाइए और Janitor काम पर लग जाता है। वह पढ़ता है कि डेटा ऑडिट ने क्या पाया, हर सुधार को आपकी अपनी पंक्तियों पर आज़माता है, और सिर्फ़ उन फ़ैसलों पर रुकता है जो वह अकेले नहीं ले सकता। यही एजेंटिक डेटा क्लीनिंग है: काम एजेंट करता है, और किसी संख्या को बदलने वाले फ़ैसले आप लेते हैं।
-
इसे किसी टेबल या नोट पर शुरू कीजिए
किसी टेबल पर इस तालिका को साफ़ करें दबाइए, या किसी एक नोट पर Janitor से पूछें। ऑडिट ने जो सबूत मापे हैं, वे उसके पास पहले से होते हैं।
-
वह सिर्फ़ वही पूछता है जो आपके तय करने का है
महीना पहले या दिन पहले? कौन सा करेंसी कॉलम मान्य होगा? कौन सी डुप्लिकेट पंक्ति रहेगी? हर सवाल एक चॉइस कार्ड के रूप में आता है, जिसमें उसकी सिफ़ारिश सबसे पहले होती है।
-
वह आपको योजना दिखाता है
एक रिव्यू कार्ड हर सुधार की सूची देता है और बताता है कि क्या जैसा है वैसा रहेगा। जब तक आप साफ़ व्यू बनाएँ नहीं दबाते, कुछ भी नहीं बनता।
-
आपको एक साफ़ व्यू मिलता है
नतीजा एक नया व्यू है जिसे आप खोल सकते हैं, और टेबल के कार्ड पर उसके नाम के साथ "के रूप में साफ़ की गई" लिखा आता है। मूल डेटा ठीक वैसा ही रहता है जैसा आया था।
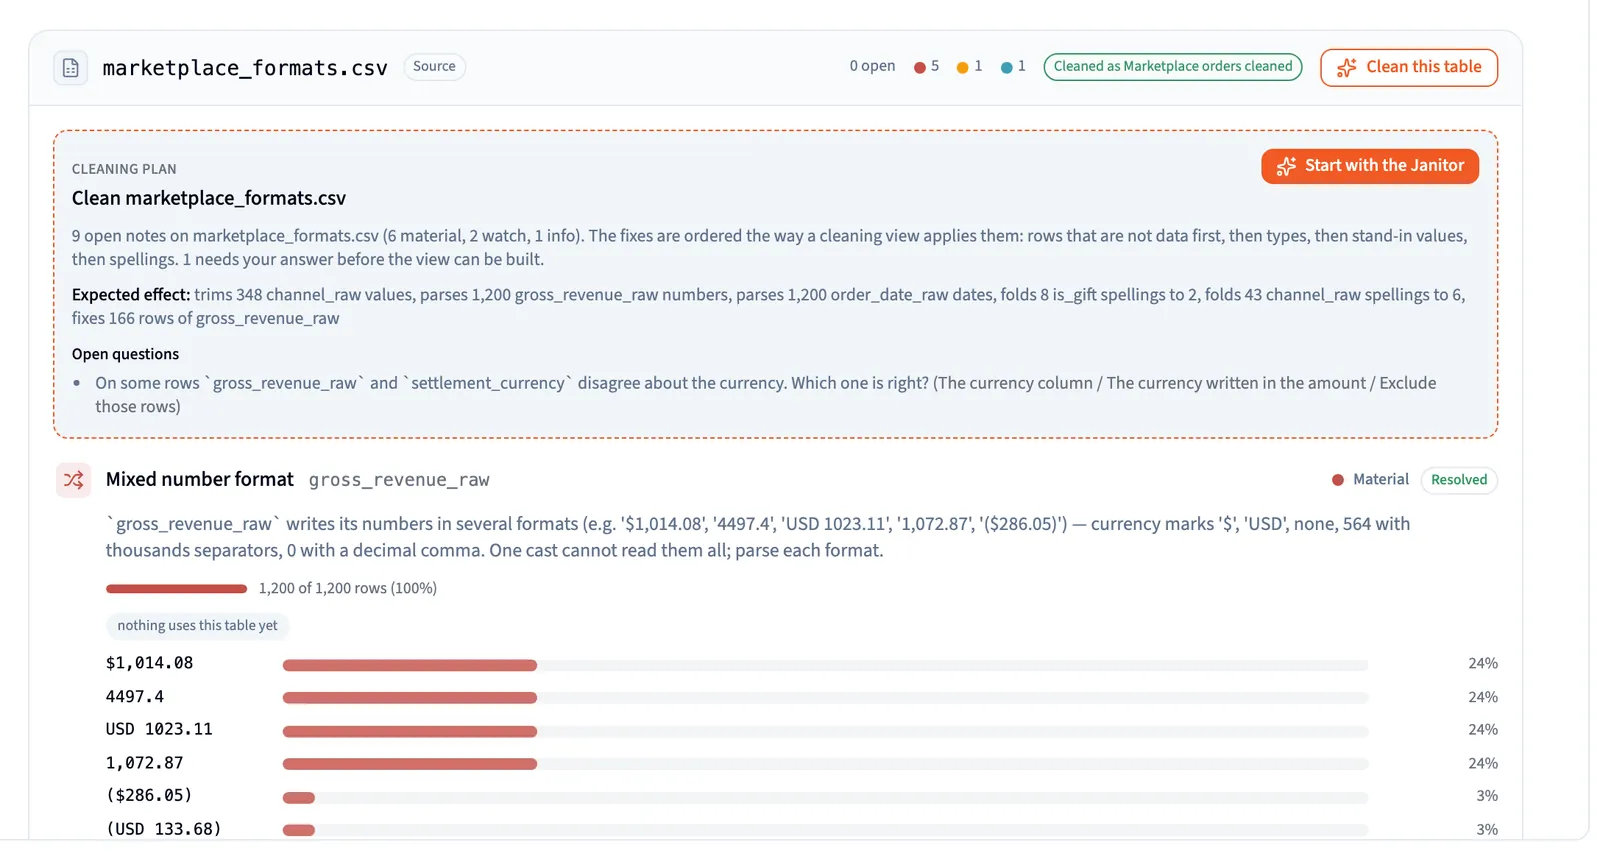
बिना आवाज़ की एक रिकॉर्डिंग। Janitor से मार्केटप्लेस ऑर्डर की एक फ़ाइल साफ़ करने को कहा जाता है। वह तीन सवाल चॉइस कार्ड के रूप में पूछता है, हर एक में उसकी सिफ़ारिश सबसे पहले: तारीख़ों में महीना पहले है या दिन, कौन सा करेंसी कॉलम मान्य होगा, और कौन सी डुप्लिकेट पंक्ति रखी जाए। वह हर सुधार की सूची वाला एक रिव्यू कार्ड दिखाता है, व्यू बनता है, और उसके बाद टेबल पर Marketplace orders, cleaned के रूप में साफ़ की गई लिखा आता है।
ऑटोमैटिक डेटा क्वालिटी
डेटा ऑडिट: हर टेबल के आते ही उस पर 180 से ज़्यादा जाँचें
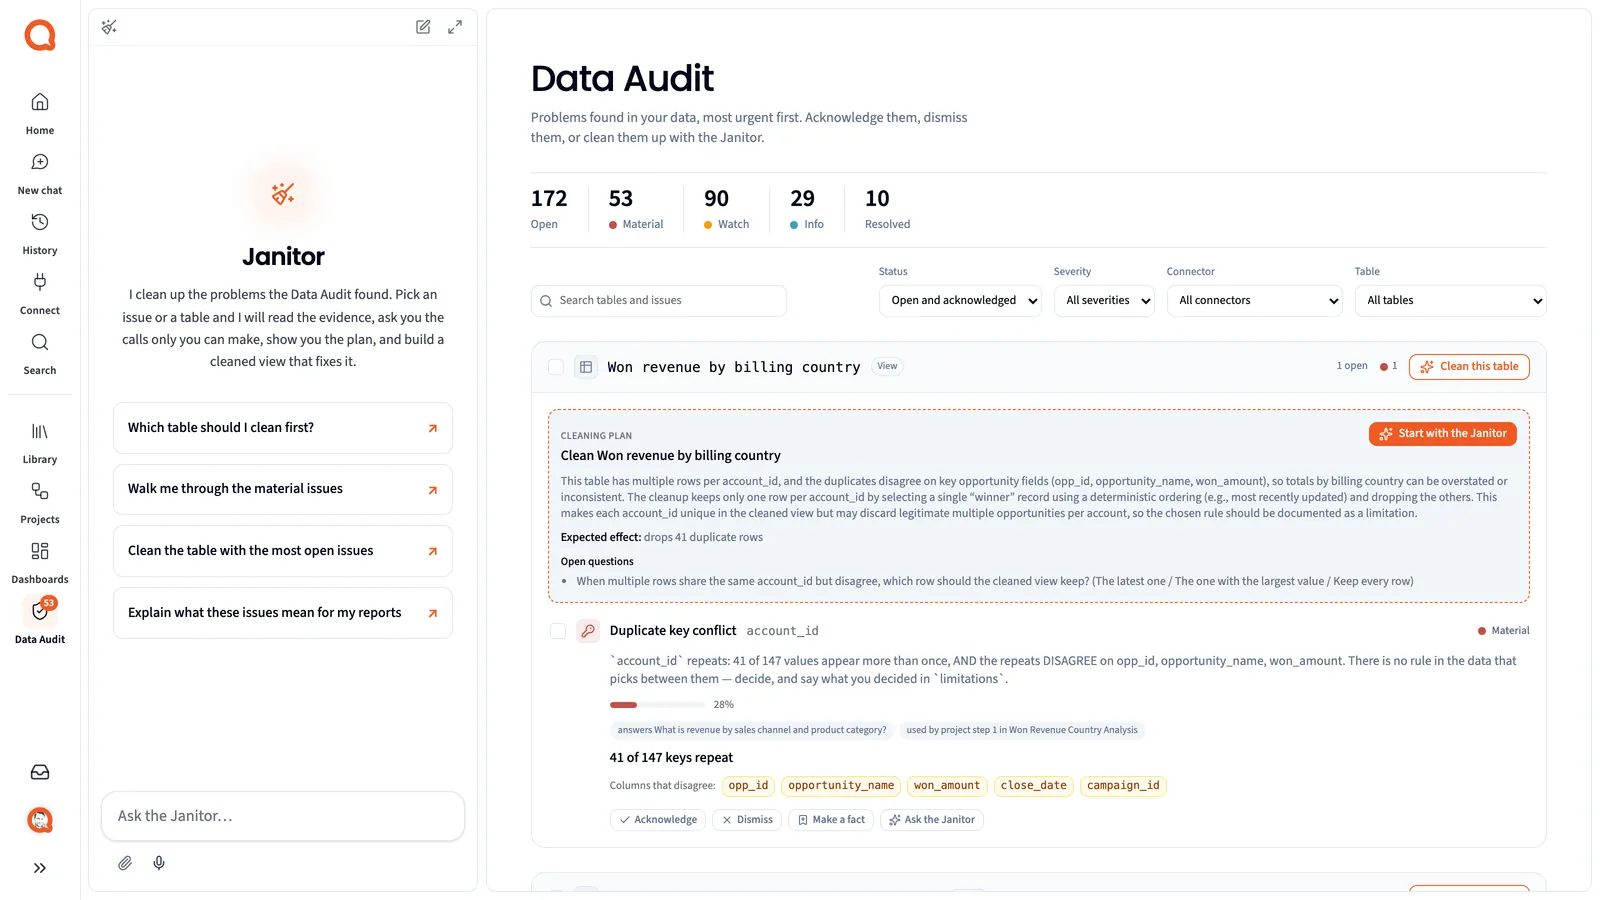
आप जो भी टेबल अपलोड या कनेक्ट करते हैं, वह आते ही जाँची जाती है, किसी के सवाल पूछने से पहले, और हर व्यू बनते समय जाँचा जाता है। यह उन समस्याओं को ढूँढता है जिन्हें लोग ढूँढना जानते हैं, और उन्हें भी जिनके बारे में कोई सोचता तक नहीं। जो कुछ मिलता है वह एक पेज पर आता है, डेटा ऑडिट पर, सबसे ज़रूरी सबसे पहले, और हर समस्या के साथ यह भी कि वह क्यों मायने रखती है।
जाँचें किन चीज़ों को ढूँढती हैं
भेस बदले ख़ाली मान
टेक्स्ट के रूप में सहेजे गए N/A, डैश या ख़ाली मान, अनजान तारीख़ की जगह 1900-01-01, अनजान उम्र की जगह 999।
टेक्स्ट के रूप में सहेजी गई संख्याएँ और तारीख़ें
$, € या कॉमा वाली रकमें, कोष्ठक में ऋणात्मक संख्याएँ, एक कॉलम में दो संख्या फ़ॉर्मेट या कई तारीख़ फ़ॉर्मेट, तारीख़ बनकर बैठे Excel सीरियल नंबर।
वर्तनी और नाम
Retail, retail और RETAIL को तीन चैनल गिनना, हाँ/ना को छह तरह से लिखना, एक ही आईडी के कई नाम।
डुप्लिकेट और कीज़
हूबहू दोहराई गई पंक्तियाँ, दोहराई जाने वाली कीज़, और ऐसी कीज़ जो दोहराई जाती हैं और संख्याओं पर एक-दूसरे से मेल नहीं खातीं।
ऐसे मान जो सही नहीं हो सकते
ऋणात्मक मात्राएँ, 100 से ऊपर प्रतिशत, भविष्य की तारीख़ें, ऐसा टोटल जो अपने हिस्सों का जोड़ नहीं है।
स्प्रेडशीट की बनावट
डेटा के बीच टोटल वाली पंक्तियाँ, फ़ाइल के बीच दोहराए गए हेडर, कॉलम बनकर फैले महीने, Excel की आख़िरी पंक्ति पर कटी फ़ाइल।
आईडी और एन्कोडिंग
शुरुआती शून्य खो चुके पिन कोड, 1.23E+11 के रूप में एक्सपोर्ट हुई आईडी, बिगड़े हुए अक्षर, मानों के अंदर अदृश्य कैरेक्टर।
समय और ताज़गी
ऐसी टेबल जिसका अपडेट होना रुक गया, आधा ही लोड हुआ आख़िरी महीना, किसी सीरीज़ में ख़ाली जगहें, ऐसा चलता बैलेंस जिसे कभी जोड़ा नहीं जाना चाहिए।
घटनाओं का क्रम
शुरुआत से पहले की समाप्ति तारीख़, कभी डिलीवर न हुआ शिपमेंट, अकाउंट बनने से पहले ही बंद हुई ऑपर्च्युनिटी।
आपकी डेटा डिक्शनरी से मिलान
डेटा में ऐसे कोड जिन्हें आपकी डिक्शनरी नहीं जानती, और ऐसे कॉलम जो संख्या के रूप में दर्ज हैं पर टेक्स्ट के रूप में सहेजे गए हैं।
प्राथमिकता
इस हिसाब से क्रम कि आपके जवाबों पर क्या असर होता है
हर नोट को महत्वपूर्ण, निगरानी या जानकारी के रूप में चिह्नित किया जाता है, और इस हिसाब से क्रम दिया जाता है कि आपका बिज़नेस उस कॉलम पर कितना निर्भर है। किसी KPI या सहेजे गए सवाल को डेटा देने वाले कॉलम की समस्या, किसी ऐसी टेबल की दिखावटी समस्या से पहले आती है जिसे कोई इस्तेमाल नहीं करता, और नोट बताता है कि किन सवालों पर असर है।
फ़ैसला आपका
हर खोज ऐसी चीज़ है जिसे आप संभाल सकते हैं
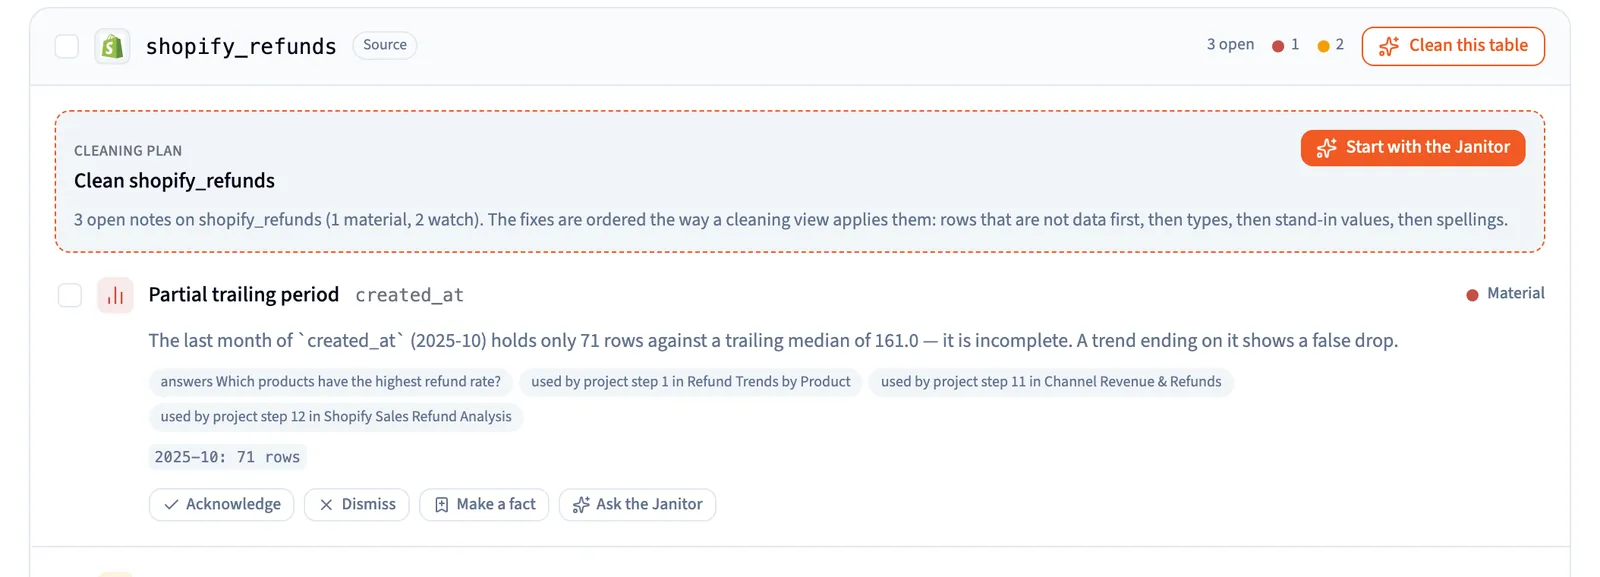
जो आप पहले से जानते हैं उसे स्वीकार करें। जो यहाँ समस्या नहीं है उसे खारिज करें, और उसका कारण सहेजा रहता है। उसे तथ्य बनाएँ, और एजेंट हर बार उस डेटा का इस्तेमाल करते समय उसे पढ़ेंगे। कई नोट एक साथ संभालने के लिए एक रेंज चुनें, और टाइप करते-करते पूरे ऑडिट में खोजें।
बिना आवाज़ की एक रिकॉर्डिंग जो डेटा ऑडिट में एक टेबल के कार्ड को स्क्रॉल करती है: तारीख़ बनकर बैठा Excel सीरियल नंबर, शुरुआती शून्य खो चुके पिन कोड और डुप्लिकेट कीज़, हर नोट के साथ प्रभावित पंक्तियों का हिस्सा, उदाहरण और माप से बना एक छोटा चार्ट।
बिखरा डेटा, पकड़ा गया
यह क्या-क्या पकड़ता है, इसके उदाहरण
ऐसी समस्याएँ सालों तक डेटा में बैठी रहती हैं, जब तक कोई यह नहीं कहता कि संख्या ग़लत है।
एक ग्राहक, दो बार गिना गया
एक अदृश्य ज़ीरो-विड्थ या आख़िर में लगा स्पेस "Acme" और "Acme " को दो ग्राहक बना देता है। स्क्रीन पर कुछ ग़लत नहीं दिखता, और टोटल दो हिस्सों में बँट जाता है।
एक ही कॉलम में महीना पहले और दिन पहले
01/08/2024 का मतलब 8 जनवरी है या 1 अगस्त? जाँच 12 से बड़े मानों से क्रम साबित करती है और दोनों को मिलाने वाले कॉलम को चिह्नित करती है। जब डेटा से तय नहीं होता, तो Janitor आपसे पूछता है।
डेटा के बीच ग्रैंड टोटल की पंक्ति
स्प्रेडशीट एक्सपोर्ट में छूट गई टोटल की पंक्ति उस पर बने हर जोड़ में दोबारा गिनी जाती है।
संख्या वाले कॉलम में करेंसी चिह्न
एक ही कॉलम में $1,014.08, USD 1023.11 और ($286.05)। एक सीधा कन्वर्ज़न कुछ मानों को ख़ाली कर देता है और कोष्ठक वाली ऋणात्मक संख्या को धनात्मक पढ़ता है।
यूरोपीय दशमलव, हज़ार गुना छोटे
1.234,56 बिना किसी एरर के 1.23456 बन सकता है। मिले-जुले सेपरेटर चिह्नित किए जाते हैं, ताकि कॉलम साफ़ होने का भ्रम न दे।
एक ही ऑर्डर आईडी, दो अलग टोटल
ऑर्डर 5521 की दो पंक्तियाँ जो आपस में मेल नहीं खातीं। डेटा में कुछ नहीं बताता कि कौन सही है, इसलिए यह चुपचाप लगाया गया अंदाज़ा नहीं, आपका फ़ैसला बनता है।
रोज़ाना की सीरीज़ में ख़ाली जगह
3 से 17 मार्च तक कोई पंक्ति नहीं, या आख़िरी महीने में आम तौर पर 61 की जगह सिर्फ़ 15 पंक्तियाँ, जिससे हर ट्रेंड एक ऐसी गिरावट पर ख़त्म होता है जो कभी हुई ही नहीं।
डेटा डिक्शनरी से भटके कोड
region कॉलम में 9 है, जबकि आपकी डेटा डिक्शनरी में 1 से 4 तक हैं। ऑडिट कोड वाले कॉलम को आपकी अपनी डिक्शनरी से मिलाता है।
प्लेसहोल्डर तारीख़ें
1900-01-01 वाली 34,000 जन्मतिथियाँ औसत ग्राहक को 120 साल का बना देती हैं।
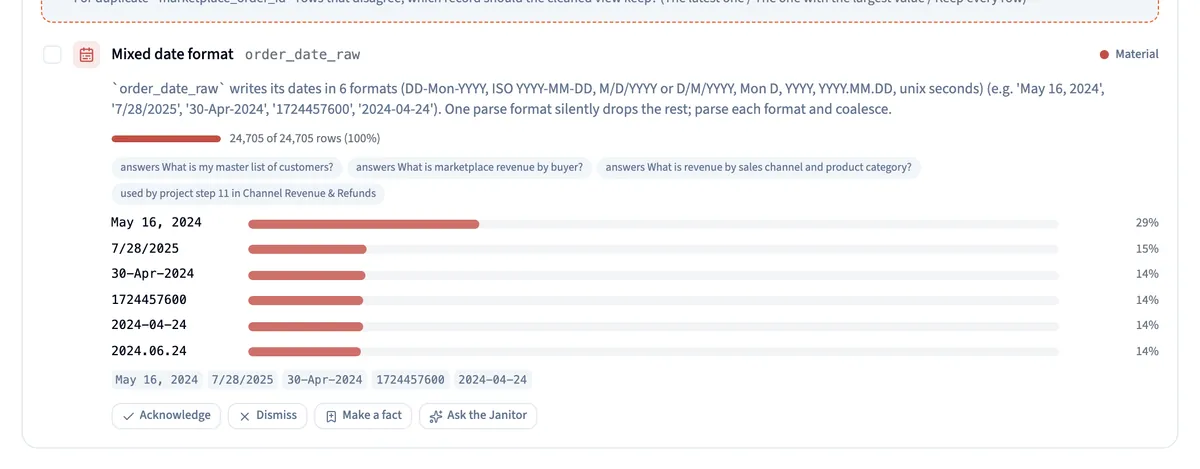
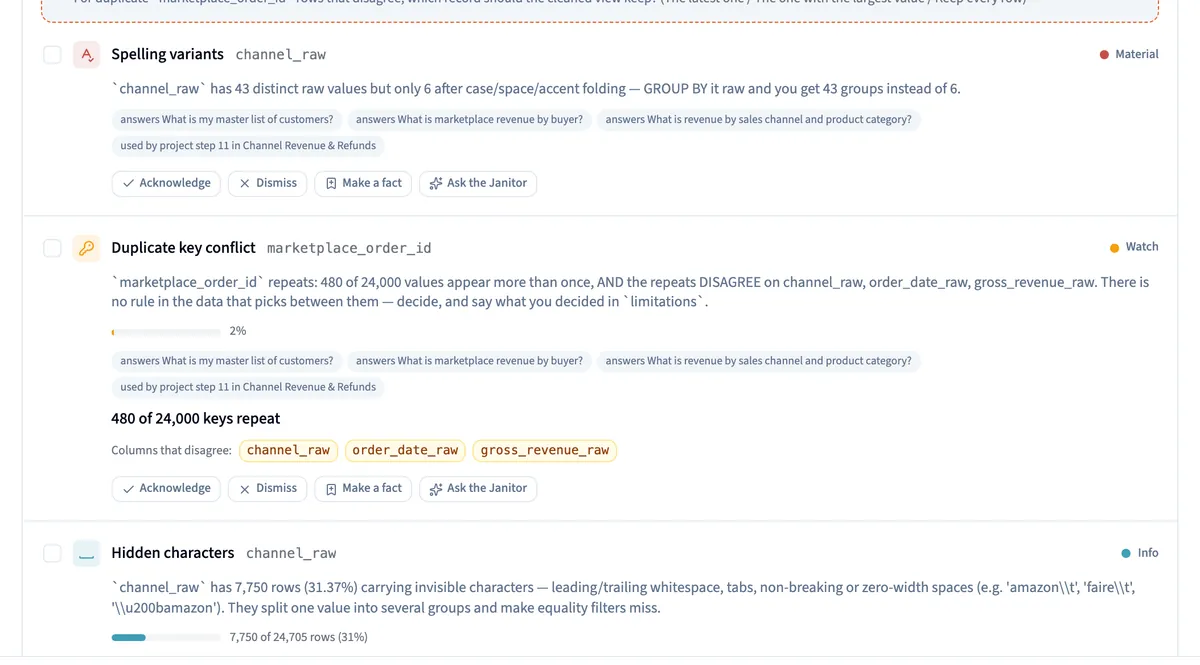
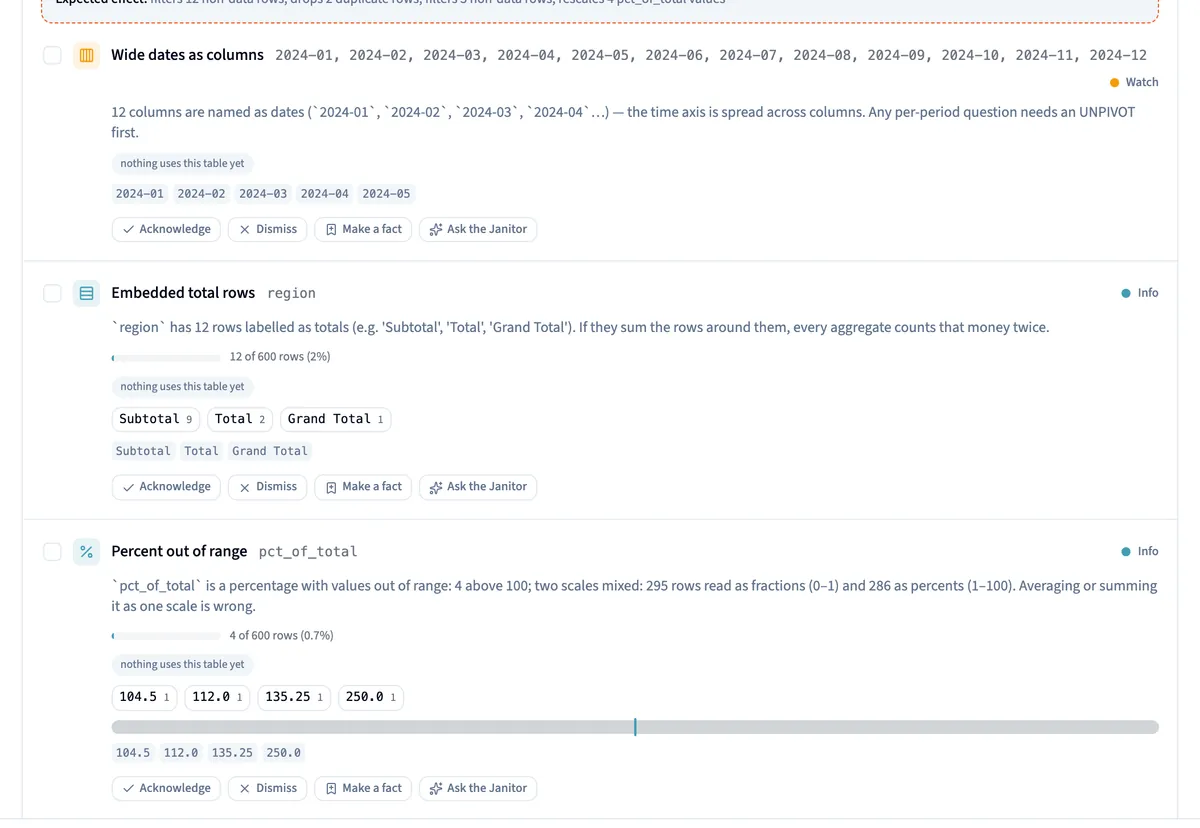
स्क्रीन एक डेमो कंपनी के डेटा के साथ Querri में कैप्चर की गई हैं।
चुपचाप कुछ भी दोबारा नहीं लिखा जाता
हर सुधार एक व्यू है जिसे आप खोल सकते हैं
आपका कच्चा डेटा ठीक वैसा ही रहता है जैसा आया था। Janitor का काम एक साफ़ व्यू बन जाता है: SQL जिसे आप खोल सकते हैं, और मिलान के लिए सोर्स भी वहीं रहता है।
सबूत कि सफ़ाई काम आई
Querri साफ़ व्यू को उन्हीं जाँचों से दोबारा मापता है। कोई नोट तभी सुलझा माना जाता है जब उसकी समस्या फिर नहीं दिखती। जो समस्या अब भी दिखती है, उसका नोट खुला रहता है, और Janitor यह बता देता है।
एक बार साफ़, हर जगह इस्तेमाल
इसके बाद सोर्स पर व्यू के नाम के साथ "के रूप में साफ़ की गई" लिखा आता है, और तब से हर जवाब, डैशबोर्ड और AI एजेंट साफ़ व्यू ही पढ़ता है।
फ़ैसले जो टिके रहते हैं
किसी नोट को कारण के साथ खारिज करें और वह तय माना जाता है। टेबल को छूने वाला अगला एजेंट समस्या दोबारा उठाने के बजाय आपका फ़ैसला पढ़ता है।
यह कैसे जुड़ता है
आपका डेटा आने के पल से
-
अपलोड या कनेक्ट करें
एक स्प्रेडशीट एक्सपोर्ट, एक CSV, या किसी कनेक्टेड सिस्टम या डेटाबेस की टेबल। Library इन सबको एक जगह रखती है।
-
डेटा आते ही ऑडिट चलता है
जाँचें उसी स्कैन के अंदर चलती हैं जो Querri किसी टेबल के आने पर पहले से करता है, और फिर हर व्यू के बनते समय। किसी को कहना नहीं पड़ता।
-
Janitor के साथ साफ़ करें
डेटा ऑडिट को सबसे ज़रूरी से शुरू करके निपटाएँ, या इस तालिका को साफ़ करें दबाकर वे फ़ैसले लें जो आपके हैं।
-
हर जवाब पहले से जानता है
खुले नोट कॉलम के साथ हर एजेंट की ब्रीफ़ में जाते हैं। जब डेटा ने कोई चुनाव करने पर मजबूर किया, तो जवाब आपको बताता है कि उसने कौन सा चुना।
अक्सर पूछे जाने वाले सवाल
ऑटोमैटिक डेटा क्लीनिंग के बारे में सवाल
ऑटोमैटिक डेटा क्लीनिंग क्या है?
ऑटोमैटिक डेटा क्लीनिंग का मतलब है कि आपके डेटा की समस्याएँ बिना किसी के पहले से नियम या स्क्रिप्ट लिखे ढूँढी और ठीक की जाती हैं। Querri में डेटा ऑडिट हर टेबल के आते ही उस पर 180 से ज़्यादा डेटा क्वालिटी जाँचें चलाता है, और Janitor, एक AI एजेंट, जो मिला उसे आपके साथ मिलकर साफ़ करता है। नतीजा एक साफ़ व्यू होता है, जिसे उसके बाद जवाब, डैशबोर्ड और एजेंट इस्तेमाल करते हैं।
डेटा ऑडिट क्या है?
डेटा ऑडिट किसी डेटासेट की व्यवस्थित जाँच है, उन समस्याओं के लिए जो उसकी संख्याओं को ग़लत बनाती हैं: भेस बदले ख़ाली मान, टेक्स्ट के रूप में सहेजी गई संख्याएँ, डुप्लिकेट, मिले-जुले फ़ॉर्मेट, ख़ाली जगहें। Querri में डेटा ऑडिट एक पेज है जो हर टेबल के आते ही उस पर 180 से ज़्यादा जाँचें चलाता है और जो मिला उसकी सूची देता है, सबसे ज़रूरी सबसे पहले, और हर समस्या के साथ यह भी कि वह क्यों मायने रखती है।
ऑटोमैटिक डेटा क्वालिटी क्या है?
डेटा क्वालिटी की ऐसी जाँचें जो बिना किसी के नियम लिखे या कहे चलती हैं। Querri हर टेबल को अपलोड या कनेक्ट होते समय और हर व्यू को बनते समय जाँचता है, और मिली हर समस्या को डेटा क्वालिटी नोट के रूप में दर्ज करता है, जिसे आप स्वीकार कर सकते हैं, खारिज कर सकते हैं या साफ़ कर सकते हैं।
एजेंटिक डेटा क्लीनिंग का क्या मतलब है?
एक AI एजेंट आपको सूची थमाने के बजाय आपके साथ मिलकर सफ़ाई का काम करता है। Janitor डेटा ऑडिट के सबूत पढ़ता है, आपकी पंक्तियों पर सुधार आज़माता है, आपसे वे फ़ैसले पूछता है जो सिर्फ़ आप ले सकते हैं, अपनी योजना दिखाता है, और आपकी हाँ पर एक साफ़ व्यू बनाता है। फिर Querri उस व्यू को दोबारा मापकर साबित करता है कि कौन सी समस्याएँ दूर हुईं।
Querri किन डेटा सोर्स को साफ़ कर सकता है?
कोई भी टेबल जो Querri तक पहुँचती है, किसी फ़ाइल से या किसी कनेक्टर से। इसमें Shopify, Stripe, Salesforce, HubSpot, Pipedrive, QuickBooks, NetSuite, Klaviyo, Mailchimp, Intercom, Zendesk, Google Ads, Meta Ads, Amazon Seller, Google Analytics, Mixpanel, Amplitude, Snowflake, BigQuery, Redshift, Postgres, MySQL, SQL Server और Oracle जैसे डेटा वेयरहाउस और डेटाबेस, Google Drive की फ़ाइलें, और अपलोड की गई स्प्रेडशीट और CSV शामिल हैं। Shopify ऑर्डर या Salesforce ऑपर्च्युनिटी के लिए डेटा क्लीनिंग ठीक वैसे ही काम करती है जैसे किसी एक्सपोर्ट की गई CSV के लिए।
क्या मैं कई सोर्स का डेटा जोड़ने से पहले साफ़ कर सकता हूँ?
हाँ। हर टेबल का अपना ऑडिट और अपना साफ़ व्यू होता है, इसलिए आप पहले हर सोर्स को साफ़ करते हैं और फिर साफ़ व्यू को जोड़ते हैं। तारीख़ें एक फ़ॉर्मेट में आ जाती हैं, करेंसी वैसे संभाली जाती है जैसा आपने चुना, वर्तनी एक जैसी की जाती है और हर सोर्स के अंदर आईडी ठीक की जाती हैं, और इसी से जोड़ सही बैठता है। ऑडिट टेबलों के बीच पहचानी गई जॉइन कीज़ भी जाँचता है, जैसे ऐसी चाइल्ड पंक्तियाँ जिनकी की का पैरेंट टेबल में कोई मेल नहीं है।
क्या यह Excel और Google Sheets एक्सपोर्ट साफ़ करता है?
हाँ। स्प्रेडशीट एक्सपोर्ट की अपनी जाँचें होती हैं: डेटा के बीच टोटल और सबटोटल की पंक्तियाँ, फ़ाइल के बीच दोहराए गए हेडर, कॉलम बनकर फैले महीने, तारीख़ बनकर बैठे Excel सीरियल नंबर, 1.23E+11 बन चुकी आईडी, शुरुआती शून्य खो चुके पिन कोड, और Excel की आख़िरी पंक्ति पर रुक गई फ़ाइल। एक्सपोर्ट जैसा है वैसा अपलोड करें और डेटा ऑडिट बताता है कि उसे क्या मिला।
क्या यह अलग-अलग सिस्टम की तारीख़ों और करेंसी को एक जैसा कर सकता है?
हर टेबल के अंदर हाँ, और इसी से अलग-अलग सिस्टम की टेबल आपस में मेल खाती हैं। ऑडिट एक कॉलम में कई तारीख़ फ़ॉर्मेट पहचानता है, जहाँ हो सके मानों से साबित करता है कि दिन पहले है या महीना, और मिली-जुली करेंसी या ऐसी रकम को चिह्नित करता है जिसकी करेंसी करेंसी कॉलम से मेल नहीं खाती। Janitor वे फ़ैसले पूछता है जो सिर्फ़ आप ले सकते हैं, जैसे करेंसी बदलनी है या अलग रखनी है, और साफ़ व्यू हर तारीख़ और हर रकम को एक ही तरह से लिखता है।
यह डुप्लिकेट को कैसे संभालता है?
यह तीन मामलों को अलग करता है: हूबहू दोहराई गई पंक्तियाँ, एक जैसे मानों के साथ दोहराई गई कीज़, और ऐसी कीज़ जो दोहराई जाती हैं पर मेल नहीं खातीं, जैसे दो टोटल वाली एक ऑर्डर आईडी। पहले दो मामलों को सीधे मिलाया जा सकता है। जब दोहराव मेल नहीं खाते, तो डेटा में कुछ नहीं बताता कि कौन सही है, इसलिए Janitor आपसे पूछता है कि कौन सी पंक्ति रखनी है, अपनी सिफ़ारिश सबसे पहले रखकर।
क्या यह मेरा मूल डेटा बदलता है या उसकी कॉपी बनाता है?
आपका कच्चा डेटा ठीक वैसा ही रहता है जैसा आया था। सुधार एक साफ़ व्यू है, जो SQL में परिभाषित है जिसे आप खोल सकते हैं, और जो सोर्स के ऊपर लिखने के बजाय उससे बनाया जाता है। सोर्स उसके बगल में रहता है ताकि आप दोनों का मिलान कर सकें।
साफ़ व्यू क्या है, और क्या नया डेटा आने पर भी यह काम करता रहता है?
साफ़ व्यू एक सहेजा गया व्यू है जो Janitor के सुधारों को सोर्स टेबल पर लागू करता है, और उसके बाद सोर्स पर व्यू के नाम के साथ "के रूप में साफ़ की गई" लिखा आता है। क्योंकि यह एक बार का बदलाव नहीं, बल्कि सहेजी गई परिभाषा है, यह अगले महीने के डेटा पर भी वैसे ही चलता है। जब व्यू दोबारा बनता है, तो Querri उसे फिर से मापता है, और लौट आई समस्या अपना नोट दोबारा खोल देती है।
यह किसी डेटा क्वालिटी टूल या क्लीनिंग स्क्रिप्ट से कैसे अलग है?
कई डेटा क्वालिटी टूल इंजीनियरों के लिए पाइपलाइन पर नज़र रखते हैं, या कॉलम के आँकड़े दिखाकर किसी के सुधार बनाने का इंतज़ार करते हैं, और क्लीनिंग स्क्रिप्ट सिर्फ़ वही जाँचती है जिसके लिए उसे लिखा गया था। Querri किसी के पूछने से पहले हर टेबल पर अपनी जाँचें चलाता है, जो मिला उसे उन सवालों और KPI के हिसाब से क्रम देता है जो हर कॉलम को पढ़ते हैं, आपसे वे फ़ैसले पूछता है जो किसी संख्या को बदलते हैं, और सुधार को एक व्यू के रूप में बनाकर उसे फिर से मापता है।
डेटा क्वालिटी नोट कौन देखता है, और सुधार को मंज़ूरी कौन देता है?
नोट उन्हीं एक्सेस नियमों का पालन करते हैं जो उनकी टेबल पर लागू हैं, और जहाँ कोई सिर्फ़ कुछ पंक्तियाँ देख सकता है, वहाँ उदाहरण वाले मान हटा दिए जाते हैं। कोई सुधार अपने आप लागू नहीं होता: Janitor अपनी योजना एक रिव्यू कार्ड पर दिखाता है और साफ़ व्यू तभी बनाता है जब उसके साथ काम कर रहा व्यक्ति हाँ कहता है।
क्या मैं इसे कोई नियम एक बार बता सकता हूँ?
हाँ। किसी नोट को कारण के साथ खारिज करें और वह तय माना जाता है, ताकि अगला एजेंट समस्या दोबारा उठाने के बजाय आपका फ़ैसला पढ़े। डेटा के बारे में जो आप जानते हैं उसे सहेजने के लिए तथ्य बनाएँ का इस्तेमाल करें, और एजेंट हर बार उस डेटा का इस्तेमाल करते समय वह तथ्य पढ़ेंगे।
बाक़ी Querri के साथ काम करता है
साफ़ डेटा, हर उस जगह जहाँ वह इस्तेमाल होता है
सोमवार की सुबह एक्सपोर्ट ठीक करने में अब और नहीं।
अपनी ही टेबल पर डेटा ऑडिट देखिए, फिर Janitor के साथ एक टेबल साफ़ कीजिए।