Querri vs Microsoft Fabric
Fabric एक प्लेटफ़ॉर्म है जिस पर आप निर्माण करते हैं। Querri वह जवाब है जिस तक आप पहुँचना चाहते हैं।
लक्ष्य एक ही: भरोसेमंद जवाब। प्रोजेक्ट बिल्कुल अलग।
Microsoft Fabric उन टीमों के लिए एक गंभीर प्लेटफ़ॉर्म है जिनके पास इसे चलाने वाले इंजीनियर हैं: तय करने के लिए कैपेसिटी, पाइपलाइन, एक सिमेंटिक मॉडल, Power BI लाइसेंस और ऊपर से Copilot। Querri सवाल से शुरू होने वाला डेटा प्लेटफ़ॉर्म है। यह आपके व्यवसाय के सवालों से शुरू करता है और उनके जवाब के लिए जो कुछ चाहिए वह बनाता है, एक ही प्रोडक्ट में, एक पूर्वानुमेय बिल पर।
समय, लागत और नियंत्रण
इसी तिमाही में जवाब, ऐसा बिल जिसकी आप योजना बना सकें, और कोई नई टीम भर्ती करने की ज़रूरत नहीं
Fabric एक प्लेटफ़ॉर्म है जिस पर आपके इंजीनियर निर्माण करते हैं। Querri आपके सिस्टम से जवाब तक का पूरा तैयार रास्ता है। व्यवसाय के लिए इस फ़र्क़ का मतलब यह है।
-
तिमाहियों में नहीं, दिनों में जवाब
पहले भरोसेमंद जवाब से पहले पाइपलाइन, एक सिमेंटिक मॉडल और Power BI रोलआउट आते हैं। Querri के साथ, आप कोई सिस्टम कनेक्ट करते हैं या फ़ाइल अपलोड करते हैं और उसी दिन सवाल पूछते हैं।
-
ऐसा बिल जिसकी आप योजना बना सकें, कोई अचानक खर्च नहीं
Fabric कैपेसिटी का बिल लेता है, साथ में F64 से नीचे हर दर्शक के लिए एक Power BI लाइसेंस, और लोड बढ़ने पर थ्रॉटल करता है। Querri एक पूर्वानुमेय बिल है: आपकी टीम के काम से जुड़ा एक मासिक क्रेडिट भत्ता, उस तक पहुँचने से पहले अलर्ट, और कोई ऑटोमैटिक ओवरएज शुल्क नहीं।
-
डेटा टीम की ज़रूरत नहीं
Fabric वाले रास्ते में डेटा इंजीनियर और एक Power BI डेवलपर चाहिए। Querri में, जो लोग पहले से व्यवसाय को जानते हैं, वही सरल भाषा में तय करते हैं कि आँकड़ों का क्या मतलब है।
-
सुरक्षित, ऑडिट योग्य, कुछ भी हटाना नहीं
SOC 2 Type II, HIPAA और ISO 27001:2022, और आपके डेटा पर कभी कोई मॉडल ट्रेन नहीं होता। हर आँकड़ा अपनी क्वेरी दिखाता है, और Excel, Power BI और Microsoft 365 जहाँ हैं वहीं रहते हैं।
कौन कहाँ फ़िट बैठता है
अपनी टीम और समय-सीमा के हिसाब से चुनें
हम चाहेंगे कि आप सही टूल चुनें, न कि गलत वजह से हमें। यहाँ बताया गया है कि कौन कहाँ फ़िट बैठता है।
Microsoft Fabric चुनें जब
- आपके पास ऐसे डेटा इंजीनियर हैं, या आप उन्हें रखने वाले हैं, जो पाइपलाइन, एक लेकहाउस और Power BI मॉडल बनाएँगे और चलाएँगे।
- आपका डेटा कई टेराबाइट तक जाता है, या आपको डेटा साइंस, मशीन लर्निंग या रियल-टाइम स्ट्रीम के लिए Spark चाहिए।
- सब कुछ पहले से Azure और Microsoft 365 में है, और Entra ID और Purview गवर्नेंस को डेटा पर भी लागू होना चाहिए।
- कोई कैपेसिटी की ज़िम्मेदारी लेगा: उसका आकार तय करना, Capacity Metrics ऐप पर नज़र रखना और भारी वर्कलोड को अलग रखना।
- आप एक बड़े संगठन में Power BI को मानक बना रहे हैं, जहाँ F64 और उससे ऊपर देखना मुफ़्त हो जाता है।
Querri चुनें जब
- आपको व्यावसायिक जवाब कुछ दिनों में चाहिए, किसी डेटा प्लेटफ़ॉर्म प्रोजेक्ट के बाद नहीं।
- आपका डेटा व्यावसायिक सिस्टम (CRM, अकाउंटिंग, ERP, पेमेंट, स्प्रेडशीट) में है, और उसका बड़ा हिस्सा Microsoft के बाहर है।
- जो लोग जानते हैं कि आँकड़ों का क्या मतलब है वे इंजीनियर नहीं हैं, और उन्हें यह बताने के लिए DAX नहीं लिखना पड़ना चाहिए।
- आपको एक पूर्वानुमेय बिल चाहिए, असीमित डैशबोर्ड दर्शकों के साथ, और बिना किसी कैपेसिटी के जिसका आकार तय करना हो या जो थ्रॉटल हो।
- आपको डैशबोर्ड, रिपोर्ट, एक AI एजेंट, डेटा क्लीनिंग और Claude और ChatGPT के लिए MCP पहले से बने हुए चाहिए, जोड़-जोड़कर नहीं।
फ़ीचर दर फ़ीचर
विस्तृत तुलना
हर पंक्ति बताती है कि कौन कहाँ बेहतर है। जहाँ Fabric आगे है, हम वह भी कहते हैं। तथ्य अक्टूबर 2026 तक के हैं और स्रोतों में लिंक किए गए हैं।
Fabric की कीमतें US सूची मूल्य हैं, जब तक अलग से न बताया गया हो pay-as-you-go, जो अक्टूबर 2026 में Microsoft के प्राइसिंग पेज और Azure Retail Prices API से ली गई हैं। कीमतें क्षेत्र और अनुबंध के अनुसार बदलती हैं।
कीमत
कैपेसिटी प्राइसिंग तब काम करती है जब कोई उस पर नज़र रखे
रिज़र्व की गई Fabric कैपेसिटी की मासिक कीमत तय होती है, और यह एक असली ताक़त है। Microsoft की अपनी गाइडेंस इसका नुकसान भी बताती है: "लागत उपलब्ध कैपेसिटी के आकार से जुड़ी होती है, वास्तविक वर्कलोड उपयोग से नहीं," और "एक वर्कलोड में उछाल दूसरों को धीमा कर सकता है।" हर पाइपलाइन, नोटबुक, रिपोर्ट और Copilot सवाल उसी कैपेसिटी को साझा करते हैं, और जब लोड ज़्यादा होता है, तो नतीजा होता है थ्रॉटलिंग, या प्रीमियम दर पर बिल किया गया ओवरएज।
Fabric का बिल कैसे बनता है
- CUs में कैपेसिटी, $0.18 प्रति CU-घंटा (US East): F2 $262.80 प्रति माह और F64 $8,409.60, या एक साल के रिज़र्वेशन पर लगभग 41% कम।
- F64 से नीचे, हर दर्शक को Pro ($14) या PPU ($24) लाइसेंस चाहिए, कैपेसिटी के ऊपर से।
- इंटरैक्टिव काम को 5 से 64 मिनट में, बैकग्राउंड जॉब को 24 घंटे में स्मूद किया जाता है। सीमा पार होने पर Fabric पहले देरी करता है, फिर अनुरोध अस्वीकार करता है।
- Capacity overage डिफ़ॉल्ट रूप से चालू है नई कैपेसिटी के लिए, और अतिरिक्त उपयोग को pay-as-you-go दर के 3x पर बिल करता है। Microsoft: "आपके वास्तविक शुल्क रोलिंग 24-घंटे की ओवरएज सीमा से ज़्यादा हो सकते हैं।"
- थ्रॉटलिंग रोकने के लिए कैपेसिटी पॉज़ करने पर बचा हुआ स्मूद किया गया उपयोग आपके Azure बिल में जुड़ जाता है।
- Copilot "आपकी उपलब्ध Fabric कैपेसिटी खर्च करता है," इसलिए एक लोकप्रिय AI रोलआउट आपकी रिपोर्टों से होड़ करता है।
कब कैपेसिटी प्राइसिंग बेहतर सौदा है
अगर आपके पास एक Fabric एडमिन है जो असली माप से कैपेसिटी का आकार तय करता है, रिज़र्वेशन खरीदता है, ज़रूरी वर्कलोड को उनकी अपनी कैपेसिटी पर अलग रखता है और Capacity Metrics ऐप पर नज़र रखता है, तो Fabric की लागत बड़े पैमाने पर बहुत किफ़ायती हो सकती है, ख़ासकर F64 और उससे ऊपर, जहाँ देखना मुफ़्त है। Microsoft की अपनी सलाह है कि पहले pay-as-you-go पर मापें। अगर आपकी टीम ऐसी है, तो नीचे दी गई गाइड से शुरुआत करें।
जब कैपेसिटी ख़त्म होती है तो कैसा दिखता है
Fabric चुन रहे हैं? कैपेसिटी को काबू में रखें।
अगर Fabric आपके लिए सही फ़ैसला है, तो ये वे नियंत्रण हैं जो बिल और थ्रॉटलिंग को पूर्वानुमेय रखते हैं। ये सभी Microsoft के अपने दस्तावेज़ हैं।
- थ्रॉटलिंग को समझें स्मूदिंग विंडो, और देरी से अस्वीकृति तक के चरण। Microsoft Learn
- Capacity Metrics ऐप इंस्टॉल करें देखें कि कौन-से आइटम आपके CUs इस्तेमाल करते हैं, 14 दिन के इतिहास के साथ। Microsoft Learn
- Surge protection सेट करें बैकग्राउंड जॉब को जल्दी अस्वीकार करें ताकि इंटरैक्टिव रिपोर्ट चलती रहें। Microsoft Learn
- Capacity overage पर फ़ैसला करें यह डिफ़ॉल्ट रूप से 3x दर पर चालू है। सीमा तय करें, या इसे बंद करें। Microsoft Learn
- कैपेसिटी को ऑप्टिमाइज़ करें और आकार तय करें पहले pay-as-you-go पर मापें, फिर रिज़र्व करें। Microsoft Learn
- सुरक्षित रूप से पॉज़ और resume करें पॉज़ करने का स्मूद किए गए उपयोग और आपके बिल पर क्या असर होता है। Microsoft Learn
Querri बिल को पूर्वानुमेय कैसे रखता है
- एक बिल, कोई अचानक खर्च नहीं। पूरे संगठन के लिए एक प्लान, जिसमें AI, स्टोरेज और असीमित डैशबोर्ड दर्शक शामिल हैं। प्लान और कीमतें देखें।
- एक सरल क्रेडिट। एक क्रेडिट बिज़नेस के काम की एक इकाई है, जैसे किसी सवाल का जवाब देना या किसी सोर्स को सिंक करना, इसलिए उपयोग को समझना और उसकी योजना बनाना आसान है।
- हर प्लान पर असीमित डैशबोर्ड दर्शक। देखने, अपलोड, एक्सपोर्ट और Library में कभी क्रेडिट खर्च नहीं होते।
- प्लान के 80% पर, सीमा पार होने पर और अचानक उछाल पर उपयोग अलर्ट, साथ में किसी भी व्यक्ति के लिए मासिक सीमा।
- कोई स्वचालित ओवरएज शुल्क नहीं। जैसे-जैसे आप अपनी सीमा के पास पहुँचते हैं, हम आपको बताते हैं, और आगे क्या हो यह आप तय करते हैं।
- न कोई कैपेसिटी जिसका आकार तय करना हो, जिसे पॉज़ करना हो या जो थ्रॉटल हो। स्टोरेज, इंजन और AI प्लान में शामिल हैं।
कुल लागत
पहला जवाब पाने में क्या लगता है
Fabric कई टूल्स को एक छत के नीचे लाता है, जिससे सचमुच मदद मिलती है। फिर भी हर परत को आपको जोड़ना और उसके लिए लोग रखने पड़ते हैं। यहाँ लगभग 100 लोगों की टीम के लिए Fabric का रास्ता है, Querri के साथ।
Fabric के आँकड़े Microsoft की US सूची कीमतों और लिंक किए गए स्रोतों में वेतन और इम्प्लीमेंटेशन रेंज से हमारा हिसाब हैं, कोई कोटेशन नहीं। आपका मिश्रण अलग होगा: अगर आपके पास पहले से टीम है, तो लोगों वाली लागत वह है जिसे आप पहले ही चुन चुके हैं।
आर्किटेक्चर
सबसे बड़े डेटा के लिए Spark और Polaris। जो डेटा असल में आपके पास है, उसके लिए DuckDB।
यही असली आर्किटेक्चरल अंतर है, और लागत के ज़्यादातर अंतर की वजह भी यही है। Fabric ऐसे डिस्ट्रिब्यूटेड इंजन चलाता है जो बड़े-बड़े काम कई मशीनों में बाँटने के लिए बने हैं। Querri खुली Parquet और Iceberg फ़ाइलों पर DuckDB चलाता है, एक इन-प्रोसेस एनालिटिकल इंजन जो एक ही मशीन पर बेहद तेज़ है।
Microsoft Fabric
एक साझा कैपेसिटी पर डिस्ट्रिब्यूटेड इंजन
- लेकहाउस और नोटबुक के लिए Spark; हर CU दो Spark कोर देता है, 3x तक बर्स्ट के साथ।
- Fabric Warehouse के पीछे Polaris, एक डिस्ट्रिब्यूटेड SQL इंजन; Power BI और Direct Lake के पीछे VertiPaq।
- OneLake टेबल को आपके टेनेंट में Delta Parquet या Iceberg के रूप में स्टोर करता है।
- कई टेराबाइट, स्ट्रीमिंग और बड़े पैमाने पर डेटा साइंस के लिए सचमुच सही टूल।
Querri
खुली फ़ाइलों पर DuckDB, व्यावसायिक डेटा के आकार के हिसाब से
- हर संगठन का डेटा उसके अपने स्टोरेज में, Apache Iceberg टेबल में Parquet के रूप में रखा जाता है।
- DuckDB उस पर इन-प्रोसेस क्वेरी करता है: न कोई क्लस्टर शुरू करना, न आकार तय करना, न उसे चालू रखना, न खाली बैठे रहने का भुगतान।
- जहाँ dataframe SQL से बेहतर हो, वहाँ Python काम आता है।
- हर जगह खुले फ़ॉर्मेट, ताकि आपके डेटा का कुछ भी किसी मालिकाना इंजन में बंद न रहे।
कौन-सा इंजन कहाँ सही टूल है
आर्किटेक्चर बिल में क्यों दिखता है
एक डिस्ट्रिब्यूटेड इंजन को सबसे ज़्यादा लोड के हिसाब से प्रोविज़न करना पड़ता है: कैपेसिटी रिज़र्व रहती है चाहे कोई सवाल पूछे या नहीं, और Spark सेशन खुले रहने तक उसका इस्तेमाल करते हैं। खुद Fabric पर, एक सार्वजनिक बेंचमार्क में पाया गया कि सिंगल-नोड DuckDB ने वही 5 GB का काम Spark के इस्तेमाल किए CUs के लगभग पाँचवें हिस्से में पूरा किया, और मिनटों के बजाय सेकंडों में शुरू हुआ। Querri इसी आर्किटेक्चर पर बना है, और यही एक बड़ी वजह है कि यह स्टोरेज, इंजन, AI, डैशबोर्ड और असीमित दर्शकों को एक पूर्वानुमेय प्लान में दे पाता है।
पहले से बना हुआ, जोड़ा हुआ नहीं
आपके डेटा और जवाब के बीच की हर चीज़, एक ही प्रोडक्ट में
Fabric में ये अलग-अलग वर्कलोड हैं जिन्हें बनाना और जोड़ना पड़ता है। Querri में ये एक ही शृंखला हैं: नया डेटा उस पर बने व्यू दोबारा बनाता है, KPI फिर से गिने जाते हैं और हर डैशबोर्ड रिफ़्रेश अपनी सेव की गई क्वेरी दोबारा चलाता है, ताकि हर आँकड़ा अपने स्रोत तक वापस जाए।
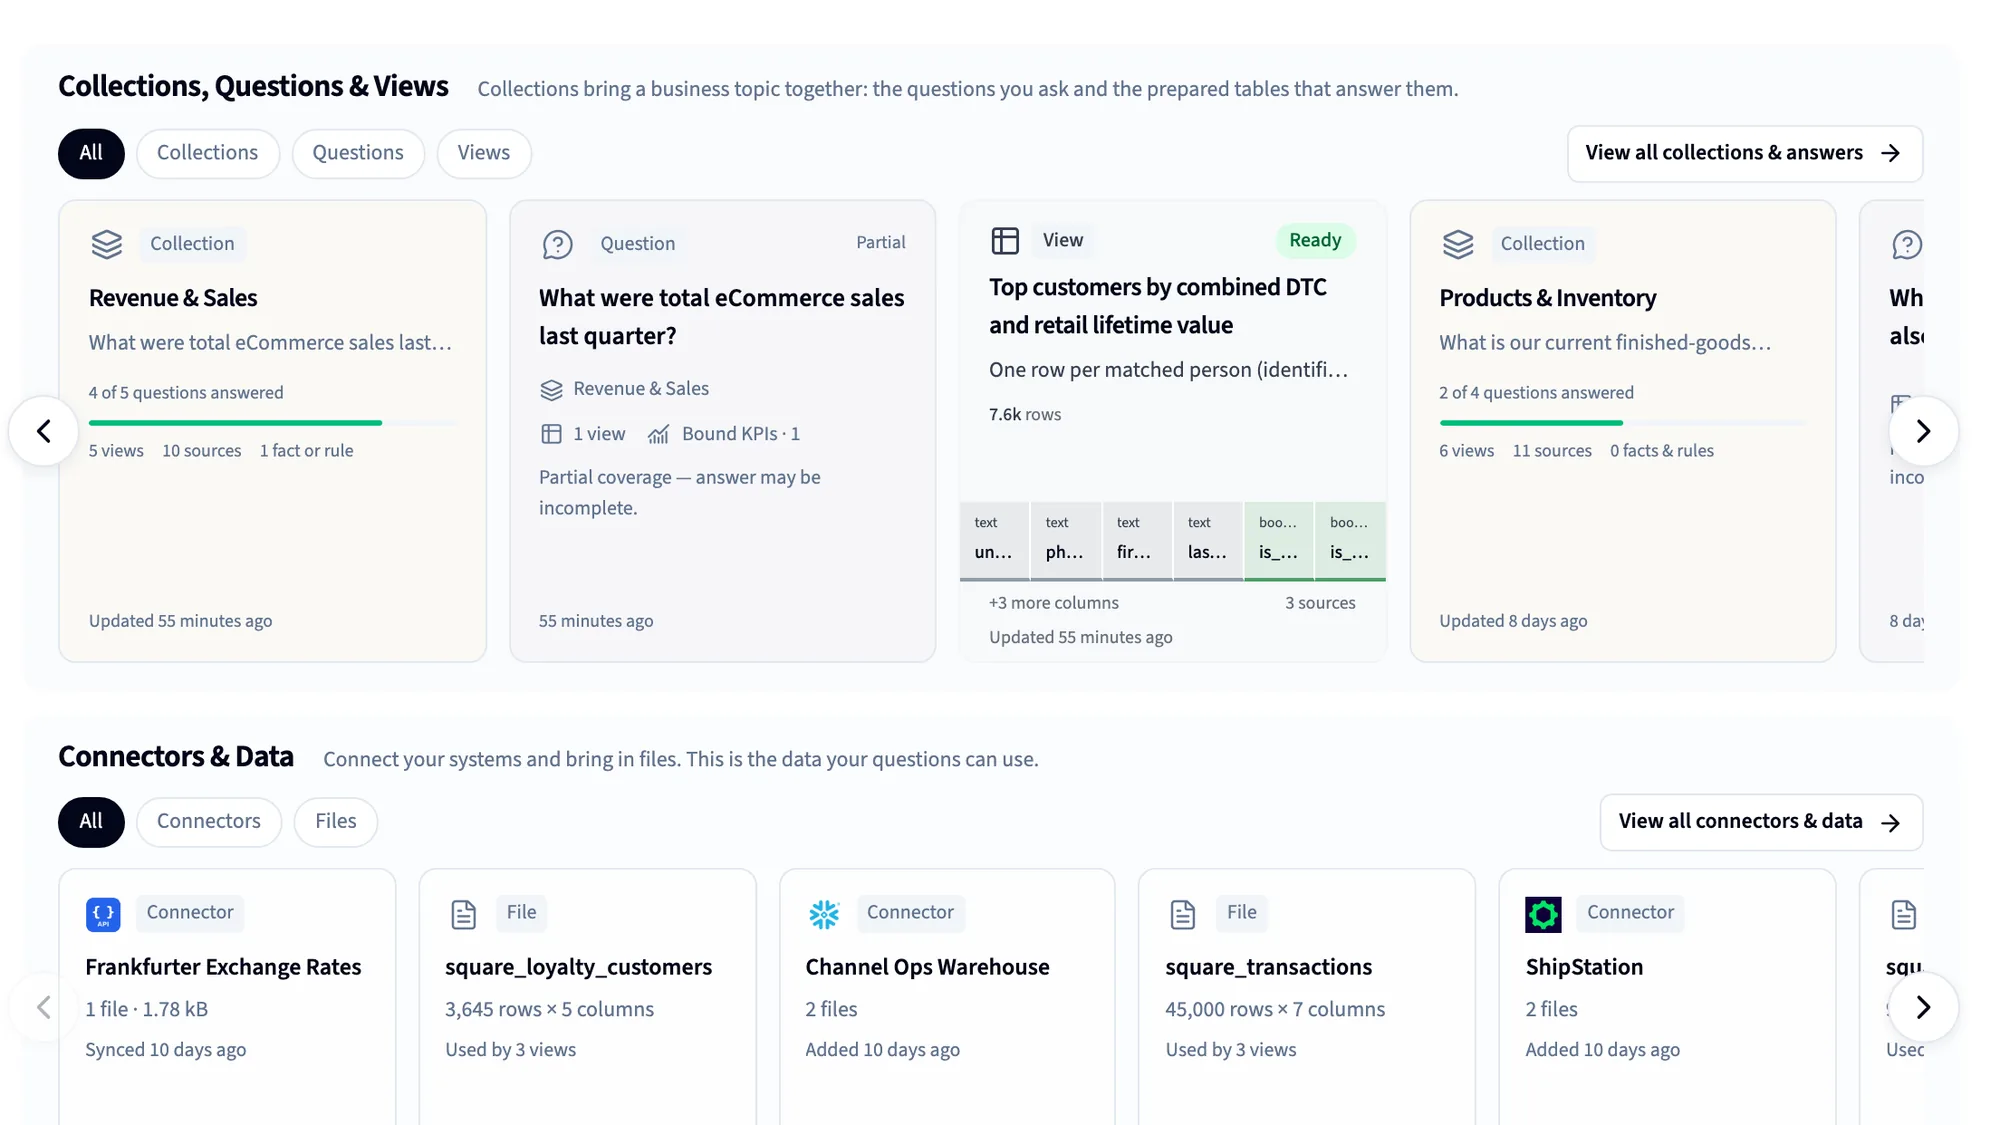
125+ कनेक्टर
CRM, अकाउंटिंग, ERP, पेमेंट, विज्ञापन और डेटाबेस, साथ में स्प्रेडशीट और फ़ाइलें।
ऑटोमैटिक डेटा क्लीनिंग
हर टेबल पर 180 से ज़्यादा जाँचें, और जो मिले उसे ठीक करने के लिए Janitor।
The Library
व्यवसाय को प्राथमिकता देने वाली सिमेंटिक लेयर: परिभाषाएँ, KPI और नियम, जिन्हें बस कहकर सिखाया जाता है।
डैशबोर्ड
पूछकर या स्क्रीनशॉट से बने, असीमित दर्शकों के साथ शेयर किए गए।
Nightly insights और Monitors
Querri रात भर आपके डेटा पर काम करता है और दिखाता है कि क्या बदला।
Claude और ChatGPT के लिए MCP
हर असिस्टेंट उन्हीं परिभाषाओं से जवाब देता है, हर व्यक्ति की एक्सेस के तहत।
रिपोर्ट और Excel
शेड्यूल किए गए प्रोजेक्ट, फ़ॉर्मेट की गई वर्कबुक और डेक, आपके लिए पहुँचाए जाते हैं।
व्हाइट लेबल और एम्बेड
वही समझ अपने प्रोडक्ट के अंदर, अपने ब्रांड के तहत लाएँ।
दोनों का इस्तेमाल
Microsoft Fabric और Querri साथ मिलकर कैसे काम करते हैं
कई टीमें दोनों चलाएँगी, और यह एक अच्छा सेटअप है। Fabric, Power BI और Excel को उन कामों के लिए रखें जिनमें वे अच्छे हैं, और Querri को वह जगह बनने दें जहाँ व्यवसाय वे सवाल पूछता है जिनके लिए किसी ने रिपोर्ट नहीं बनाई। आपका Fabric डेटा Querri के स्रोतों में से एक बन जाता है, उन सिस्टम के साथ जो Microsoft के बाहर हैं।
Microsoft में रखें
- वे Power BI रिपोर्ट जिन पर आपका बोर्ड निर्भर है
- Excel, जहाँ फ़ाइनेंस काम करता है
- बड़ा डेटा इंजीनियरिंग और Spark वर्कलोड
- Entra ID और Purview गवर्नेंस
Querri में करें
- वे सवाल जिनके लिए किसी ने रिपोर्ट नहीं बनाई
- व्यवसाय की अपनी परिभाषाएँ, सरल भाषा में
- सबके लिए डैशबोर्ड, बिना व्यूअर लाइसेंस के
- Querri, Claude और ChatGPT में AI जवाब
कनेक्शन कैसे काम करता है
-
Fabric वेयरहाउस और लेकहाउस SQL एंडपॉइंट वही प्रोटोकॉल इस्तेमाल करते हैं जो SQL Server करता है। Querri अपने SQL Server कनेक्टर से उनसे जुड़ता है, रीड एक्सेस वाले Microsoft Entra सर्विस प्रिंसिपल के रूप में साइन इन करके। हम इसे सेट अप करने में आपकी मदद करेंगे।
-
यह आपकी चुनी हुई टेबल की एक कॉपी आपके तय किए शेड्यूल पर, हर घंटे से लेकर हर महीने तक, सिंक करता है। सिर्फ़ सिंक Fabric को छूता है, इसलिए Querri में रोज़ के सवाल आपकी कैपेसिटी पर बोझ नहीं डालते।
-
बहुत बड़ी टेबल के लिए, वे क्यूरेटेड या सारांश टेबल सिंक करें जो आपकी टीम पहले ही बना चुकी है। भारी काम Fabric करता है; सवाल Querri पूछता है।
-
Querri कभी Fabric में वापस नहीं लिखता, और आपका डेटा कभी किसी मॉडल को ट्रेन करने में इस्तेमाल नहीं होता।
FAQ
Querri और Fabric की तुलना करते समय लोग जो सवाल पूछते हैं
क्या Querri, Microsoft Fabric का विकल्प है?
बिना डेटा इंजीनियरों वाली उस टीम के लिए जिसे व्यावसायिक जवाब चाहिए, Querri वह सब कवर करता है जिसके लिए वह Fabric का इस्तेमाल करती: सिस्टम कनेक्ट करना, डेटा स्टोर और साफ़ करना, मेट्रिक्स परिभाषित करना, डैशबोर्ड और AI। भारी डेटा इंजीनियरिंग, कई टेराबाइट, स्ट्रीमिंग या मशीन लर्निंग के लिए Fabric ज़्यादा मज़बूत प्लेटफ़ॉर्म है, और Querri उसके साथ-साथ चल सकता है।
Microsoft Fabric की मासिक लागत कितनी है?
Fabric का बिल US East में $0.18 प्रति CU-घंटा पर कैपेसिटी के हिसाब से बनता है। F2 pay-as-you-go पर $262.80 प्रति माह और F64 $8,409.60 है, एक साल के रिज़र्वेशन पर लगभग 41% कम। F64 से नीचे, Power BI कंटेंट देखने वाले हर व्यक्ति को Pro ($14) या Premium Per User ($24) लाइसेंस भी चाहिए। Querri एक पूर्वानुमेय प्लान है, जिसमें AI, डैशबोर्ड और असीमित दर्शक शामिल हैं; मौजूदा प्लान देखें।
Fabric थ्रॉटलिंग क्या है, और रिपोर्ट फ़ेल क्यों होती हैं?
Fabric समय के साथ उपयोग को स्मूद करता है, फिर जब कोई कैपेसिटी अपनी क्षमता से ज़्यादा इस्तेमाल कर लेती है तो थ्रॉटल करता है। भविष्य की कैपेसिटी के 10 मिनट पार होने पर नए इंटरैक्टिव अनुरोधों में 20 सेकंड की देरी होती है; 60 मिनट पार होने पर वे अस्वीकार होते हैं; 24 घंटे पार होने पर सभी अनुरोध अस्वीकार होते हैं। लोगों को दिखता है, "आपके संगठन की Fabric कंप्यूट कैपेसिटी अपनी सीमा पार कर चुकी है।" Querri में थ्रॉटल होने वाली कोई कैपेसिटी नहीं है: सवाल आपके प्लान के क्रेडिट भत्ते के भीतर चलते हैं।
Fabric capacity overage क्या है, और क्या यह डिफ़ॉल्ट रूप से चालू है?
Capacity overage एक कैपेसिटी को अपनी सीमा से आगे चलते रहने देता है और अतिरिक्त उपयोग को pay-as-you-go दर के 3x पर बिल करता है। Microsoft के दस्तावेज़ कहते हैं कि यह नई कैपेसिटी के लिए डिफ़ॉल्ट रूप से चालू है, 25% की डिफ़ॉल्ट सीमा के साथ, और वास्तविक शुल्क इस सीमा से ज़्यादा हो सकते हैं। आप इसे बदल सकते हैं या बंद कर सकते हैं। Querri कभी भी ओवरएज के लिए अपने आप शुल्क नहीं लेता।
क्या Fabric में Copilot का अलग से शुल्क लगता है?
Fabric और Power BI में Copilot के लिए F2 या उससे ऊपर की सशुल्क कैपेसिटी चाहिए और यह ट्रायल कैपेसिटी पर उपलब्ध नहीं है। इसका अलग शुल्क नहीं है, पर यह वही कैपेसिटी खर्च करता है जो आपकी रिपोर्ट और पाइपलाइन करती हैं, इसलिए भारी इस्तेमाल से थ्रॉटलिंग हो सकती है। $30 प्रति यूज़र प्रति माह वाला Microsoft 365 Copilot भी Power BI मॉडल से जवाब दे सकता है। Querri में AI हर प्लान में शामिल है।
क्या Power BI के लिए मुझे F64 चाहिए?
Copilot के लिए नहीं: F2 काफ़ी है। F64 देखने के लिए मायने रखता है: F64 से नीचे, Power BI कंटेंट के हर दर्शक को Pro या PPU लाइसेंस चाहिए, और मुफ़्त देखना F64 से शुरू होता है, सूची मूल्य पर लगभग $8,400 प्रति माह। Querri, Free समेत हर प्लान पर असीमित डैशबोर्ड दर्शक देता है।
क्या Querri का DuckDB इंजन Spark की तुलना में पर्याप्त तेज़ है?
व्यावसायिक डेटा के लिए, आमतौर पर ज़्यादा तेज़। DuckDB एक ही मशीन पर इन-प्रोसेस एनालिटिकल क्वेरी चलाता है, कोई क्लस्टर शुरू किए बिना, इसलिए लाखों पंक्तियों पर क्वेरी सेकंडों में लौटती हैं। Spark को काम कई मशीनों में बाँटने के लिए समन्वय की कीमत चुकानी पड़ती है, जो तभी फ़ायदेमंद है जब डेटा एक मशीन के लिए बहुत ज़्यादा बड़ा हो। कई टेराबाइट या पेटाबाइट के लिए Fabric के डिस्ट्रिब्यूटेड इंजन सही टूल हैं।
Querri कितना डेटा संभाल सकता है?
Querri उस डेटा के लिए बना है जिस पर व्यवसाय चलते हैं: CRM, अकाउंटिंग, ERP, विज्ञापन, पेमेंट और स्प्रेडशीट, आमतौर पर मेगाबाइट से सैकड़ों गीगाबाइट तक। हर फ़ाइल 2 GB तक अपलोड होती है, और स्टोरेज आपके प्लान के साथ बढ़ता है। अगर आपका डेटा कई टेराबाइट है, तो उसके लिए सही जगह एक वेयरहाउस या लेकहाउस है, और Querri आपके सिंक किए गए सारांश टेबल से जवाब दे सकता है।
क्या Querri, Microsoft Fabric या OneLake से कनेक्ट होता है?
हाँ, अपने SQL Server कनेक्टर के ज़रिए। Fabric वेयरहाउस और लेकहाउस SQL एंडपॉइंट वही प्रोटोकॉल इस्तेमाल करते हैं जो SQL Server करता है, इसलिए Querri आपकी चुनी हुई टेबल सिंक कर सकता है, रीड एक्सेस वाले Microsoft Entra सर्विस प्रिंसिपल के रूप में साइन इन करके। यह SQL Server और Azure SQL डेटाबेस, Excel और CSV फ़ाइलों और 125+ व्यावसायिक सिस्टम से भी कनेक्ट होता है, उन सिस्टम समेत जो Microsoft के बाहर हैं।
क्या Querri मेरे डेटा पर लाइव क्वेरी करता है?
आपका Fabric डेटा नहीं। Querri आपके Fabric सोर्स की एक कॉपी आपके तय शेड्यूल पर, हर घंटे से हर महीने तक, अपने स्टोरेज में Iceberg टेबल में Parquet के रूप में सिंक करता है। हर जवाब ताज़ा सिंक को दर्शाता है, और आपके सोर्स सिस्टम पर क्वेरी की बौछार के बजाय एक शेड्यूल किया गया रीड होता है। अपवाद Snowflake और Databricks हैं, जहाँ कोई टेबल वेयरहाउस में ही रह सकती है और Scale प्लान में Live क्वेरी की जा सकती है।
क्या Querri इतना सुरक्षित है कि Microsoft 365 के साथ रह सके?
Querri, SOC 2 Type II, HIPAA और ISO 27001:2022 प्रमाणित है। हर संगठन का अपना डेटाबेस और स्टोरेज है, पंक्ति-स्तर की एक्सेस नीतियाँ चैट, डैशबोर्ड और MCP में एक समान लागू होती हैं, और आपका डेटा कभी किसी मॉडल को ट्रेन करने में इस्तेमाल नहीं होता। Microsoft की पहचान और कंप्लायंस की चौड़ाई ज़्यादा है, और अगर Entra और Purview को हर बाइट पर गवर्नेंस करनी है, तो यह Fabric में बने रहने की एक वजह है।
बिना डेटा इंजीनियरों वाली टीम के लिए Microsoft Fabric का सबसे अच्छा विकल्प क्या है?
ऐसा विकल्प जिसे पहले जवाब से पहले पाइपलाइन, सिमेंटिक मॉडल और कैपेसिटी की ज़रूरत न हो। Querri आपके सिस्टम कनेक्ट करता है, डेटा अपने आप साफ़ करता है, सरल भाषा में आपकी परिभाषाएँ सीखता है और पूछने पर डैशबोर्ड बनाता है, एक पूर्वानुमेय प्लान पर। आप मुफ़्त प्लान से शुरू कर सकते हैं।
क्या Power BI Q&A काम करता रहेगा?
Microsoft दिसंबर 2026 के अंत तक Power BI Q&A को बंद कर रहा है और उपयोगकर्ताओं को Copilot की ओर भेज रहा है, जिसके लिए सशुल्क Fabric कैपेसिटी या Microsoft 365 Copilot लाइसेंस चाहिए। Querri हर प्लान में सरल भाषा में सवाल पूछने की सुविधा देता है।
क्या मैं पहले अपने डेटा पर Querri आज़मा सकता हूँ?
हाँ। आप बिना किसी क्रेडिट कार्ड के मुफ़्त प्लान से शुरू कर सकते हैं, एक सोर्स जोड़ें और पूछें। हर प्लान में क्या शामिल है, यह जानने के लिए प्लान देखें। या अपना सबसे कठिन सवाल 20 मिनट के वॉकथ्रू में लाएँ।
स्रोत
ये तथ्य कहाँ से आते हैं
15 अक्टूबर 2026 को जाँचा गया। Microsoft अक्सर Fabric में बदलाव करता है; अगर यहाँ कुछ पुराना है, तो हमें बताएँ और हम उसे ठीक कर देंगे।
- Microsoft Fabric pricing Microsoft Azure
- Azure Retail Prices API (Fabric CU-hour rates) Microsoft Azure, Oct 2026
- Power BI pricing Microsoft
- Microsoft Fabric licenses (viewers below F64) Microsoft Learn
- Copilot in Fabric overview Microsoft Learn
- The Fabric throttling policy Microsoft Learn
- Enable capacity overage Microsoft Learn
- Pause and resume your capacity Microsoft Learn
- Surge protection Microsoft Learn
- Evaluate and optimize your capacity Microsoft Learn
- Fabric Capacity Metrics app Microsoft Learn
- Spark job concurrency and queueing Microsoft Learn
- OneLake overview Microsoft Learn
- Direct Lake overview Microsoft Learn
- Extending Polaris to support transactions (the Fabric Warehouse engine) Microsoft, arXiv, Jan 2024
- FabCon and SQLCon 2026 in Barcelona Microsoft Azure blog, Sep 2026
- Power BI Q&A retirement (MC1218421) Microsoft 365 Message Center, Jan 2026
- Fabric IQ roadmap Directions on Microsoft, Aug 2026
- "All of my Power BI reports are failing" Microsoft Q&A, Jan 2026
- Fabric capacity stuck in Pausing Microsoft Q&A, Apr 2026
- Unusual Fabric cost increase on an F8 reservation Microsoft Q&A, Nov 2025
- Well-Architected: cost optimization for Microsoft Fabric Microsoft Learn
- Why you should enable capacity overage Actionable Reporting, Mar 2026
- Microsoft Fabric, two years later Hylaine (Microsoft partner), Dec 2025
- 10 things I hate about Fabric deployment pipelines Data Savvy (Meagan Longoria), Aug 2026
- Fabric benchmark: Spark versus Python notebooks endjin, Apr 2026
- Microsoft Fabric pricing and licensing AlphaBOLD, Aug 2026
- What does a Microsoft Fabric implementation really cost? Towards AI, Sep 2026
- Why DuckDB DuckDB
- Big Data is Dead MotherDuck (Jordan Tigani), Feb 2023
- Is Big Data Dead? MotherDuck and the small data manifesto DataCamp podcast (Ryan Boyd), Oct 2024
- Querri pricing Querri
- Predictable credit use Querri docs
कैपेसिटी का आकार तय करने से पहले देखें कि आपका अपना डेटा कैसे जवाब देता है
एक सिस्टम कनेक्ट करें या एक स्प्रेडशीट डालें, वह सवाल पूछें जो सबसे ज़्यादा मायने रखता है, और जवाब के पीछे की क्वेरी देखें। अगर Fabric बेहतर फ़िट है, तो हम आपको बताएँगे।