Wenn Ihnen eine KI schon einmal eine Zahl geliefert hat, die im Meeting zerfiel, sind Sie nicht allein.
Jede Antwort beruht auf Entscheidungen. Querri sagt Ihnen, wann es eine getroffen hat. Es prüft Ihre Daten vor der Abfrage, rechnet die Antwort auf zwei unabhängigen Wegen und hält die Abfrage hinter jeder Zahl für alle lesbar offen.
In der App
Die Prüfungen, so wie sie in Querri aussehen.
Dies sind Screenshots von Querri mit den Daten eines Demo-Unternehmens. Hinweise, Weg und Abfrage stehen direkt neben jeder Zahl.
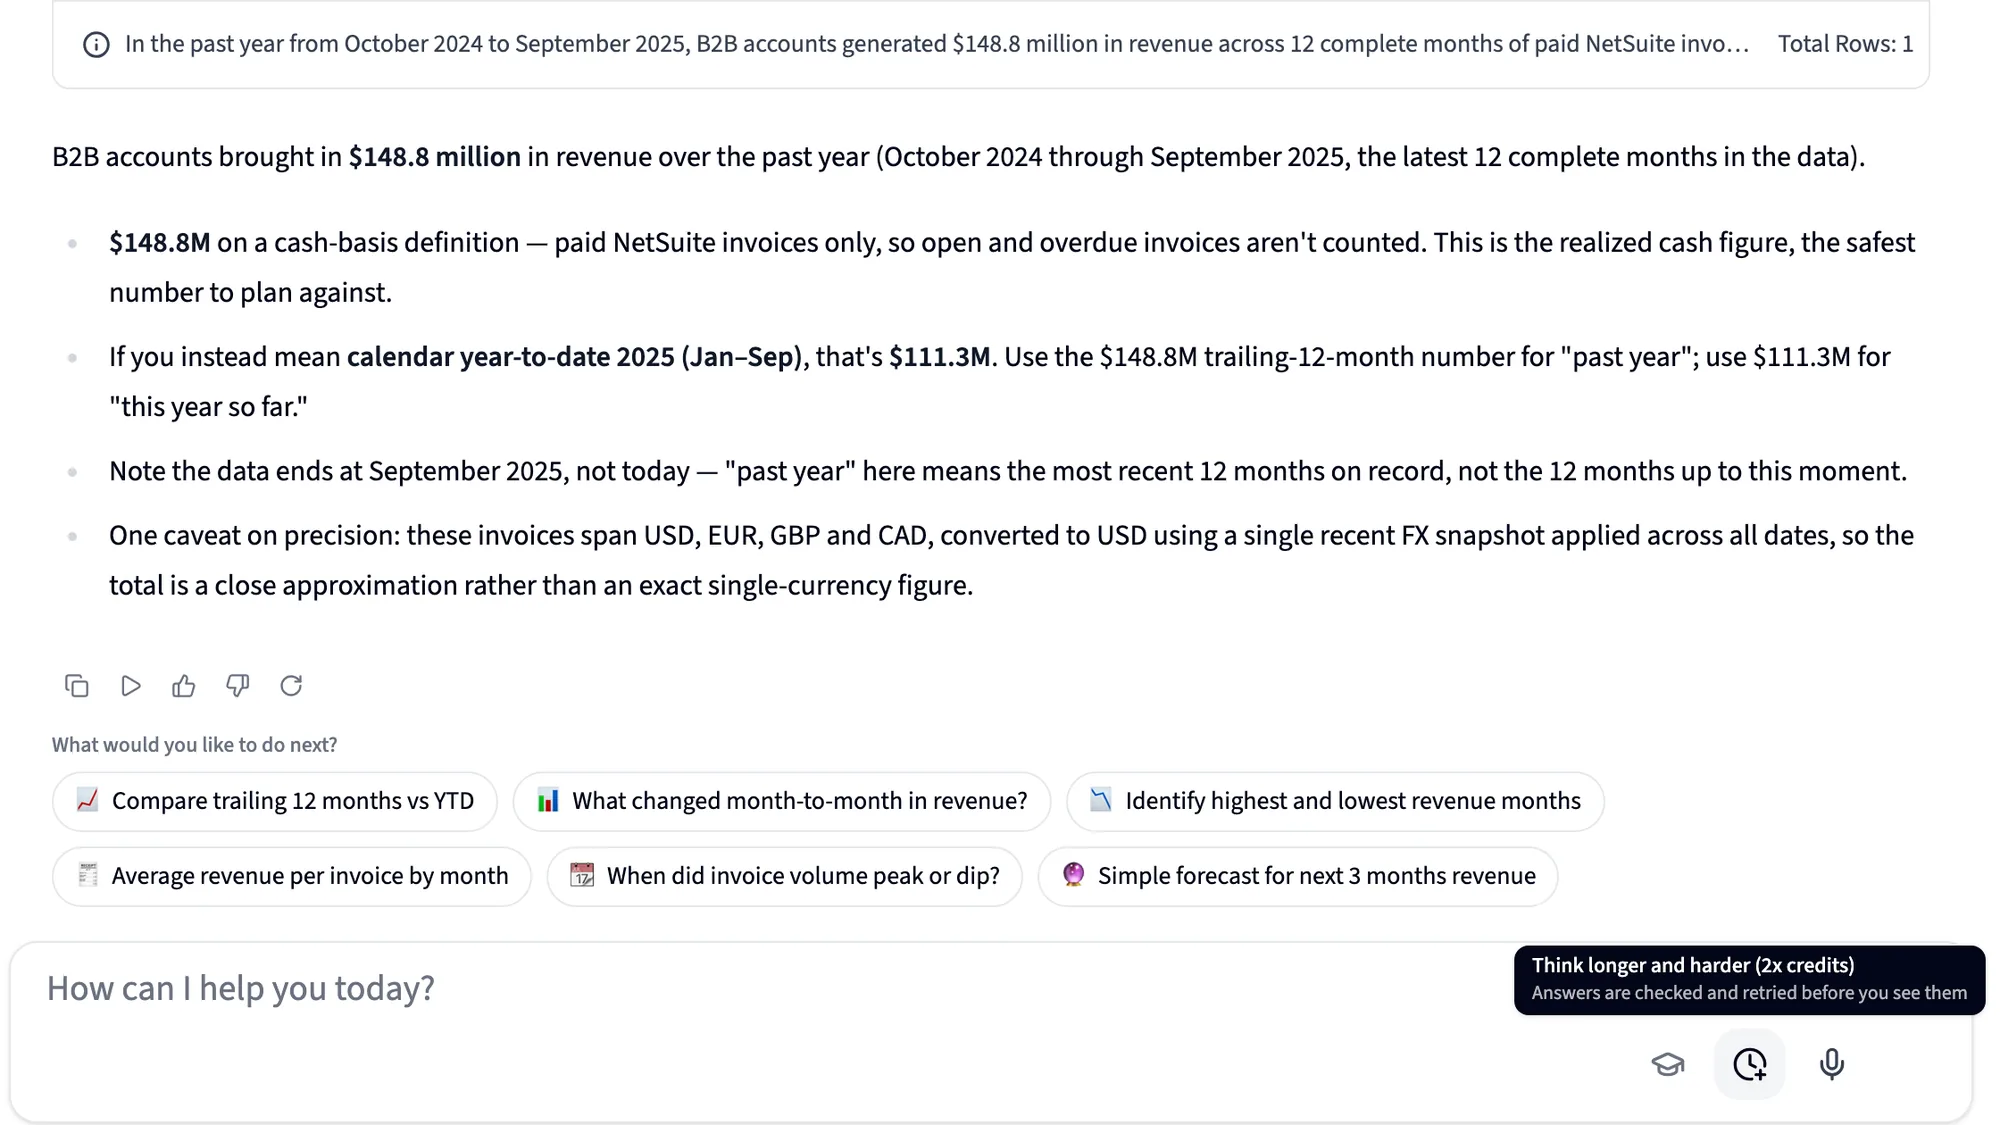
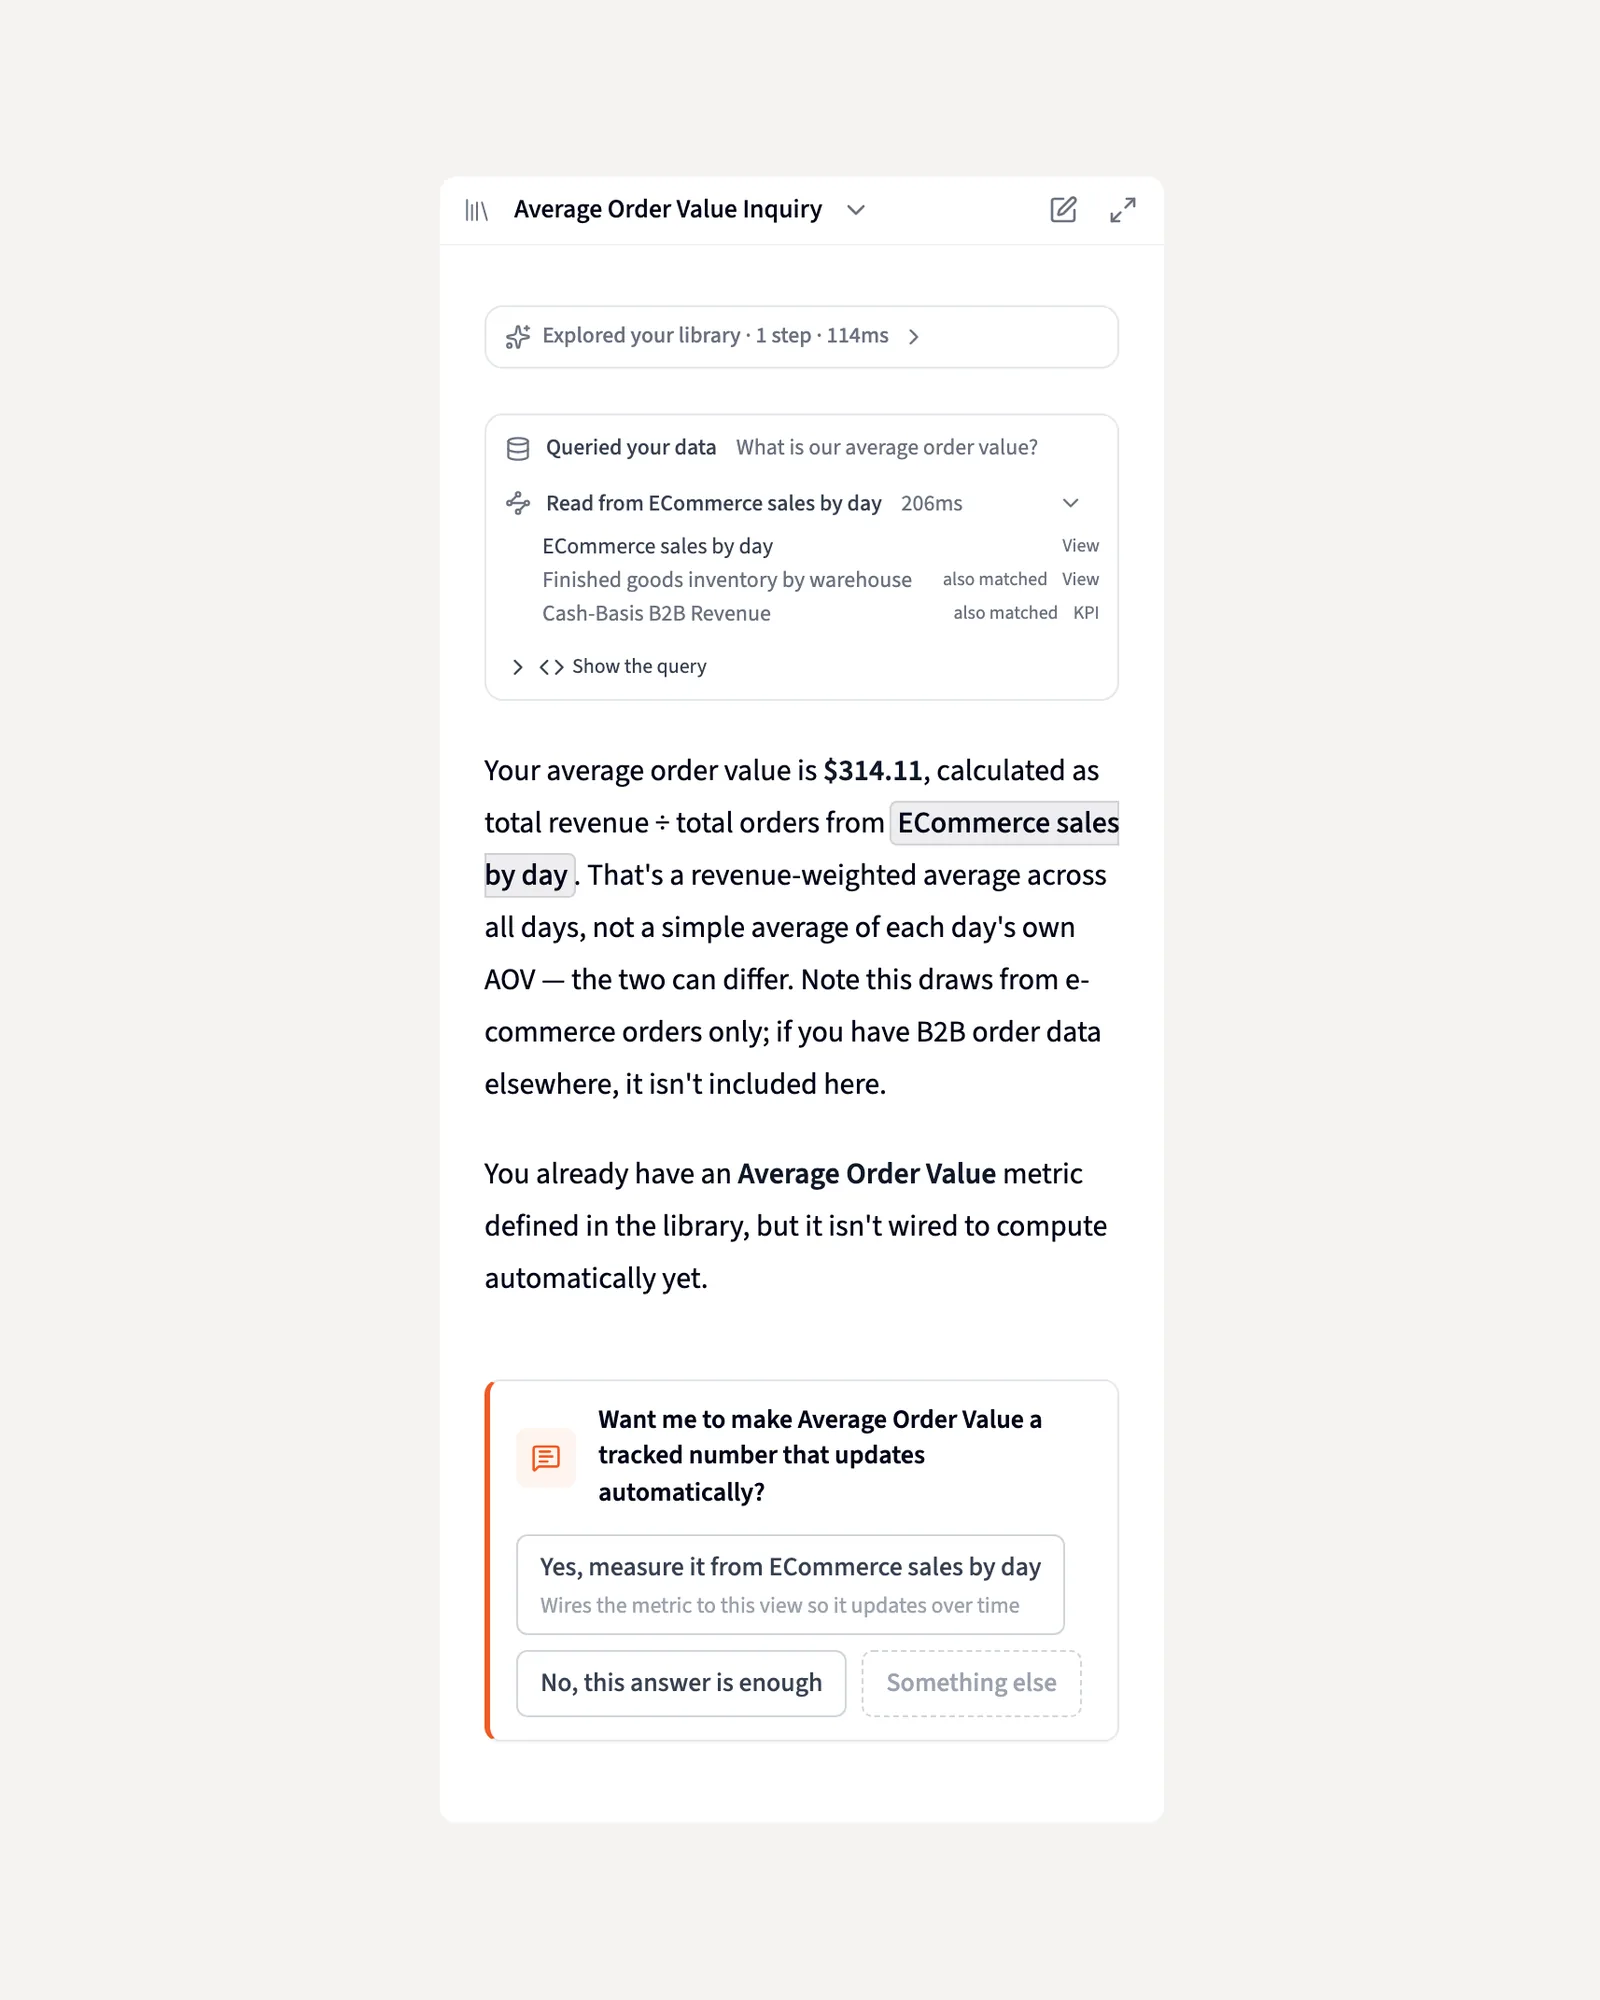
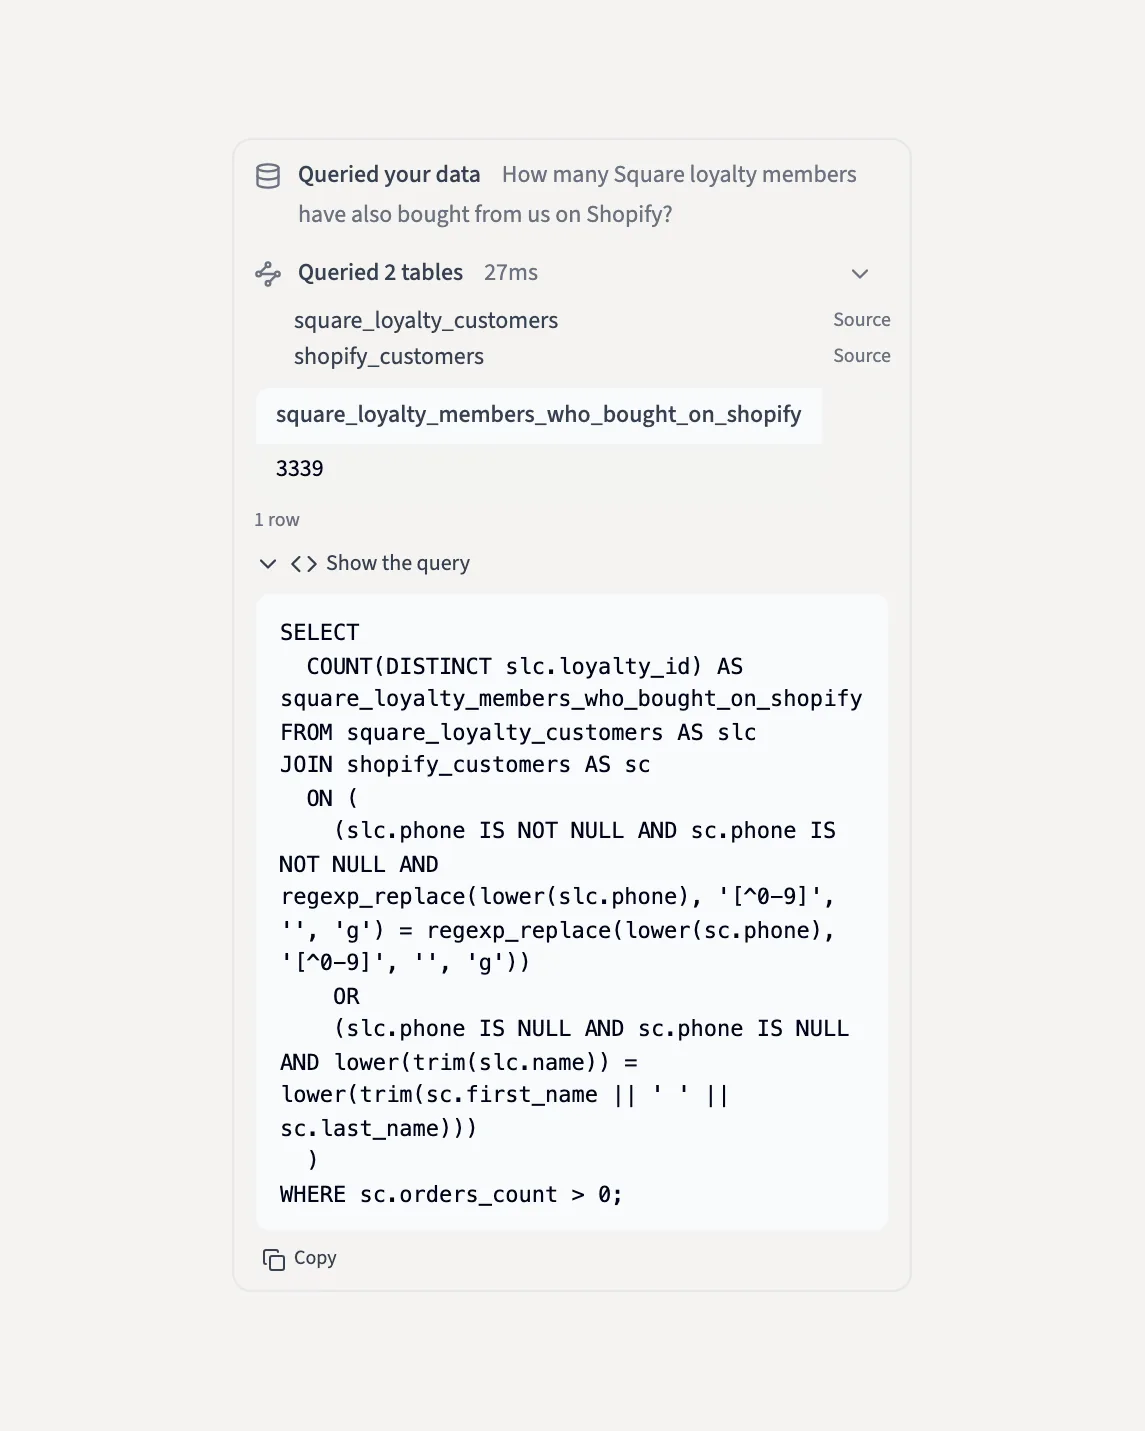
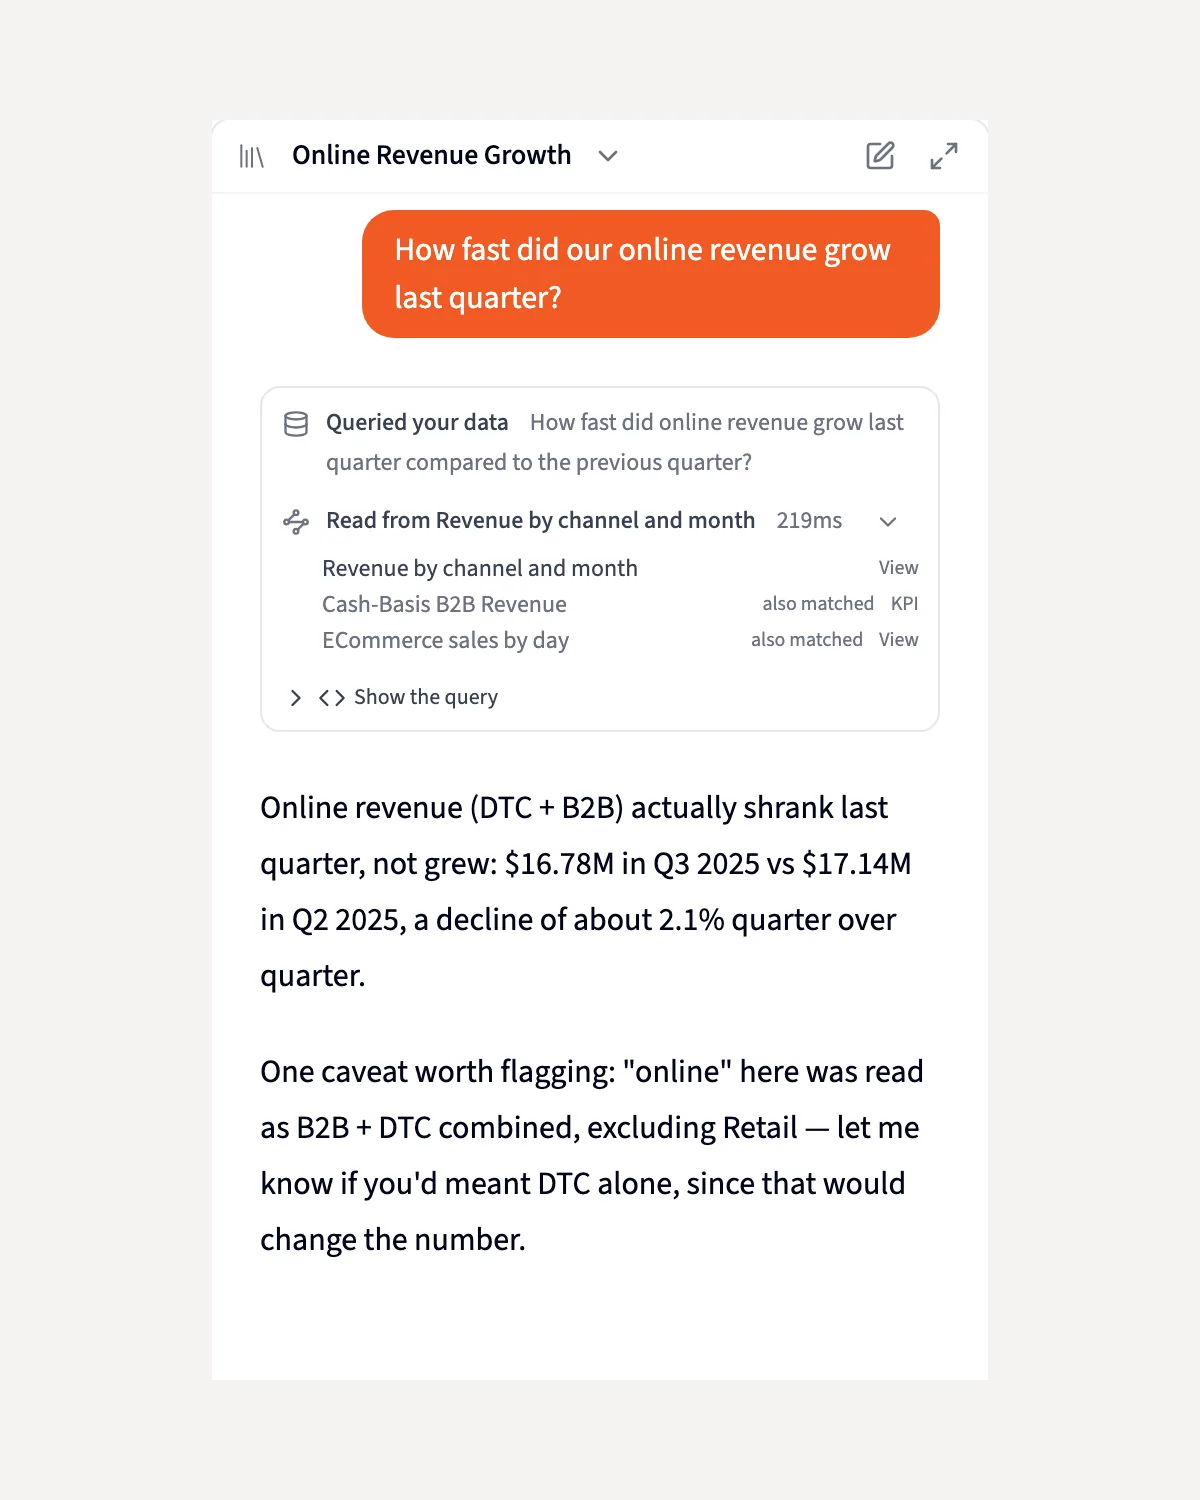
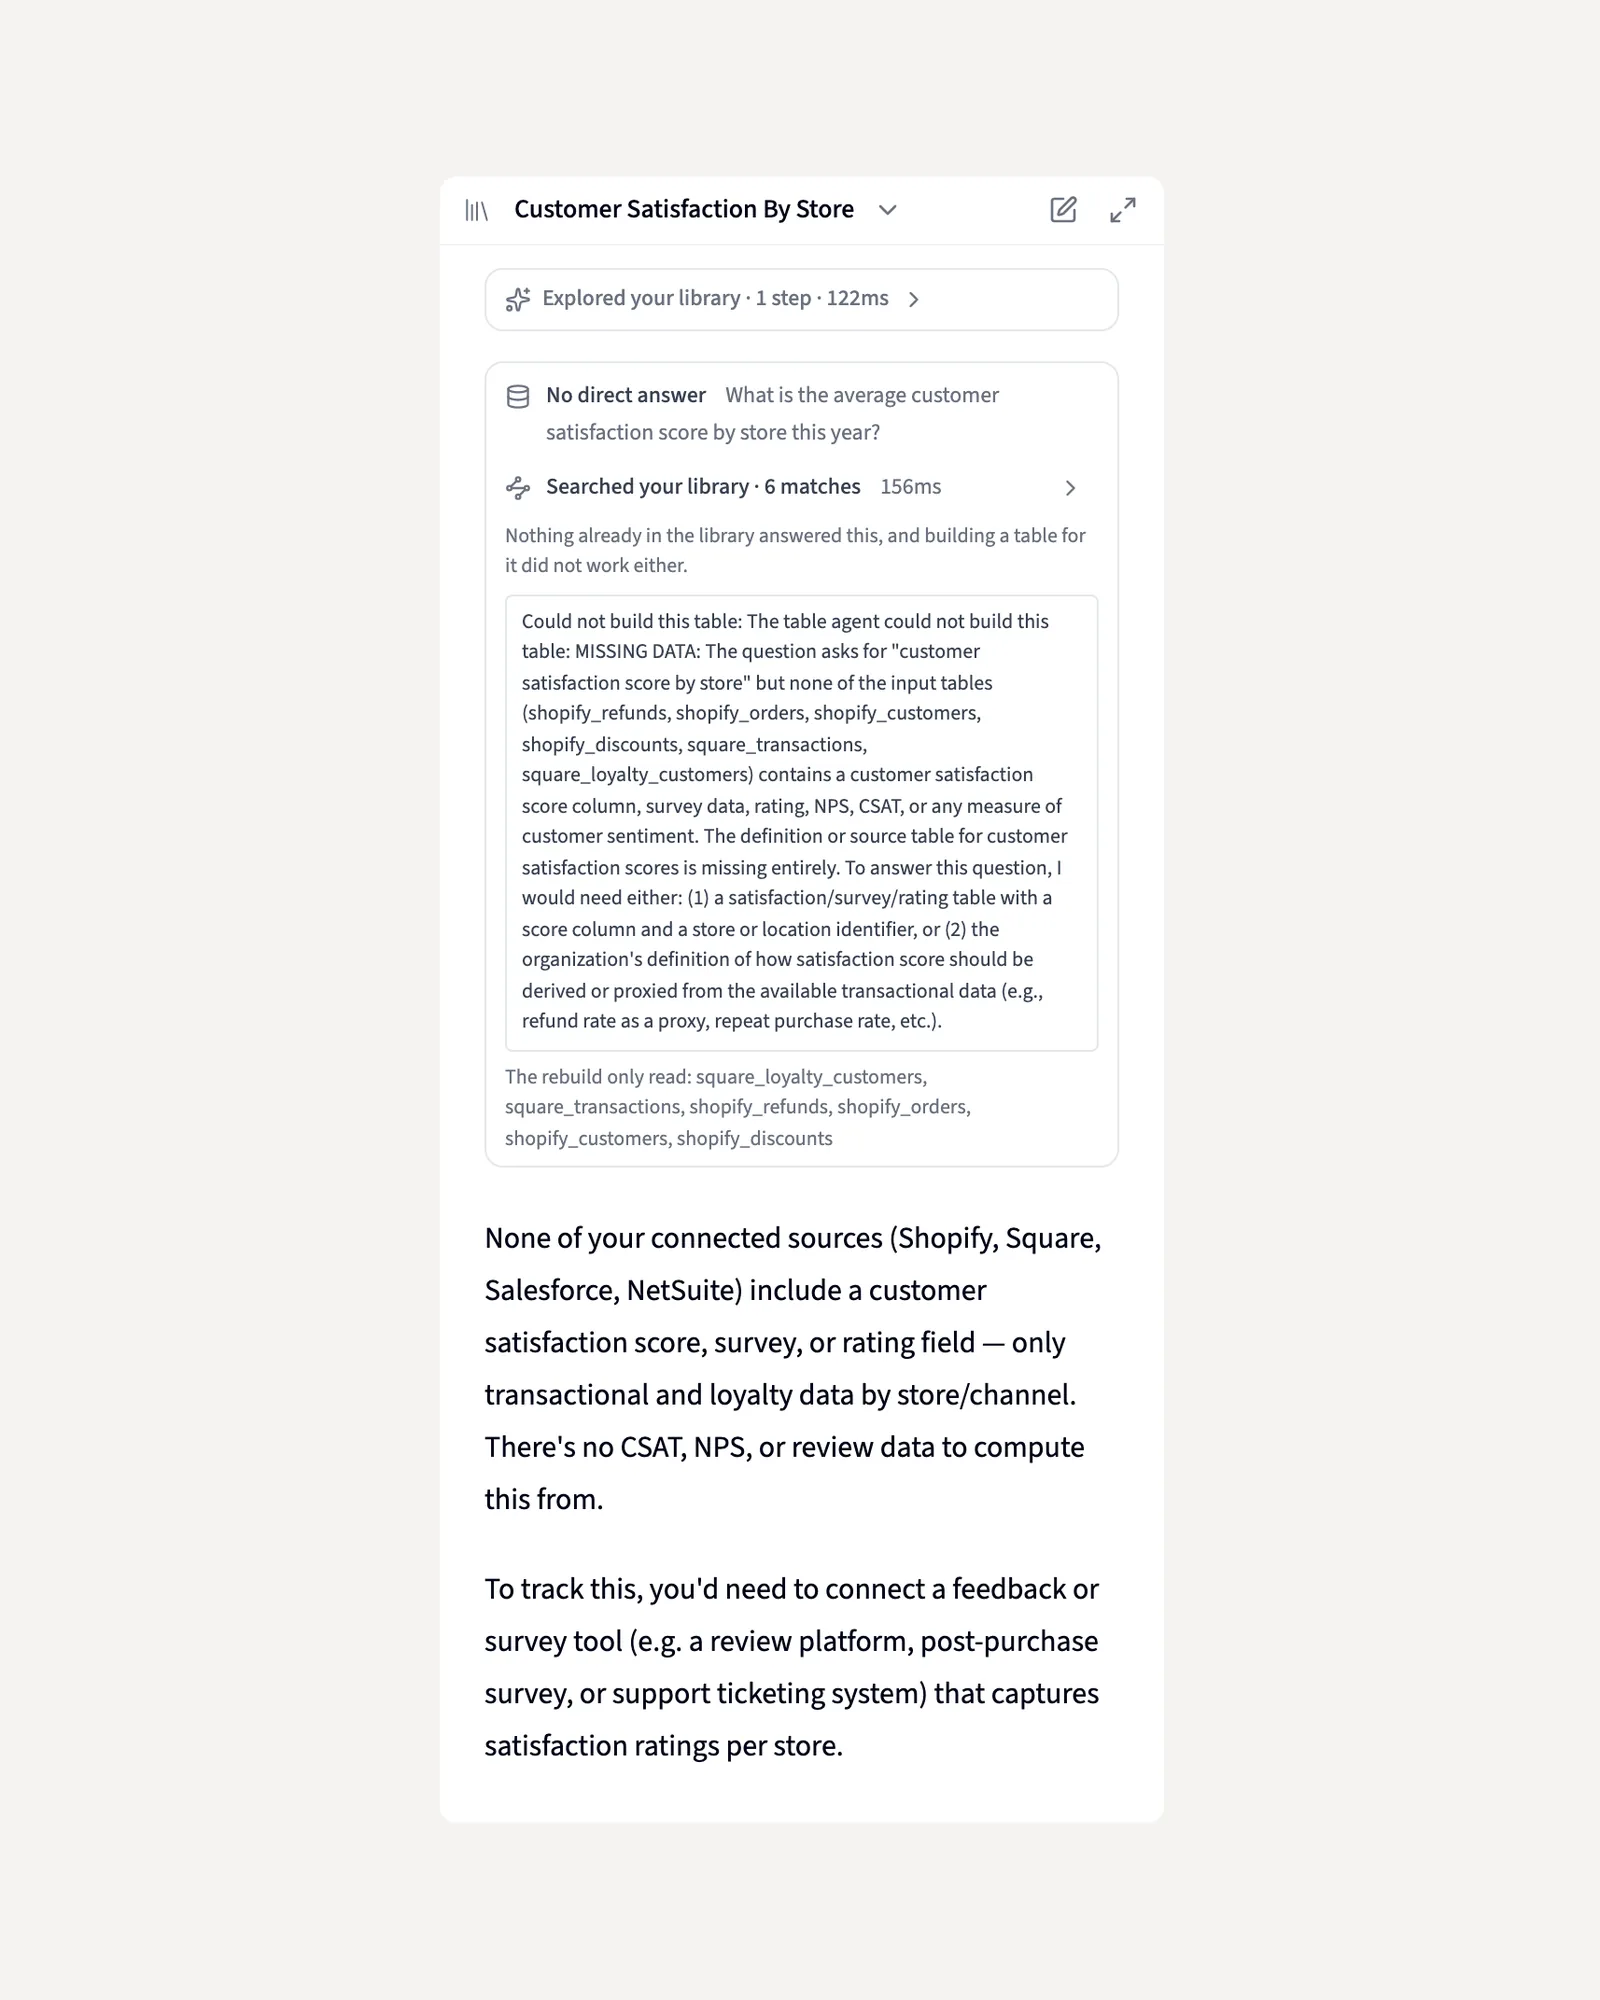
Querri prüft seine Arbeit, damit Sie es nicht müssen.
Es prüft Ihre Daten vor der Analyse und das Ergebnis danach, sagt Ihnen, was es nicht klären konnte, und führt jede Zahl auf ihre Quelle zurück.
Es prüft die Daten, bevor es die Abfrage schreibt
Ein Durchgang über die betroffenen Spalten zählt doppelte IDs und ob sie sich widersprechen, denselben Wert in vielen Schreibweisen, Text, der nur leer aussieht („N/A“, „-“), und Werte, die sich nicht in Zahl oder Datum umwandeln lassen.
Es rechnet die Antwort auf einem zweiten Weg
Ein separater Weg rechnet die Antwort aus denselben Daten und Ihren Definitionen, ohne die erste Abfrage zu sehen. Beide Ergebnisse werden Zeile für Zeile verglichen, und Sie erfahren, wenn sie abweichen.
Es zeigt, wie stark eine Bereinigung die Zahl verschoben hat
Lassen Sie die stornierten Aufträge weg, und die Summe ändert sich. Querri sagt Ihnen, um wie viel. So taucht eine Bereinigung, um die niemand gebeten hat, als Hinweis auf, statt die Antwort still zu verändern.
Es sagt es, wenn es etwas nicht prüfen konnte
Wenn eine Prüfung nicht gelaufen ist, steht das klar in der Antwort. Schweigen gilt nie als sauber.
Hat eine Frage zwei faire Antworten, erhalten Sie beide Zahlen.
„Durchschnittliche Zustellungen pro Tag“ kann pro Arbeitstag oder pro Kalendertag heißen. Querri nennt die Lesart, die es verwendet hat, rechnet die andere aus und sagt Ihnen, wofür sich jede eignet.
Bei Benchmark-Fragen mit mehr als einer vertretbaren Antwort wies Querri in 73 % der Fälle auf die andere sinnvolle Lesart hin, gegenüber 12 % bei einem führenden universellen KI-Agenten.
Stellen Sie Ihre Frage. Der Bibliothekar weiß, wo die Antwort liegt.
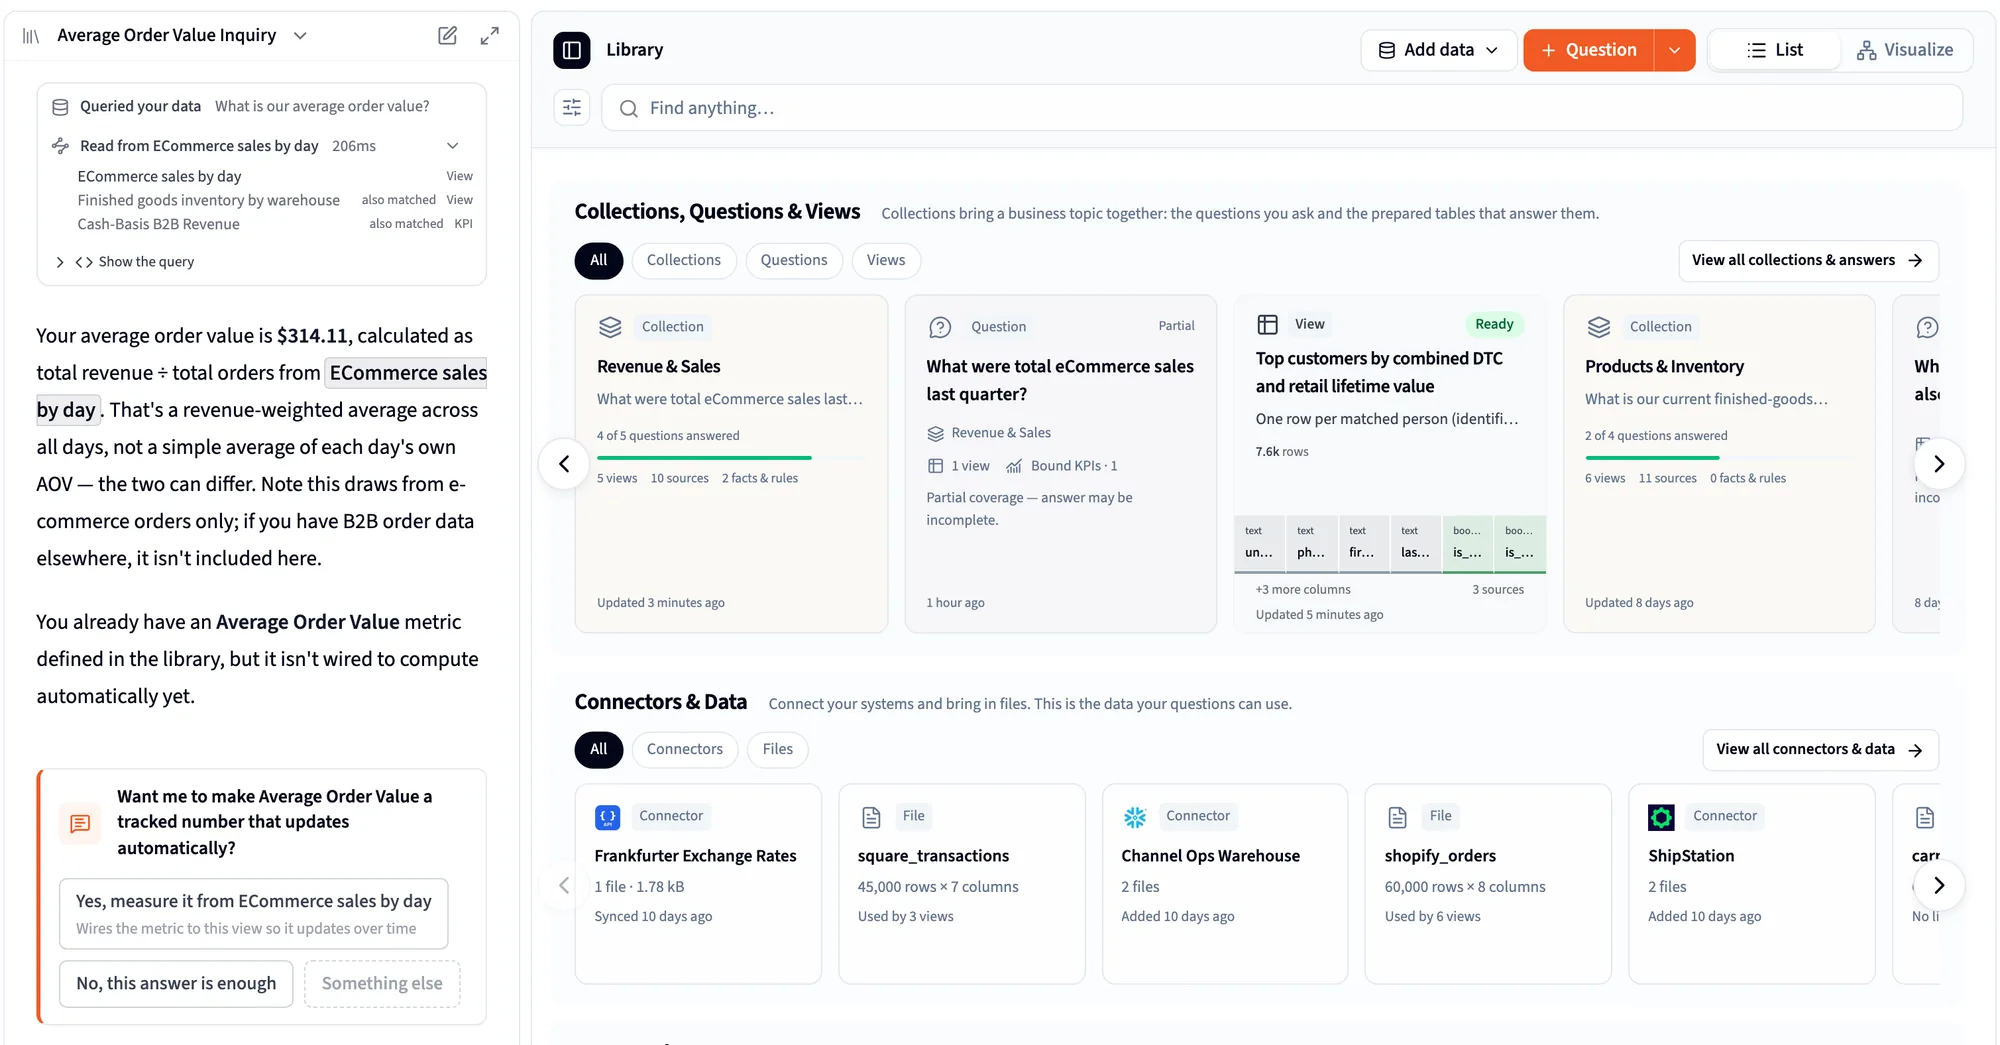
Der Bibliothekar liest zuerst aus einer gespeicherten Ansicht oder einem KPI, der die Frage eindeutig abdeckt, und schreibt erst dann SQL auf Ihre Quelltabellen. Ob eine Ansicht passt, entscheidet Code, nicht der Prompt. Deshalb lehnt er lieber ab, als zu raten.
- Jede Antwort zeigt ihren Weg: Read from, Queried oder Searched your library.
- Show the query öffnet das SQL, mit einem Copy-Button für die eine technische Person im Team.
- Wenn nichts passt, lautet die Antwort No direct answer, ohne erfundene Zahl.
- Antworten enthalten nur Daten, die die fragende Person sehen darf.
Die vereinbarte Zahl, mit der Abfrage dahinter
Wenn das ganze Team auf die eine Person wartet, die weiß, wo die Daten liegen, nimmt der Bibliothekar die Fragen an und antwortet mit der Zahl, auf die sich Ihr Unternehmen bereits geeinigt hat.
Ihr Unternehmen sollte dasselbe Datenproblem nicht zweimal lösen müssen.
Stellt jemand eine Frage, die das Team schon beantwortet hat, liest der Bibliothekar sie aus der gespeicherten Ansicht, zu der sie gehört. So kommt sie in Sekunden zurück, jedes Mal von derselben Stelle. Und ein geplanter Bericht kann Ihnen nächsten Monat nicht still eine andere Zahl liefern: Ein erneuter Lauf spielt den Code vom ersten Mal ab, ohne ein Modell erneut zu fragen.
Bei einer Frage, die das Unternehmen bereits beantwortet hatte, war die Wiederverwendung der gespeicherten Antwort 4,6× schneller als ein führender universeller KI-Agent, mit 2,8× weniger Tokens und 6,1× geringeren Kosten.
Eine neue Frage wird frisch berechnet, mit denselben Definitionen. Schritte, die bewusst ein Modell nutzen (Researcher, Categorize und Wrapped-Präsentationen), rufen es bei jedem Lauf erneut auf.
Hatten wir das nicht schon beantwortet?
Ja, und jetzt kommt es in Sekunden zurück. Die Wegzeile zeigt, woher die Zahl stammt, und die Abfrage ist einen Klick entfernt.
Sie entscheiden, wann eine Antwort die volle Prüfung bekommt.
Der gründliche Modus, die Voreinstellung, prüft jede erstellte Tabelle in einem zweiten Durchgang, gleicht sie mit einer unabhängigen Herleitung ab und wiederholt eine Tabelle, die durchfällt. Der schnelle Modus ist ein einziger Durchgang mit demselben Kontext und ohne diese Prüfungen, und sein Label sagt das. Sie wählen pro Nachricht.
Es prüft seine Arbeit wie ein sorgfältiger Analyst.
Zuerst die Daten ansehen
Vor der Abfrage misst Querri die Spalten, die die Frage berührt, mit demselben Zeilenfilter, mit dem die Abfrage laufen wird.
Auf zwei Wegen rechnen
Zwei Wege, beide ausgehend von Ihren eigenen Definitionen und Regeln, berechnen die Antwort getrennt und werden Zeile für Zeile verglichen.
Zusammenfassung prüfen, Abfrage behalten
Jede Zahl in der schriftlichen Zusammenfassung wird mit dem Ergebnis abgeglichen, und die Abfrage dahinter bleibt für alle lesbar.
Die IT setzt die Leitplanken. Wer die Daten kennt, legt ihre Bedeutung fest. Alle anderen fragen einfach.
Datennutzer
Gehen Sie ins Meeting und wissen Sie, dass Ihre Zahl hält. Hat eine Frage zwei faire Lesarten, sagt Querri es Ihnen, bevor es jemand anderes tut, und können die Daten nicht antworten, sagt es das, statt zu raten.
Datenverantwortliche
Hören Sie auf, jede KI-Antwort von Hand nachzuprüfen. Querri prüft die Daten auf Lücken und Duplikate, rechnet die Antwort auf zwei Wegen und zeigt die Abfrage. So dauert das Prüfen einer Zahl eine Minute, nicht einen Nachmittag.
Datenteam und IT
KI, die Sie prüfen können. Das Modell schreibt Code, der Code läuft in Querri mit zuerst angewendeten Zugriffsregeln, und jede Zahl lässt sich auf ihre Abfrage und Quelle zurückführen. Ein gespeicherter Bericht läuft exakt gleich.
Häufige Fragen
Bekommt jede Antwort die volle Prüfung?
Jede Tabelle, die Querri erstellt, im gründlichen Modus, der Voreinstellung. Prognosen und andere Python-Schritte erhalten die Zahlenprüfung ihrer Zusammenfassung und zeigen ihren Code. Wählen Sie den schnellen Modus für einen raschen Überblick, sagt Ihnen das Label, dass das Review übersprungen wurde.
Was passiert, wenn meine Daten die Frage nicht beantworten können?
Querri sagt es, statt zu schätzen. In der Bibliothek lautet die Antwort des Bibliothekars No direct answer, ohne erfundene Zahl. In einem Projekt probiert Querri die anderen passenden Quellen aus, bevor es sagt, dass Daten fehlen, und nennt die geprüften Quellen.
Liefert mir ein gespeicherter Bericht nächsten Monat eine andere Zahl?
Nicht von selbst. Ein erneuter Lauf einer gespeicherten Ansicht, eines Projekts, einer Dashboard-Aktualisierung oder eines geplanten Berichts spielt den Code vom ersten Mal ab. Eine neue Frage wird frisch berechnet, mit denselben Definitionen. Schritte, die bewusst ein Modell nutzen, etwa Researcher, Categorize und Wrapped-Präsentationen, rufen es bei jedem Lauf erneut auf.
Rechnet die KI selbst?
Nein. Die KI schreibt SQL und Python, die auf Ihren Daten laufen, und Diagramme werden aus diesen Ergebnissen gezeichnet. Deshalb kann jede Zahl die Abfrage dahinter zeigen.
Lassen so viele Hinweise die Leute der Antwort nicht weniger vertrauen?
Die Antwort steht zuerst, die Hinweise darunter. Eine saubere Tabelle, die das Review bestanden hat, zeigt gar keine Warnung. Ein Hinweis erscheint nur, wenn es etwas Zutreffendes zu sagen gibt, und genau das möchten Sie vor dem Meeting wissen.
Wie genau ist es?
Gemessen an den Quelldaten beantwortete Querri 97 % der mehrdeutigen Benchmark-Fragen richtig, gegenüber 80 % bei einem führenden universellen KI-Agenten.
Wer kann eine Antwort sehen, und werden meine Daten zum Trainieren eines Modells verwendet?
Antworten enthalten nur Daten, die die fragende Person sehen darf, denn Zugriffsregeln werden angewendet, bevor eine Abfrage läuft. Ihre Daten trainieren nie ein Modell. Querri ist nach SOC 2 Type II, HIPAA und ISO 27001:2022 zertifiziert.
Verwandte Themen
Stellen Sie die Frage, an der Ihre letzte KI gescheitert ist.
Bringen Sie Ihre schwierigste Frage zu einer geführten Demo mit und sehen Sie, wie Querri Schritt für Schritt zu einer Antwort kommt.