ऑपरेशंस और फ़ाइनेंस बिना नोटबुक के Databricks से जवाब कैसे पाएँ?
मुश्किल क्यों है
टेबल साफ़ और डॉक्यूमेंटेड हैं, पर उन्हें पढ़ने के तरीके सिर्फ़ नोटबुक, SQL एडिटर या किसी और का बनाया डैशबोर्ड हैं।
 Databricks + Querri
ऑपरेशंस, फ़ाइनेंस और सेल्स जो जानना चाहते हैं, वह lakehouse में है। Querri आपकी चुनी हुई टेबल को आपके बाकी बिज़नेस के साथ एक Library में रखता है, Databricks में Live क्वेरी करके या कॉपी के रूप में सिंक करके, ताकि कोई भी उनके बारे में आम भाषा में पूछ सके और आपकी टीम की परिभाषाओं के साथ जवाब पाए।
Querri, Databricks से सिर्फ़ पढ़ता है, और क्रेडेंशियल एन्क्रिप्टेड रहते हैं, एजेंट की नज़र से दूर। SOC 2 Type II, HIPAA और ISO 27001:2022 प्रमाणित।
Databricks रिपोर्टिंग क्यों अटक जाती है
डेटा इंजीनियर Databricks पर इसलिए आते हैं क्योंकि यह पाइपलाइन का मुश्किल काम संभालता है। दिक्कत बाद में आती है, जब डेटा टीम के बाहर किसी को उसमें रखे डेटा के बारे में सवाल पूछना होता है।
कोई रीजनल मैनेजर नोटबुक या SQL एडिटर नहीं खोलेगा। हर सवाल डेटा टीम के लिए एक अनुरोध बन जाता है, और कतार टीम से तेज़ बढ़ती है।
Net revenue एक नोटबुक में CASE statement है, दूसरी में dbt मॉडल, और किसी डैशबोर्ड क्वेरी में थोड़ा अलग फ़िल्टर। इंजीनियरिंग के बाहर कोई नहीं देख सकता कि सही कौन-सा है।
Classic और pro SQL warehouse डिफ़ॉल्ट रूप से रुकने से पहले 45 मिनट खाली रहने का इंतज़ार करते हैं, serverless वाले 10 मिनट। दिन भर आते रहने वाले इक्का-दुक्का सवाल warehouse का बिल चालू रखते हैं।
नोटबुक की टेबल ज़्यादा से ज़्यादा 10,000 पंक्तियाँ या 2 MB दिखाती है, जो भी कम हो। उससे बड़ा कुछ भी डाउनलोड होता है, Excel में चिपकाया जाता है और ईमेल किया जाता है, और कॉपियाँ बिखरने लगती हैं।
Databricks के अंदर कौन कौन-सी टेबल पढ़ेगा, यह Unity Catalog तय करता है। जैसे ही कोई CSV वर्कस्पेस से बाहर जाती है, वे अनुमतियाँ उसके साथ नहीं जातीं, और हर पाने वाला हर पंक्ति देखता है।
Live या सिंक
हर टेबल Live या सिंक की हुई हो सकती है, और आप हर टेबल के लिए अलग से चुनते हैं। Live टेबल कभी Databricks से बाहर नहीं जाती: Querri सिर्फ़ उसके कॉलम और पंक्तियों की अनुमानित संख्या रखता है, हर सवाल आपके SQL warehouse पर डेटा की मौजूदा स्थिति पर चलता है, और सिर्फ़ छोटा-सा नतीजा वापस आता है।
Live
Querri हर सवाल को Databricks SQL में लिखता है और उसे आपके SQL warehouse पर चलाता है। कुछ भी कॉपी नहीं होता, शेड्यूल किए गए रिफ़्रेश पर भी नहीं। जवाब में किसी आँकड़े पर क्लिक करें, तो वह टेबल, कनेक्शन और एक Live बैज दिखाता है।
इनके लिए सबसे अच्छा
सिंक
डिफ़ॉल्ट विकल्प। Querri टेबल को अपनी स्टोरेज में कॉपी करता है और उसी कॉपी से जवाब देता है, इसलिए सवालों से कोई SQL warehouse चालू नहीं होता।
इनके लिए सबसे अच्छा
Querri हमेशा आपकी चुनी हुई टेबल पर सिर्फ़ एक SELECT भेजता है। लिखना, एक से ज़्यादा स्टेटमेंट, दूसरी टेबल, फ़ाइल रीड और session सेटिंग, Databricks तक कुछ भी पहुँचने से पहले ही ठुकरा दिए जाते हैं।
Querri में हर व्यक्ति के रो फ़िल्टर Databricks क्वेरी के अंदर लागू होते हैं, इसलिए जो पंक्तियाँ वह नहीं देख सकता, वे lakehouse से कुछ भी बाहर जाने से पहले ही छँट जाती हैं।
हर Live क्वेरी पर एक query tag होता है जिसे आप Databricks की query history में ढूँढ सकते हैं। नतीजे डिफ़ॉल्ट रूप से 100,000 पंक्तियों पर रुकते हैं, और इस सीमा से कटा नतीजा चिह्नित किया जाता है।
Live क्वेरी आपके SQL warehouse पर चलती हैं, इसलिए उसका कंप्यूट इस्तेमाल करती हैं। शेड्यूल किए गए रिफ़्रेश से पहले Querri टेबल का metadata जाँचता है, जिससे warehouse चालू नहीं होता, और अगर टेबल नहीं बदली है तो कुछ नहीं चलाता।
Live टेबल Scale प्लान में उपलब्ध हैं। Scale प्लान देखें
जिनका जवाब आखिरकार मिल सकता है
हर एक ऐसा अनुरोध है जो हर महीने lakehouse टीम के पास आता है, साथ में यह कि आज इसमें इतना समय क्यों लगता है, और Querri इसे कैसे संभालता है।
मुश्किल क्यों है
टेबल साफ़ और डॉक्यूमेंटेड हैं, पर उन्हें पढ़ने के तरीके सिर्फ़ नोटबुक, SQL एडिटर या किसी और का बनाया डैशबोर्ड हैं।
मुश्किल क्यों है
मापा गया इस्तेमाल lakehouse में आता है, जबकि इनवॉइस ERP में बनते हैं। दोनों की तुलना का मतलब है एक ऐसी पाइपलाइन जो अभी किसी ने नहीं बनाई, या महीने के आखिर की एक स्प्रेडशीट।
Querri के साथ
Databricks के साथ NetSuite कनेक्ट करें, और Querri हर ग्राहक के मापे गए इस्तेमाल को उसके usage इनवॉइस से मिलाता है। फ़ैक्ट्स और नियम में एक बार बताएँ कि कौन-से इवेंट बिल होने लायक हैं, और जिन ग्राहकों का बिल नहीं बना उनकी सूची उसी का पालन करती है।
मुश्किल क्यों है
तय की गई परिभाषा ट्रांसफ़ॉर्मेशन कोड में है। स्प्रेडशीट में वही आँकड़ा दोबारा बनाने वाला सेल्स लीड करीब पहुँचता है, और इसी "करीब" से एक मीटिंग में दो आँकड़े आ जाते हैं।
मुश्किल क्यों है
मॉडल अपना फ़ोरकास्ट एक Delta टेबल में लिखकर आगे बढ़ जाता है। हफ़्ते-दर-हफ़्ते और क्षेत्र-दर-क्षेत्र असली ऑर्डर से उसकी जाँच किसी की ज़िम्मेदारी नहीं है।
Querri के साथ
फ़ोरकास्ट टेबल और ऑर्डर टेबल कनेक्ट करें, Live या सिंक, और फ़ोरकास्ट की गलती को एक KPI के रूप में ट्रैक करें। Nightly insights हर रात हर क्षेत्र को उसके अपने इतिहास से परखता है और भटकते क्षेत्र को आपके Inbox में रखता है।
मुश्किल क्यों है
कोई क्वेरी चलाता है, नतीजा डाउनलोड करता है, शीट फ़ॉर्मैट करता है और हाथ से क्षेत्र के हिसाब से बाँटता है। जिस हफ़्ते वह छुट्टी पर हो, किसी को कुछ नहीं मिलता।
Querri के साथ
क्षेत्रवार ब्रेकडाउन को सोमवार सुबह 7 बजे चलने वाले प्रोजेक्ट के रूप में सेव करें। रिपोर्ट्स और ऑटोमेशन उसे मौजूदा डेटा पर दोबारा चलाता है और हर मैनेजर को उसके अपने क्षेत्र की फ़ॉर्मैट की हुई वर्कबुक ईमेल करता है, जो Excel टूल्स से बनती है।
मुश्किल क्यों है
ऑर्डर lakehouse में हैं और बातचीत सपोर्ट टूल में। कोई दोनों को नहीं जोड़ता, इसलिए खराब सपोर्ट वाले महीने की कीमत राजस्व में कभी नहीं दिखती।
Querri के साथ
Databricks के साथ Intercom कनेक्ट करें और पूछें। Querri दोनों में ग्राहकों का मिलान करता है और बताता है कि मिलान कैसे किया। टिकट वॉल्यूम प्लेबुक दिखाती है कि बार-बार लौटने वाले संपर्क कैसे ढूँढें।
मुश्किल क्यों है
बाहरी लोगों को वर्कस्पेस एक्सेस देना एक सिक्योरिटी रिव्यू है, और क्लाइंट रिपोर्टिंग के लिए अलग BI टूल का मतलब एक और कॉन्ट्रैक्ट और डेटा मॉडल की एक और कॉपी।
Querri के साथ
पूछकर डैशबोर्ड बनाएँ, फिर हर क्लाइंट के लिए रो फ़िल्टर के साथ उसे अपने पोर्टल में एम्बेड करें। व्हाइट लेबल के साथ, उस पर हमारा नहीं, आपका ब्रांड दिखता है।
मुश्किल क्यों है
जिस असिस्टेंट को सिर्फ़ टेबल के नाम मिलते हैं, वह अंदाज़ा लगाता है कि कौन-सा कॉलम राजस्व है और किस तारीख पर फ़िल्टर करना है। जवाब पढ़ने में अच्छा लगता है, चाहे सही हो या नहीं।
Querri के साथ
Querri को Claude या ChatGPT से कनेक्ट करें, और lakehouse डेटा के सवालों के जवाब आपकी Library से, Querri में हर व्यक्ति के अपने एक्सेस के तहत आते हैं। जब किसी सवाल के दो अर्थ हो सकते हैं, तो यह बताता है कि कौन-सा अर्थ इस्तेमाल किया।
Databricks और बाकी सब
इंजीनियरिंग सबसे पहले बड़े वॉल्यूम वाला डेटा Databricks में लाती है। ERP, CRM, सपोर्ट डेस्क और बजट शीट अक्सर अपनी बारी का इंतज़ार करते हैं। Querri उन्हें आपकी lakehouse टेबल के साथ एक Library में रखता है, ताकि कई सिस्टमों वाले सवाल के लिए नया ingestion जॉब न बनाना पड़े।
Databricks इनके साथ अच्छा काम करता है
ऐसे जवाब जिनके पीछे आप खड़े रह सकें
"सितंबर में कितने ऑर्डर देर से थे?" में वे ऑर्डर गिने जा सकते हैं जो वादे की तारीख के बाद वेयरहाउस से निकले, या वे जो वादे की तारीख के बाद ग्राहक तक पहुँचे। दोनों ठीक हैं, और ऑपरेशंस और कस्टमर सर्विस दोनों अपना-अपना अर्थ पसंद करते हैं। Querri एक अर्थ के साथ जवाब देता है, उसका नाम बताता है और दूसरी गिनती भी दिखाता है, ताकि बहस देरी ठीक करने पर हो, क्वेरी पर नहीं। देखें आपके देखने से पहले जवाब की जाँच कैसे होती है।
जागें तो जानें क्या बदला
हर रात Querri सीधे गणित से आपके KPIs को उनके अपने इतिहास से परखता है और वह बदलाव ढूँढता है जिसके बारे में किसी ने नहीं पूछा। जो मिलता है वह सुबह आपके Inbox में इंतज़ार करता है, और आपकी मंज़ूरी के बिना कुछ नहीं बदलता।
कस्टम Databricks डैशबोर्ड
एक वाक्य में लेआउट माँगें, या उस रिपोर्ट का स्क्रीनशॉट दें जो फ़ाइनेंस हर सोमवार खोलता है। बदलाव भी ऐसे ही होते हैं: आम शब्दों में एक अनुरोध। चार्ट उसी Library से पढ़ते हैं जिससे चैट, और हर देखने वाले को उसकी अपनी पंक्तियों तक सीमित रखा जा सकता है।
ऐसे अनुरोध जिन्हें हाथ से चलाना बंद कर सकें
gold टेबल से हर क्षेत्र के आँकड़े, हर मैनेजर के inbox में फ़ॉर्मैट की हुई Excel फ़ाइल के रूप में।
Excel टूल्स देखेंवे ग्राहक जिनका मापा गया इस्तेमाल lakehouse में है पर ERP में कोई मेल खाता usage इनवॉइस नहीं, आपके शेड्यूल पर दोबारा चलाया गया।
रिपोर्ट्स देखेंDelta टेबल से मॉडल के फ़ोरकास्ट असली ऑर्डर के साथ, क्षेत्र के हिसाब से गलती ट्रैक करते हुए।
KPIs देखेंLakehouse से प्रोडक्ट इस्तेमाल, सपोर्ट और बिलिंग संकेतों के साथ, हर अकाउंट का एक स्कोर।
प्लेबुक पढ़ेंकौन-सी समस्याएँ ग्राहकों को बार-बार सपोर्ट तक लाती हैं, उनके ऑर्डर के मुकाबले।
प्लेबुक पढ़ेंअकाउंट बनने से उस पहले इवेंट तक का समय, जो बताता है कि ग्राहक टिकेगा।
प्लेबुक पढ़ेंक्या-क्या आता है
सिंक की गई टेबल, जो डिफ़ॉल्ट हैं, Querri के स्टोरेज में कॉपी होती हैं, और उनसे जुड़े सवालों के जवाब Databricks को छुए बिना उसी कॉपी से दिए जाते हैं। Live हो या सिंक, Querri सिर्फ़ वही पढ़ सकता है जो service principal या टोकन के यूज़र को पढ़ने की अनुमति है।
आप क्या सिंक कर सकते हैं
हर सिंक आपकी चुनी हुई टेबल को पूरा दोबारा पढ़ता है, रोज़ से लेकर हर महीने तक, इसलिए Databricks में बदली या डिलीट की गई पंक्तियाँ हमेशा आ जाती हैं। जो टेबल इतनी बार कॉपी करने के लिए बहुत बड़ी है, उसे Live पर स्विच करें और हर सवाल उसे वहीं पढ़ेगा जहाँ वह है।
पंक्तियाँ एक बार में 50,000 के हिसाब से typed Parquet फ़ाइलों के रूप में आती हैं और Iceberg-आधारित स्टोरेज में एक Querri डेटासेट बन जाती हैं। चाहें तो हर टेबल के लिए पंक्तियों की सीमा भी रख सकते हैं।
Querri सिर्फ़ स्कीमा लुकअप और SELECT क्वेरी चलाता है, और कुछ नहीं। यह कभी किसी टेबल में नहीं लिखता या कोई रिकॉर्ड नहीं बदलता। सिंक आपके SQL warehouse पर चलते हैं, इसलिए वे उसका कंप्यूट इस्तेमाल करते हैं।
service principal के साथ OAuth, या एक personal access token, स्टोरेज में एन्क्रिप्टेड और एरर मैसेज से हटाया हुआ। Connector Agent को बस इतना दिखता है कि क्रेडेंशियल मौजूद है, क्रेडेंशियल खुद कभी नहीं।
Databricks कैसे कनेक्ट करें
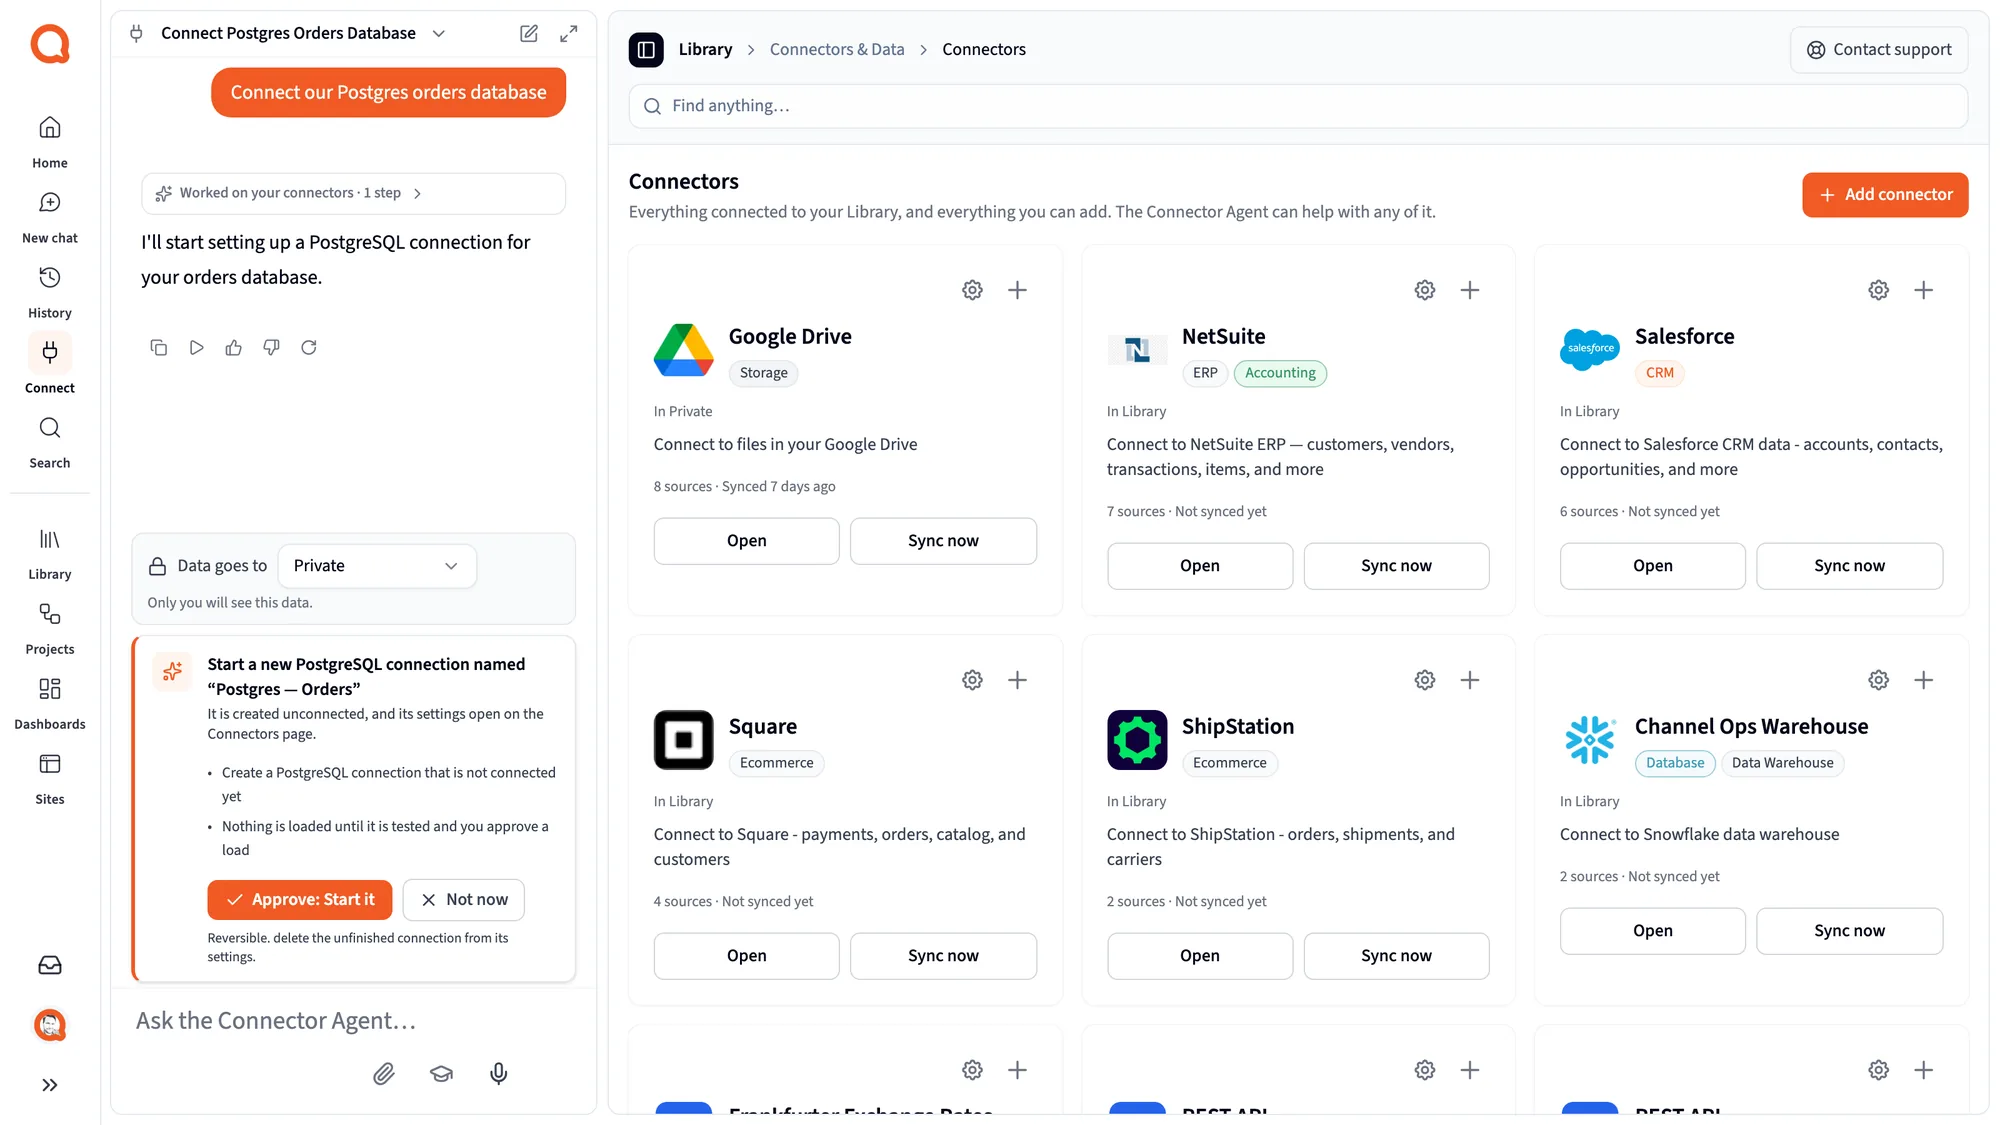
Connect में टाइप करें "हमारा Databricks वर्कस्पेस जोड़ो," या कैटलॉग में Databricks कार्ड पर क्लिक करें।
अपने SQL warehouse की Connection details से server hostname और HTTP path कॉपी करें।
किसी service principal का client ID और OAuth secret, या एक personal access token डालें, और अगर डिफ़ॉल्ट के अलावा कोई catalog और स्कीमा चाहिए तो उसका नाम दें।
सारी टेबल रखें या कुछ चुनें, और शेड्यूल चुनें। किसी टेबल को Databricks में ही रखने के लिए उसे Live पर स्विच करें। आपकी मंज़ूरी के बिना कुछ भी लोड नहीं होता।
Live टेबल तब तैयार होती हैं जब Querri उनके कॉलम पढ़ लेता है, और सिंक की गई टेबल पहला लोड आते ही। फिर चैट में lakehouse टेबल के बारे में पूछें, या उनसे डैशबोर्ड और शेड्यूल की गई रिपोर्ट्स बनाएँ।
Databricks FAQ
Connector Agent को बताएँ कि आपको Databricks चाहिए, या कैटलॉग में उसका कार्ड चुनें। अपने SQL warehouse की Connection details से server hostname और HTTP path डालें, फिर सुरक्षित फ़ॉर्म में service principal के OAuth क्रेडेंशियल या personal access token डालें। चाहें तो catalog और स्कीमा का नाम दें। फिर टेबल चुनें, तय करें कि कौन-सी Live रहें और बाकी कितनी बार रिफ़्रेश हों, और मंज़ूरी दें।
आपके चुने हुए स्कीमा की टेबल और व्यू, या तो सारी या आपकी चुनी हुई सूची, उनके कॉलम और टाइप के साथ। यह Unity Catalog या Hive metastore के साथ, SQL warehouse के ज़रिए काम करता है। Querri सिर्फ़ वही पढ़ सकता है जो टोकन का यूज़र या service principal पढ़ सकता है।
सिंक की गई टेबल रोज़, हर हफ़्ते या हर महीने पूरी दोबारा पढ़ी जाती हैं, इसलिए Databricks में बदली या डिलीट की गई पंक्तियाँ अगले रन के बाद दिखती हैं। किसी बड़ी मीटिंग से पहले एक रन हाथ से चला लें। Live टेबल हमेशा ताज़ा रहती हैं: हर सवाल Databricks को वैसा ही पढ़ता है जैसा वह चलते समय होता है।
नहीं। Querri आपकी Databricks टेबल सिर्फ़ पढ़ता है और उनमें कभी कोई रिकॉर्ड नहीं बदलता। यह स्कीमा लुकअप और SELECT क्वेरी चलाता है, और कभी कोई टेबल या पंक्ति नहीं बनाता, अपडेट या डिलीट करता; Live क्वेरी भेजने से पहले जाँची जाती हैं, इसलिए Databricks तक सिर्फ़ आपकी चुनी हुई टेबल पर एक अकेला SELECT पहुँचता है। ये क्वेरी आपके warehouse पर चलती हैं, इसलिए सिंक और Live सवाल उसका कंप्यूट इस्तेमाल करते हैं।
Querri सिर्फ़ वही पढ़ सकता है जिसकी अनुमति service principal या टोकन के यूज़र को है, इसलिए सबसे साफ़ सेटअप है एक service principal जिसके पास सिर्फ़ आपके चाहे गए स्कीमा का पढ़ने का एक्सेस हो। Querri के अंदर Unity Catalog की अनुमतियाँ हर व्यक्ति पर अलग से लागू नहीं होतीं: कौन क्या देखता है, यह Querri की शेयरिंग सेटिंग और हर व्यक्ति का रो फ़िल्टर तय करते हैं, और Live टेबल के लिए वह फ़िल्टर Databricks क्वेरी के अंदर लागू होता है।
कर सकता है, हर टेबल के लिए अलग से। Live टेबल Databricks में ही रहती है: जिस सवाल को उसकी ज़रूरत होती है, वह आपके SQL warehouse पर Databricks SQL में लिखी क्वेरी के रूप में चलता है, और सिर्फ़ नतीजा वापस आता है। ये क्वेरी warehouse का कंप्यूट इस्तेमाल करती हैं, और रुका हुआ warehouse पहले सवाल में कुछ सेकंड जोड़ देता है। सिंक की गई टेबल के जवाब Querri की कॉपी से आते हैं, इसलिए वे सवाल कभी SQL warehouse को नहीं जगाते और आखिरी सिंक का डेटा दिखाते हैं। Live टेबल Scale प्लान में उपलब्ध हैं।
उसे Live बनाएँ जब टेबल बहुत बड़ी हो, जब डेटा को lakehouse में ही रहना हो, या जब हर जवाब में Databricks की मौजूदा स्थिति दिखनी चाहिए। उसे सिंक रखें जब टेबल छोटी या मध्यम हो, जब लोग उसे खूब खंगालते हों और आप हर सवाल पर warehouse कंप्यूट का भुगतान न करना चाहें, या जब warehouse चालू होने में धीमा हो। आप किसी Live टेबल को कभी भी वापस सिंक पर स्विच कर सकते हैं; वह अगले पूरे सिंक में लोड हो जाती है।
हाँ। एक ही कनेक्शन की कई Live टेबल पर सवाल एक Databricks क्वेरी के रूप में चलते हैं। जब किसी सवाल को सिंक की गई टेबल या अपलोड की गई फ़ाइल की भी ज़रूरत होती है, तो Querri पहले Databricks में Live टेबल का सारांश बनाता है, फिर उस छोटे नतीजे को Querri में दूसरे डेटा के साथ जोड़ता है। यह अपने आप होता है, और किसी आँकड़े पर क्लिक करने से दिखता है कि वह किस टेबल से आया, एक Live बैज के साथ।
NetSuite भी कनेक्ट करें, और दोनों एक ही Library में आते हैं। Querri, lakehouse के इस्तेमाल, ऑर्डर या शिपमेंट को साझा ऑर्डर नंबर या ग्राहक के आधार पर NetSuite के इनवॉइस, sales orders और भुगतानों से मिला सकता है, और बताता है कि मिलान कैसे किया। एक बार तय करें कि कौन-सा इस्तेमाल बिल होने लायक है या ऑर्डर कब शिप माना जाए, और हर जवाब उसी का पालन करता है।
Databricks के साथ Salesforce कनेक्ट करें। Querri दोनों में अकाउंट का मिलान करता है, सबसे अच्छा दोनों में रखी किसी ID के आधार पर, ताकि आप प्रोडक्ट या ऑर्डर गतिविधि को पाइपलाइन, रिन्यूअल और खुले केस के साथ रख सकें। अगर मिलान ID के बजाय नाम पर टिका है, तो जवाब यह बताता है।
विश्लेषण को एक प्रोजेक्ट बनाएँ और उसमें साप्ताहिक शेड्यूल जोड़ें। सोमवार सुबह यह lakehouse के मौजूदा डेटा पर दोबारा चलता है और हर मैनेजर को सिर्फ़ उसके क्षेत्र वाली फ़ॉर्मैट की हुई वर्कबुक भेजता है, या हर क्लाइंट को एक। डाउनलोड करके चिपकाने का काम खत्म हो जाता है।
वह Delta टेबल कनेक्ट करें जिसमें आपका मॉडल फ़ोरकास्ट लिखता है, साथ में ऑर्डर या सेल्स टेबल, Live या सिंक। फ़ोरकास्ट की गलती को एक बार KPI के रूप में तय करें, क्षेत्र या प्रोडक्ट के हिसाब से बाँटकर। Querri उस दिन से उसका इतिहास रखता है जब से आप शुरू करते हैं, और Nightly insights उस क्षेत्र को चिह्नित करता है जिसकी गलती भटकती है।
हाँ। आम शब्दों में डैशबोर्ड माँगें, या आपकी टीम जो पहले से इस्तेमाल करती है उसके स्क्रीनशॉट से शुरू करें, और पूछकर उसे बदलें। एक ही डैशबोर्ड में lakehouse टेबल के साथ ERP, CRM या स्प्रेडशीट डेटा मिल सकता है, हर देखने वाले को उसकी पंक्तियों तक सीमित रखा जा सकता है, और उसे आपके अपने ऐप में एम्बेड किया जा सकता है।
हाँ। Claude या ChatGPT में एक बार सेटअप के बाद, lakehouse टेबल के सवाल आपकी Querri Library से जवाब लेते हैं, आपकी परिभाषाओं और नियमों का पालन करते हैं, और Querri में उस व्यक्ति को जो दिखने की अनुमति है उसी के अंदर रहते हैं, इसलिए असिस्टेंट और आपके डैशबोर्ड एक ही बात कहते हैं।
हाँ। service principal के साथ OAuth (machine-to-machine) सुझाया गया सेटअप है: उसका client ID और secret डालें, और उसके कम समय तक चलने वाले टोकन को rotate करने की ज़रूरत नहीं पड़ती। personal access token भी काम करता है। दोनों ही तरीकों में, कनेक्शन किसी एक कर्मचारी के साइन इन करने पर निर्भर नहीं करता।
एक कनेक्शन एक catalog और एक स्कीमा को कवर करता है। कस्टम SQL क्वेरी सपोर्टेड नहीं हैं, इसलिए उनकी जगह टेबल या व्यू चुनें। वापस लिखना संभव नहीं है। डिफ़ॉल्ट रूप से, Live नतीजे 100,000 पंक्तियों पर रुकते हैं और चैट में सवाल 2 मिनट बाद टाइम आउट हो जाते हैं। कई catalog या स्कीमा का मतलब बस कई कनेक्शन है।
अभी नहीं। Querri आपके workspace से पोर्ट 443 पर HTTPS से कनेक्ट होता है, इसलिए workspace इंटरनेट से पहुँच में होना चाहिए। अगर warehouse बंद है या host गलत है, तो कनेक्शन अटकने के बजाय कुछ मिनटों में हार मान लेता है।
हाँ। बड़ी टेबल को Live बनाएँ और वह Databricks में ही रहती है, जहाँ हर सवाल चलता है और सिर्फ़ नतीजा वापस आता है। सिंक की गई टेबल की पंक्तियाँ एक बड़े पुल के बजाय 50,000 पंक्तियों के टुकड़ों में typed Parquet फ़ाइलों में स्ट्रीम होती हैं, और पंक्तियाँ आते ही प्रगति दिखती है। आप हर टेबल के लिए पंक्तियों की सीमा भी रख सकते हैं।
नहीं। टेबल कनेक्ट होने के बाद, एक्सेस वाला कोई भी व्यक्ति आम भाषा में पूछता है। Querri हर जवाब के पीछे के चरण दिखाता है, ताकि डेटा टीम का कोई व्यक्ति लॉजिक जाँच सके, और अच्छा जवाब एक प्रोजेक्ट के रूप में सेव किया जा सकता है जो ताज़ा डेटा पर दोबारा चलता है।
Querri, SOC 2 Type II, HIPAA और ISO 27001:2022 प्रमाणित है, और आपका डेटा कभी किसी मॉडल को ट्रेन करने में इस्तेमाल नहीं होता। आपके क्रेडेंशियल स्टोरेज में एन्क्रिप्टेड रहते हैं, एरर मैसेज से हटा दिए जाते हैं और Connector Agent को कभी नहीं दिखाए जाते, और कनेक्शन सिर्फ़ HTTPS इस्तेमाल करता है।
और जानें
एक hostname, एक HTTP path और एक service principal या टोकन से कनेक्ट करें, फिर lakehouse को Live क्वेरी करें या एक कॉपी सिंक करें। Querri सिर्फ़ पढ़ता है और उसमें कभी नहीं लिखता।