Zum Inhalt springen

Databricks + Querri

Antworten aus Databricks,ohne Notebook und ohne eine Zeile SQL.

Im Lakehouse steht, was Betrieb, Finanzen und Vertrieb wissen wollen. Querri kopiert die Tabellen, die Sie auswählen, mit dem Rest Ihres Unternehmens in eine Bibliothek, sodass jeder in einfacher Sprache danach fragen kann und Antworten mit den Definitionen Ihres Teams erhält.

Querri liest aus Databricks nur, mit einem Token, das verschlüsselt gespeichert und für den Agenten unsichtbar bleibt. Zertifiziert nach SOC 2 Type II, HIPAA und ISO 27001:2022.

Warum Databricks-Reporting ins Stocken gerät

Das Lakehouse steht. Die Fachbereiche kommen trotzdem nicht hinein.

Data Engineers wechseln zu Databricks, weil es die schwere Pipeline-Arbeit erledigt. Die Reibung zeigt sich später, wenn jemand außerhalb des Datenteams eine Frage zu den Inhalten hat.

01

Notebooks und SQL sind die Eingangstür

Ein Regionalleiter öffnet kein Notebook und keinen SQL-Editor. Jede Frage wird zur Anfrage an das Datenteam, und die Warteschlange wächst schneller als das Team.

02

Definitionen verstecken sich im Code

Nettoumsatz ist in einem Notebook eine CASE-Anweisung, in einem anderen ein dbt-Modell und in einer Dashboard-Abfrage ein leicht anderer Filter. Außerhalb des Engineerings kann niemand sehen, welche Variante stimmt.

03

Ein paar Fragen halten die Rechenleistung am Laufen

Classic- und Pro-SQL-Warehouses warten standardmäßig 45 Minuten Leerlauf, bevor sie stoppen, Serverless-Warehouses 10. Ein stetiges Rinnsal von Ad-hoc-Fragen über den Tag hält ein Warehouse in der Abrechnung.

04

Große Ergebnisse enden als export.csv

Eine Notebook-Tabelle zeigt höchstens 10.000 Zeilen oder 2 MB, je nachdem, was kleiner ist. Alles Größere wird heruntergeladen, in Excel eingefügt und per E-Mail verschickt, und die Kopien laufen auseinander.

05

Governance endet beim Download

Unity Catalog entscheidet in Databricks, wer welche Tabelle liest. Sobald eine CSV-Datei den Workspace verlässt, reisen diese Berechtigungen nicht mit, und jeder Empfänger sieht jede Zeile.

Was Sie endlich beantworten können

Acht Databricks-Fragen, die an der Warteschlange des Datenteams vorbeigehen

Jede davon ist eine Anfrage, die jeden Monat bei einem Lakehouse-Team landet, dazu der Grund, warum sie heute so lange dauert, und wie Querri sie löst.

Wie bekommen Betrieb und Finanzen Antworten aus Databricks ohne Notebook?

Warum es schwierig ist

Die Tabellen sind sauber und dokumentiert, aber lesen lassen sie sich nur über ein Notebook, den SQL-Editor oder ein Dashboard, das jemand anderes gebaut hat.

Mit Querri

Querri synchronisiert die Gold-Tabellen, die Sie auswählen, und die Leute fragen im Chat in ihren eigenen Worten. Jede Antwort listet ihre Schritte auf, und eine nützliche lässt sich als Projekt speichern, das jeder erneut ausführen kann.

Wurde jedem Kunden die Nutzung in Rechnung gestellt, die wir letzten Monat gemessen haben?

Warum es schwierig ist

Gemessene Nutzung landet im Lakehouse, Rechnungen werden im ERP erstellt. Beides zu vergleichen heißt, eine Pipeline zu bauen, die es noch nicht gibt, oder eine Tabelle zum Monatsende.

Mit Querri

Verbinden Sie NetSuite neben Databricks, und Querri stellt die gemessene Nutzung jedes Kunden seinen Nutzungsrechnungen gegenüber. Legen Sie einmal in Fakten und Regeln fest, welche Ereignisse abrechenbar sind, und die Liste der nicht abgerechneten Kunden folgt dieser Regel.

Kann der Nettoumsatz aus unseren Gold-Tabellen Menschen erreichen, die sich nie bei Databricks anmelden?

Warum es schwierig ist

Die vereinbarte Definition steckt im Transformationscode. Eine Vertriebsleiterin, die die Zahl in einer Tabelle nachbaut, kommt nah heran, und genau so landen zwei Zahlen im selben Meeting.

Mit Querri

Schreiben Sie die Definition in einfachen Worten in die Bibliothek und verfolgen Sie sie als KPI. Chat, Dashboards und geplante Berichte lesen alle dieselbe Bedeutung, und der KPI bewahrt seine Historie ab dem ersten Tag auf.

Hält die Bedarfsprognose unserer Data Scientists den Ist-Werten stand?

Warum es schwierig ist

Das Modell schreibt seine Prognose in eine Delta-Tabelle und macht weiter. Sie Woche für Woche und Region für Region mit echten Aufträgen abzugleichen, ist niemandes Aufgabe.

Mit Querri

Synchronisieren Sie die Prognosetabelle und die Auftragstabelle und verfolgen Sie den Prognosefehler als KPI. Nächtliche Insights vergleichen jede Region jede Nacht mit ihrer eigenen Historie und legen eine abdriftende Region in Ihren Posteingang.

Wie exportiere ich Databricks-Daten jeden Montag automatisch nach Excel?

Warum es schwierig ist

Jemand führt die Abfrage aus, lädt das Ergebnis herunter, formatiert die Tabelle und teilt sie von Hand nach Regionen auf. In der Urlaubswoche bekommt sie niemand.

Mit Querri

Speichern Sie die Aufschlüsselung nach Regionen als Projekt mit einem Lauf montags um 7 Uhr. Berichte & Automatisierung führt es auf der neuesten Synchronisierung erneut aus und sendet jedem Manager eine formatierte Arbeitsmappe nur mit seiner Region, erstellt mit den Excel-Tools.

Bestellen Kunden, die sich oft an den Support wenden, danach weniger?

Warum es schwierig ist

Aufträge liegen im Lakehouse, Gespräche im Support-Tool. Niemand verknüpft beides, und so tauchen die Kosten eines schlechten Support-Monats nie im Umsatz auf.

Mit Querri

Verbinden Sie Intercom neben Databricks und fragen Sie. Querri ordnet Kunden über beide Systeme hinweg zu und sagt, wie es sie zugeordnet hat. Das Playbook zum Ticketvolumen zeigt, wie Sie die Kontakte finden, die immer wiederkommen.

Können wir Kunden ein Dashboard aus Lakehouse-Daten geben, ohne Databricks-Zugang?

Warum es schwierig ist

Workspace-Zugriff für Externe bedeutet eine Sicherheitsprüfung, und ein eigenes BI-Tool für das Kunden-Reporting ist ein weiterer Vertrag und eine weitere Kopie des Datenmodells.

Mit Querri

Erstellen Sie das Dashboard per Frage und betten Sie es dann mit einem Zeilenfilter pro Kunde in Ihr eigenes Portal ein. Mit White-Label trägt es Ihre Marke statt unserer.

Kann ich Claude oder ChatGPT nach unseren Databricks-Tabellen fragen?

Warum es schwierig ist

Ein Assistent, der nur rohe Tabellennamen bekommt, rät, welche Spalte Umsatz bedeutet und nach welchem Datum gefiltert wird. Die Antwort liest sich gut, ob sie stimmt oder nicht.

Mit Querri

Verbinden Sie Querri mit Claude oder ChatGPT, und Fragen zu Lakehouse-Daten werden aus Ihrer Bibliothek beantwortet, mit dem Zugriff, den die jeweilige Person in Querri hat. Lässt sich eine Frage auf zwei Arten lesen, benennt es die verwendete Lesart.

Databricks und der Rest

Noch liegt nicht jedes System im Lakehouse

Das Engineering leitet zuerst die Daten mit hohem Volumen nach Databricks. ERP, CRM, Support-Desk und Budgettabelle warten oft, bis sie an der Reihe sind. Querri legt sie in einer Bibliothek neben Ihre Lakehouse-Tabellen, sodass eine systemübergreifende Frage keinen neuen Ingestion-Job braucht.

Databricks passt gut zu

Antworten, für die Sie einstehen können

„Verspätet“ hat zwei ehrliche Bedeutungen, und die Antwort nennt die, die sie gezählt hat

„Wie viele Aufträge waren im September verspätet?“ kann Aufträge zählen, die das Lager nach dem zugesagten Datum verlassen haben, oder solche, die nach diesem Datum beim Kunden ankamen. Beides ist vertretbar, und Betrieb und Kundenservice bevorzugen jeweils eine Lesart. Querri antwortet mit einer Lesart, benennt sie und zeigt die andere Zahl, damit über die Behebung der Verzögerungen diskutiert wird und nicht über die Abfrage. Siehe wie eine Antwort geprüft wird, bevor Sie sie sehen.

Morgens sehen, was sich geändert hat

Über Nacht liest Querri die Lakehouse-Zahlen für Sie

Jede Nacht misst Querri Ihre KPIs mit einfacher Arithmetik an ihrer eigenen Vergangenheit und sucht nach der Verschiebung, nach der niemand gefragt hat. Was es findet, wartet morgens in Ihrem Posteingang, und nichts ändert sich, bevor Sie es bestätigen.

Eigene Databricks-Dashboards

Databricks-Dashboards, für die niemand eine Abfrage schreiben muss

Beschreiben Sie das Layout in einem Satz, oder geben Sie einen Screenshot des Berichts weiter, den die Finanzabteilung jeden Montag aufruft. Änderungen funktionieren genauso: eine Bitte in einfachen Worten. Die Diagramme lesen aus derselben Bibliothek wie der Chat, und jeder Betrachter kann auf seine eigenen Zeilen beschränkt werden.

  • In Worten angefragt, in Worten angepasst
  • Lakehouse-Tabellen neben ERP-, CRM- und Tabellendaten
  • Zeilenfilter pro Person, einmal in Querri festgelegt
Eine getippte Bitte hat das ganze Dashboard umgestaltet, und ein Klick würde es zurücksetzen.

Anfragen, die Sie nicht mehr von Hand erledigen müssen

Sechs Databricks-Berichte, die sich selbst neu erstellen

Was übertragen wird

Das Schema, auf das Sie zeigen, kopiert nach Ihrem Zeitplan

Die Tabellen und Views, die Sie auswählen, werden in den Speicher von Querri kopiert, und jede Antwort stammt aus dieser Kopie statt aus einer Live-Abfrage gegen Databricks. Es kann nur lesen, was der Benutzer oder Service Principal des Tokens lesen darf.

Was Sie synchronisieren können

  • Tabellen
  • Views
  • Jede Tabelle im Schema
  • Eine ausgewählte Liste von Tabellen
  • Unity Catalog oder Hive Metastore
  • SQL-Warehouses oder All-Purpose-Cluster
  • Eine Verbindung umfasst einen einzelnen Katalog und ein Schema; INFORMATION_SCHEMA wird ausgelassen.

Vollständig oder inkrementell

Standardmäßig eine vollständige Aktualisierung. Wählen Sie eine Cursor-Spalte (Querri schlägt updated_at vor), und inkrementelle Läufe holen nur Zeilen nach dem zuletzt gesehenen Wert, bis zu stündlich. Tabellen mit Primärschlüssel werden per Upsert aktualisiert, Überschneidungen werden also nicht doppelt gezählt.

In Blöcken gestreamt

Zeilen kommen in Blöcken von 50.000 als typisierte Parquet-Dateien an und werden zu einem Querri-Datensatz in Iceberg-basiertem Speicher. Eine Zeilenobergrenze pro Tabelle gibt es, wenn Sie eine möchten.

Nur lesend

Querri führt Schema-Abfragen und SELECT-Abfragen aus, sonst nichts. Es schreibt nie in eine Tabelle und ändert nie einen Datensatz. Synchronisierungen laufen auf Ihrem Warehouse oder Cluster und nutzen dessen Rechenleistung.

Token verschlüsselt gespeichert

Ein Personal Access Token oder das Token eines Service Principal, im Ruhezustand verschlüsselt und aus Fehlermeldungen entfernt. Der Connector Agent sieht, dass ein Token existiert, aber nie das Token selbst.

So verbinden Sie Databricks

Drei Werte aus Ihrem Workspace, den Rest übernimmt der Agent

  1. 1

    Den Connector Agent fragen

    Tippen Sie in Connect „Füge unseren Databricks-Workspace hinzu“, oder klicken Sie im Katalog auf die Databricks-Karte.

  2. 2

    Die Verbindungsdetails kopieren

    Kopieren Sie aus den Connection details Ihres SQL-Warehouse den Server-Hostnamen und den HTTP-Pfad. Ein All-Purpose-Cluster funktioniert ebenfalls.

  3. 3

    Ein Token im sicheren Formular hinzufügen

    Fügen Sie ein Personal Access Token oder das Token eines Service Principal ein, und nennen Sie einen Katalog und ein Schema, wenn Sie andere als die Standardwerte möchten.

  4. 4

    Tabellen auswählen und bestätigen

    Übernehmen Sie alle Tabellen oder wählen Sie einige aus, legen Sie eine Cursor-Spalte für inkrementelle Synchronisierungen fest und wählen Sie einen Zeitplan. Nichts wird geladen, bevor Sie bestätigen.

  5. 5

    Die erste Frage stellen

    Sobald die erste Ladung angekommen ist, fragen Sie im Chat nach den Lakehouse-Tabellen oder erstellen daraus Dashboards und geplante Berichte.

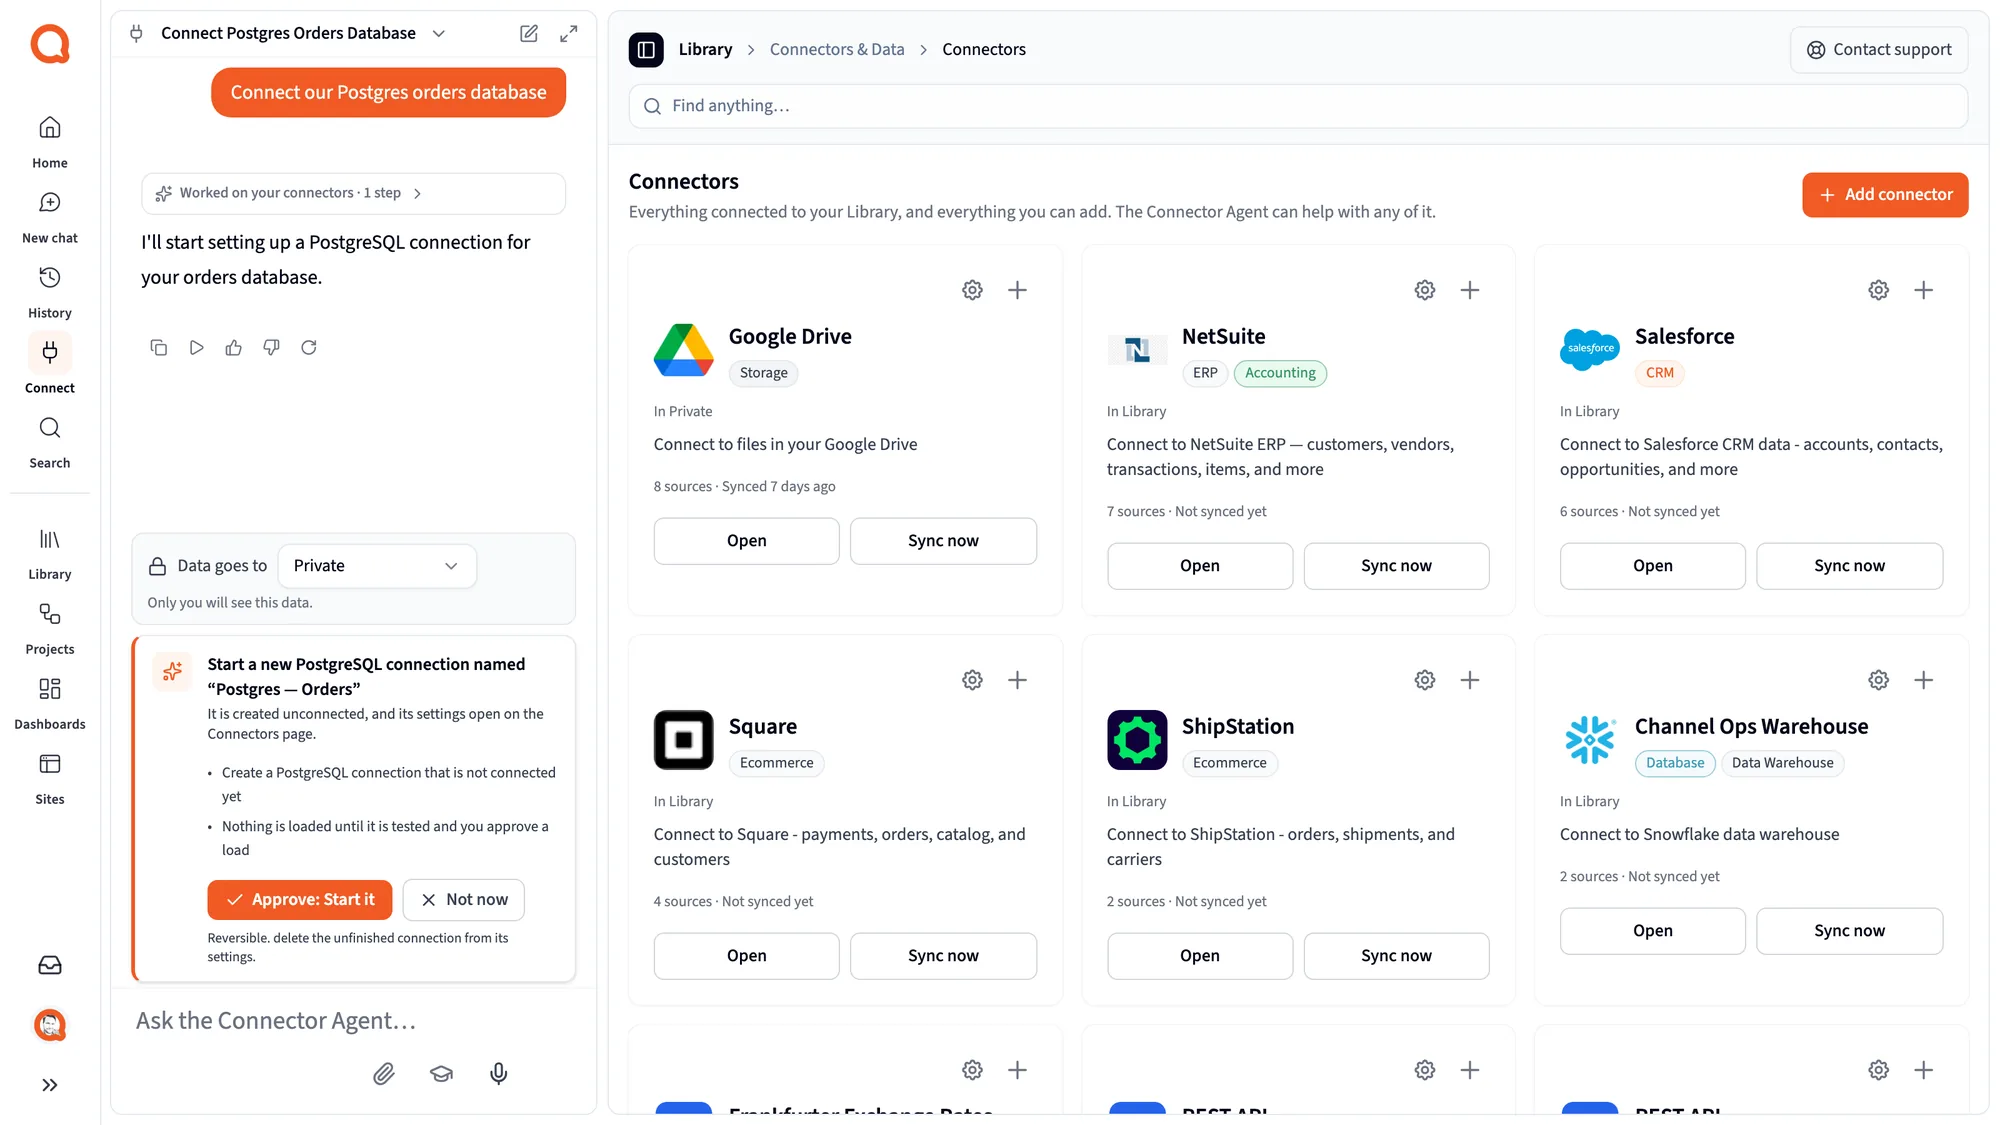
Connector-Karten für Google Drive, NetSuite, Salesforce, Square, ShipStation und Snowflake auf der Connect-Seite von Querri, während der Connector Agent eine neue Verbindung zur Bestätigung zurückhält
Der Agent hält jede neue Verbindung und jede erste Ladung zurück, bis Sie auf Approve klicken.

Databricks-FAQ

Fragen zu Databricks und Querri

Wie verbinde ich Databricks mit Querri?

Sagen Sie dem Connector Agent, dass Sie Databricks möchten, oder wählen Sie die Karte im Katalog. Geben Sie den Server-Hostnamen und den HTTP-Pfad aus den Connection details Ihres SQL-Warehouse ein und fügen Sie dann ein Access Token in das sichere Formular ein. Optional nennen Sie einen Katalog und ein Schema. Wählen Sie danach die Tabellen, legen Sie fest, wie oft sie aktualisiert werden, und bestätigen Sie die erste Ladung.

Welche Databricks-Daten synchronisiert Querri?

Die Tabellen und Views im gewählten Schema, entweder alle oder eine Liste, die Sie auswählen, mit ihren Spalten und Typen. Es funktioniert mit Unity Catalog oder dem Hive Metastore, über ein SQL-Warehouse oder einen All-Purpose-Cluster. Querri kann nur lesen, was der Benutzer oder Service Principal des Tokens lesen kann.

Wie oft werden Databricks-Daten synchronisiert?

Ein vollständiges Neueinlesen des Schemas lässt sich täglich, wöchentlich oder monatlich einstellen. Inkrementelle Synchronisierungen, gesteuert über eine Cursor-Spalte wie updated_at, laufen stündlich, täglich oder wöchentlich und holen nur Zeilen nach dem letzten Wert. Vor einem wichtigen Meeting starten Sie eine von Hand. In Databricks gelöschte Zeilen bleiben bis zur nächsten vollständigen Aktualisierung in Querri.

Schreibt Querri in Databricks oder ändert es meine Daten?

Nein. Querri liest Ihre Databricks-Tabellen nur und ändert nie einen Datensatz darin. Es führt Schema-Abfragen und SELECT-Abfragen aus und legt nie eine Tabelle oder Zeile an, aktualisiert oder löscht sie. Diese Abfragen laufen auf Ihrem Warehouse oder Cluster, eine Synchronisierung nutzt also dessen Rechenleistung.

Wie werden Unity-Catalog-Berechtigungen in Querri übernommen?

Querri kann nur synchronisieren, wofür der Benutzer oder Service Principal des Tokens berechtigt ist. Am saubersten ist daher ein Service Principal mit Lesezugriff nur auf das gewünschte Schema. Nach der Synchronisierung gelten die Unity-Catalog-Berechtigungen nicht mehr pro Person: Querris Freigabeeinstellungen und ein Zeilenfilter pro Person bestimmen, was jemand sieht.

Fragt Querri Databricks jedes Mal live ab, wenn jemand eine Frage stellt?

Nein. Fragen werden aus einer Kopie der ausgewählten Tabellen beantwortet, die Querri nach Ihrem Zeitplan aktualisiert. Eine Frage weckt also nie ein SQL-Warehouse auf und hält es nicht vom Stoppen ab. Nur Synchronisierungen fragen Databricks ab. Eine Antwort spiegelt die Daten zum Stand der letzten Synchronisierung wider.

Wie kombiniere ich Daten aus Databricks und NetSuite?

Verbinden Sie zusätzlich NetSuite, und beides landet in derselben Bibliothek. Querri kann Nutzung, Aufträge oder Sendungen aus dem Lakehouse über eine gemeinsame Auftragsnummer oder den Kunden NetSuite-Rechnungen, Kundenaufträgen und Zahlungen zuordnen und sagt Ihnen, wie es zugeordnet hat. Legen Sie einmal fest, welche Nutzung abrechenbar ist oder wann ein Auftrag als versandt gilt, und jede Antwort folgt dieser Regel.

Wie kombiniere ich Daten aus Databricks und Salesforce?

Verbinden Sie Salesforce neben Databricks. Querri ordnet Accounts zwischen beiden zu, am besten über eine ID, die in beiden gespeichert ist, sodass Sie Produkt- oder Auftragsaktivität neben Pipeline, Verlängerungen und offene Cases stellen können. Beruht eine Zuordnung auf einem Namen statt auf einer ID, weist die Antwort darauf hin.

Wie bekomme ich einen wöchentlichen Excel-Bericht aus Databricks, ohne von Hand zu exportieren?

Machen Sie die Analyse zu einem Projekt und hängen Sie einen wöchentlichen Zeitplan an. Am Montagmorgen läuft es auf der neuesten Kopie Ihrer Lakehouse-Tabellen erneut und sendet jedem Manager eine formatierte Arbeitsmappe nur mit seiner Region, oder eine pro Kunde. Der Schritt Herunterladen und Einfügen entfällt.

Wie erstelle ich einen Bericht Prognose gegen Ist aus Databricks?

Synchronisieren Sie die Delta-Tabelle, in die Ihr Modell seine Prognose schreibt, sowie die Auftrags- oder Verkaufstabelle. Definieren Sie den Prognosefehler einmal als KPI, aufgeschlüsselt nach Region oder Produkt. Querri bewahrt seine Historie ab dem ersten Tag auf, und Nächtliche Insights markieren eine Region, deren Fehler abdriftet.

Kann ich eigene Databricks-Dashboards ohne BI-Tool erstellen?

Ja. Beschreiben Sie das Dashboard in einfachen Worten, oder starten Sie mit einem Screenshot eines Dashboards, das Ihr Team bereits nutzt, und ändern Sie es per Frage. Ein einzelnes Dashboard kann Lakehouse-Tabellen mit ERP-, CRM- oder Tabellendaten kombinieren, jeden Betrachter auf seine eigenen Zeilen beschränken und in Ihre eigene App eingebettet werden.

Kann ich ChatGPT oder Claude nach meinen Databricks-Daten fragen?

Ja. Nach einer einmaligen Einrichtung in Claude oder ChatGPT greifen Fragen zu Lakehouse-Tabellen auf Ihre Querri-Bibliothek zurück, folgen Ihren Definitionen und Regeln und bleiben innerhalb dessen, was diese Person in Querri sehen darf. So stimmen der Assistent und Ihre Dashboards überein.

Kann ich mich bei Databricks per OAuth statt mit einem Token anmelden?

Nein. Der Connector braucht ein Access Token, entweder ein Personal Access Token oder eines, das zu einem Service Principal gehört. OAuth würde auf eine Browser-Anmeldung zurückfallen, die bei geplanten Synchronisierungen auf einem Server nicht abgeschlossen werden kann. Mit dem Token eines Service Principal hängt die Verbindung von keinem einzelnen Mitarbeiter ab.

Welche Grenzen hat der Databricks-Connector?

Eine Verbindung umfasst einen einzelnen Katalog und ein Schema. Eigene SQL-Abfragen werden nicht unterstützt, wählen Sie stattdessen Tabellen oder Views. Es gibt kein OAuth und kein Zurückschreiben, und inkrementelle Synchronisierungen übersehen Löschungen bis zur nächsten vollständigen Aktualisierung. Mehrere Kataloge oder Schemas bedeuten einfach mehrere Verbindungen.

Kann Querri einen Databricks-Workspace in einem privaten Netzwerk erreichen?

Ja, über den optionalen VPN-Tunnel in den erweiterten Einstellungen der Verbindung. Ohne ihn lehnt Querri private Adressen ab und verbindet sich nur per HTTPS über Port 443. Ist ein Warehouse gestoppt oder der Host falsch, gibt die Verbindung innerhalb weniger Minuten auf, statt hängen zu bleiben.

Kommt Querri mit großen Databricks-Tabellen zurecht?

Ja. Zeilen werden in Blöcken von 50.000 in typisierte Parquet-Dateien gestreamt, statt in einem einzigen riesigen Abruf, und der Fortschritt wird angezeigt, während Zeilen ankommen. Bei Tabellen, die täglich wachsen, sorgt eine Cursor-Spalte dafür, dass jeder Lauf nur Zeilen nach dem letzten liest. Sie können außerdem die Zeilen pro Tabelle begrenzen.

Muss ich SQL oder Python können, um Databricks-Daten in Querri zu nutzen?

Nein. Sobald die Tabellen synchronisiert sind, fragt jeder mit Zugriff in einfacher Sprache. Querri zeigt die Schritte hinter jeder Antwort, sodass jemand aus dem Datenteam die Logik prüfen kann, und eine gute Antwort lässt sich als Projekt speichern, das auf frischen Daten erneut läuft.

Sind meine Databricks-Daten in Querri sicher?

Querri ist nach SOC 2 Type II, HIPAA und ISO 27001:2022 zertifiziert, und Ihre Daten werden nie zum Trainieren eines Modells verwendet. Ihr Access Token wird im Ruhezustand verschlüsselt, aus Fehlermeldungen entfernt und dem Connector Agent nie angezeigt, und die Verbindung nutzt ausschließlich HTTPS.
Öffnen Sie das Lakehouse für die Menschen, die die Fragen stellen.

Verbinden Sie es mit einem Hostnamen, einem HTTP-Pfad und einem Token. Querri liest das Lakehouse nur und schreibt nie hinein.