¿Cómo obtienen operaciones y finanzas respuestas de Databricks sin un notebook?
Por qué es difícil
Las tablas están limpias y documentadas, pero las únicas formas de leerlas son un notebook, el editor de SQL o un dashboard que escribió otra persona.
 Databricks + Querri
El lakehouse guarda lo que operaciones, finanzas y ventas quieren saber. Querri copia las tablas que eliges a una sola Biblioteca junto al resto de tu negocio, para que cualquiera pueda preguntar por ellas en lenguaje natural y obtener las definiciones de tu equipo.
Querri solo lee de Databricks, con un token que se guarda cifrado y fuera de la vista del agente. Certificado SOC 2 Type II, HIPAA e ISO 27001:2022.
Por qué los informes de Databricks se atascan
Los ingenieros de datos se pasan a Databricks porque resuelve el trabajo difícil de los pipelines. La fricción aparece después, cuando alguien de fuera del equipo de datos tiene una pregunta sobre lo que hay dentro.
Un gerente regional no va a abrir un notebook ni el editor de SQL. Cada pregunta se convierte en una petición al equipo de datos, y la cola crece más rápido que el equipo.
Los ingresos netos son un CASE en un notebook, un modelo de dbt en otro y un filtro un poco distinto en la consulta de un dashboard. Nadie fuera de ingeniería puede ver cuál es el correcto.
Por defecto, los SQL warehouses classic y pro esperan 45 minutos de inactividad antes de detenerse, y los serverless, 10. Un goteo de preguntas puntuales a lo largo del día mantiene un warehouse facturando.
Una tabla de notebook muestra como máximo 10,000 filas o 2 MB, lo que sea menor. Todo lo que pase de ahí se descarga, se pega en Excel y se envía por correo, y las copias se van desviando.
Unity Catalog decide quién lee qué tabla dentro de Databricks. Cuando un CSV sale del espacio de trabajo, esos permisos no viajan con él, y cada destinatario ve todas las filas.
Lo que por fin puedes responder
Cada una es una petición que llega a un equipo de lakehouse todos los meses, con el motivo por el que hoy tarda tanto y lo que Querri hace con ella.
Por qué es difícil
Las tablas están limpias y documentadas, pero las únicas formas de leerlas son un notebook, el editor de SQL o un dashboard que escribió otra persona.
Por qué es difícil
El uso medido llega al lakehouse mientras que las facturas se emiten en el ERP. Compararlos requiere un pipeline que nadie ha construido todavía, o una hoja de cálculo de cierre de mes.
Con Querri
Conecta NetSuite junto a Databricks y Querri pone el uso medido de cada cliente al lado de sus facturas de uso. Indica una sola vez en Hechos y reglas qué eventos son facturables, y la lista de clientes sin facturar lo respeta.
Por qué es difícil
La definición acordada está en el código de transformación. Un líder de ventas que rehace la cifra en una hoja de cálculo se acerca, y acercarse es justo como acaban dos cifras en una misma reunión.
Con Querri
Escribe la definición con palabras sencillas en la Biblioteca y síguela como un KPI. El chat, los dashboards y los informes programados leen el mismo significado, y el KPI guarda su historial desde el día en que empiezas.
Por qué es difícil
El modelo escribe su forecast en una tabla Delta y sigue adelante. Contrastarlo con los pedidos reales, semana a semana y región por región, no es trabajo de nadie.
Con Querri
Sincroniza la tabla de forecast y la tabla de pedidos, y sigue el error del forecast como un KPI. El Análisis nocturno compara cada noche cada región con su propio historial y deja en tu Bandeja de entrada la que se está desviando.
Por qué es difícil
Alguien ejecuta la consulta, descarga el resultado, da formato a la hoja y la divide por región a mano. La semana que esa persona está de vacaciones, nadie la recibe.
Con Querri
Guarda el desglose regional como un proyecto con una ejecución los lunes a las 7 a. m. Informes y automatización lo vuelve a ejecutar sobre la última sincronización y le envía por correo a cada gerente un libro con formato de su propia región, creado con las herramientas de Excel.
Por qué es difícil
Los pedidos están en el lakehouse y las conversaciones en la herramienta de soporte. Nadie une las dos, así que el costo de un mal mes de soporte nunca aparece en los ingresos.
Con Querri
Conecta Intercom junto a Databricks y pregunta. Querri relaciona los clientes entre ambos y te dice cómo los relacionó. El playbook de volumen de tickets muestra cómo encontrar los contactos que se repiten.
Por qué es difícil
Dar acceso al espacio de trabajo a personas externas implica una revisión de seguridad, y una herramienta de BI aparte para los informes a clientes es otro contrato y otra copia del modelo de datos.
Con Querri
Crea el dashboard preguntando y luego intégralo en tu propio portal con un filtro de filas por cliente. Con la marca blanca, lleva tu marca y no la nuestra.
Por qué es difícil
Un asistente que solo recibe nombres de tablas adivina qué columna significa ingresos y por qué fecha filtrar. La respuesta suena bien, sea correcta o no.
Con Querri
Conecta Querri a Claude o ChatGPT, y las preguntas sobre los datos del lakehouse se responden desde tu Biblioteca, con el acceso de cada persona en Querri. Cuando una pregunta admite dos lecturas, dice cuál usó.
Databricks y todo lo demás
Ingeniería lleva primero a Databricks los datos de gran volumen. El ERP, el CRM, la herramienta de soporte y la hoja del presupuesto suelen esperar su turno. Querri los pone en una sola Biblioteca junto a tus tablas del lakehouse, así que una pregunta entre sistemas no necesita un nuevo proceso de ingesta.
Databricks combina bien con
Respuestas que puedes defender
"¿Cuántos pedidos llegaron con retraso en septiembre?" puede contar los pedidos que salieron del almacén después de la fecha prometida o los que llegaron al cliente después de esa fecha. Las dos lecturas son válidas, y operaciones y atención al cliente prefieren cada una la suya. Querri responde con una lectura, la nombra y muestra el otro recuento, para que la discusión sea sobre cómo resolver los retrasos y no sobre la consulta. Consulta cómo se comprueba una respuesta antes de que la veas.
Despierta sabiendo qué cambió
Cada noche Querri compara tus KPIs con su propio pasado con aritmética simple y busca el cambio por el que nadie preguntó. Lo que encuentra te espera en tu Bandeja de entrada por la mañana, y nada cambia hasta que lo apruebas.
Dashboards de Databricks a medida
Pide el diseño en una frase, o entrega una captura del informe que finanzas abre cada lunes. Los cambios funcionan igual: una petición con palabras sencillas. Los gráficos leen de la misma Biblioteca que el chat, y cada persona puede quedar limitada a sus propias filas.
Peticiones que puedes dejar de hacer a mano
Las cifras de cada región desde las tablas gold, como un archivo de Excel con formato en la bandeja de entrada de cada gerente.
Ver herramientas de ExcelClientes con uso medido en el lakehouse y sin una factura de uso correspondiente en el ERP, vuelto a ejecutar según tu programación.
Ver informesLos forecasts del modelo desde una tabla Delta junto a los pedidos reales, con el error seguido por región.
Ver KPIsEl uso del producto desde el lakehouse con señales de soporte y facturación, una puntuación por cuenta.
Leer el playbookQué problemas hacen que los clientes vuelvan a soporte, comparado con lo que piden.
Leer el playbookEl tiempo desde la creación de la cuenta hasta el primer evento que predice que un cliente se queda.
Leer el playbookQué se sincroniza
Las tablas y vistas que seleccionas se copian al almacenamiento de Querri, y cada respuesta sale de esa copia y no de una consulta en vivo a Databricks. Solo puede leer lo que el usuario o la entidad de servicio del token tiene permiso para leer.
Qué puedes sincronizar
Actualización completa por defecto. Elige una columna cursor (Querri sugiere updated_at) y las ejecuciones incrementales traen solo las filas posteriores al último valor visto, hasta cada hora. Las tablas con clave primaria se actualizan con upsert, así que el solapamiento no cuenta dos veces.
Las filas llegan de 50,000 en 50,000 como archivos Parquet tipados y se convierten en un conjunto de datos de Querri en un almacenamiento basado en Iceberg. Si lo quieres, hay un límite de filas por tabla.
Querri ejecuta consultas de esquema y consultas SELECT, nada más. Nunca escribe en una tabla ni modifica un registro. Las sincronizaciones se ejecutan en tu warehouse o clúster, así que usan su cómputo.
Un token de acceso personal o el token de una entidad de servicio, cifrado en reposo y eliminado de los mensajes de error. El Connector Agent sabe que existe un token, pero nunca ve el token.
Cómo conectar Databricks
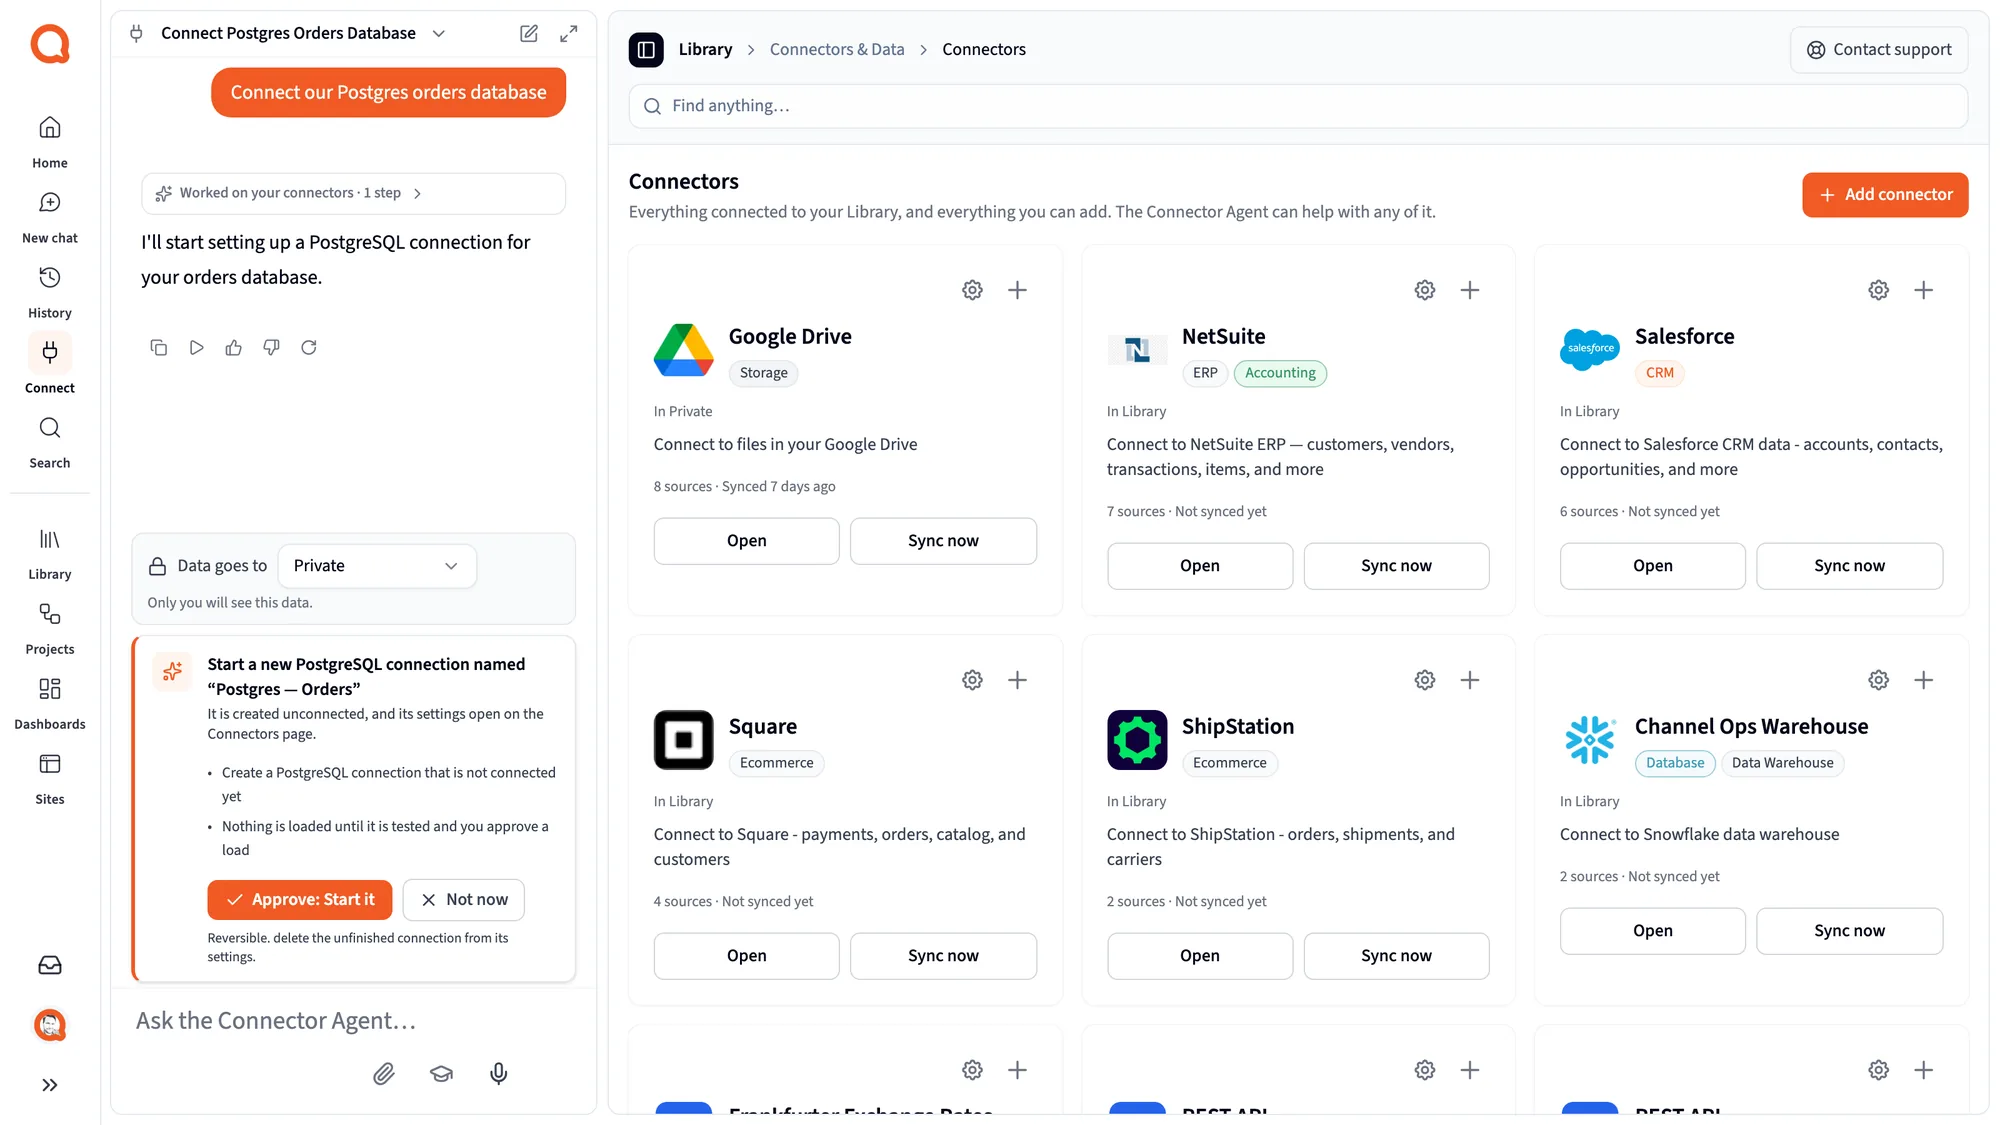
En Connect, escribe "agrega nuestro espacio de trabajo de Databricks", o haz clic en la tarjeta de Databricks en el catálogo.
En Connection details de tu SQL warehouse, copia el nombre de host del servidor y la ruta HTTP. También sirve un clúster de uso general.
Pega un token de acceso personal o el token de una entidad de servicio, e indica un catálogo y un esquema si quieres otros distintos de los predeterminados.
Conserva todas las tablas o elige algunas, define una columna cursor para las sincronizaciones incrementales y elige una programación. Nada se carga hasta que lo apruebas.
Cuando llegue la primera carga, pregunta por las tablas del lakehouse en el chat, o crea con ellas dashboards e informes programados.
Preguntas frecuentes sobre Databricks
Dile al Connector Agent que quieres Databricks, o elige su tarjeta en el catálogo. Introduce el nombre de host del servidor y la ruta HTTP de Connection details de tu SQL warehouse, y luego pega un token de acceso en el formulario seguro. Si quieres, indica un catálogo y un esquema. Después elige las tablas, define cada cuánto se actualizan y aprueba la primera carga.
Las tablas y vistas del esquema que elijas, todas o una lista que tú seleccionas, con sus columnas y tipos. Funciona con Unity Catalog o con Hive metastore, a través de un SQL warehouse o un clúster de uso general. Querri solo puede leer lo que puede leer el usuario o la entidad de servicio del token.
Una relectura completa del esquema puede programarse a diario, cada semana o cada mes. Las sincronizaciones incrementales, basadas en una columna cursor como updated_at, se ejecutan cada hora, a diario o cada semana y traen solo las filas posteriores al último valor. Antes de una reunión importante, lanza una a mano. Las filas eliminadas en Databricks siguen en Querri hasta la siguiente actualización completa.
No. Querri solo lee tus tablas de Databricks y nunca modifica un registro en ellas. Ejecuta consultas de esquema y consultas SELECT y nunca crea, actualiza ni elimina una tabla o una fila. Esas consultas sí se ejecutan en tu warehouse o clúster, así que una sincronización usa su cómputo.
Querri solo puede sincronizar lo que tiene concedido el usuario o la entidad de servicio del token, así que la configuración más limpia es una entidad de servicio con acceso de lectura solo al esquema que quieres. Después de la sincronización, los permisos de Unity Catalog ya no se aplican persona por persona: lo que ve cada uno lo deciden la configuración de uso compartido de Querri y un filtro de filas por persona.
No. Las preguntas se responden desde una copia que Querri guarda de las tablas que elegiste, actualizada según tu programación, así que hacer una pregunta nunca despierta un SQL warehouse ni impide que se detenga. Solo las sincronizaciones consultan Databricks. Una respuesta refleja los datos tal como estaban en la última sincronización.
Conecta también NetSuite, y los dos llegan a la misma Biblioteca. Querri puede relacionar el uso, los pedidos o los envíos del lakehouse con las facturas, las órdenes de venta y los pagos de NetSuite mediante un número de pedido o un cliente en común, y te dice cómo los relacionó. Define una sola vez qué uso es facturable o cuándo un pedido cuenta como enviado, y cada respuesta lo respeta.
Conecta Salesforce junto a Databricks. Querri relaciona las cuentas entre ambos, idealmente por un ID guardado en los dos, para que puedas poner la actividad de producto o de pedidos junto al pipeline, las renovaciones y los casos abiertos. Si una coincidencia se basa en un nombre y no en un ID, la respuesta lo señala.
Convierte el análisis en un proyecto y asígnale una programación semanal. El lunes por la mañana se vuelve a ejecutar sobre la copia más reciente de tus tablas del lakehouse y le envía a cada gerente un libro con formato que contiene solo su región, o uno por cliente. El paso de descargar y pegar desaparece.
Sincroniza la tabla Delta en la que tu modelo escribe su forecast, además de la tabla de pedidos o de ventas. Define una sola vez el error del forecast como un KPI, desglosado por región o por producto. Querri guarda su historial desde el día en que empiezas, y el Análisis nocturno señala una región cuyo error se desvía.
Sí. Pide el dashboard con palabras sencillas, o parte de una captura de uno que tu equipo ya usa, y cámbialo preguntando. Un mismo dashboard puede combinar tablas del lakehouse con datos del ERP, del CRM o de hojas de cálculo, limitar a cada persona a sus propias filas e integrarse en tu propia app.
Sí. Tras una configuración única en Claude o ChatGPT, las preguntas sobre las tablas del lakehouse se responden desde tu Biblioteca de Querri, siguen tus definiciones y reglas, y se mantienen dentro de lo que esa persona puede ver en Querri, así que el asistente y tus dashboards coinciden.
No. El conector necesita un token de acceso, ya sea un token de acceso personal o uno que pertenezca a una entidad de servicio. OAuth recurriría a un inicio de sesión en el navegador que no puede completarse en un servidor durante las sincronizaciones programadas. El token de una entidad de servicio mantiene la conexión independiente de cualquier empleado.
Una conexión abarca un solo catálogo y esquema. No se admiten consultas SQL personalizadas, así que selecciona tablas o vistas. No hay OAuth ni escritura de vuelta, y las sincronizaciones incrementales no detectan las eliminaciones hasta la siguiente actualización completa. Varios catálogos o esquemas simplemente significan varias conexiones.
Sí, mediante el túnel VPN opcional de la configuración avanzada de la conexión. Sin él, Querri rechaza las direcciones privadas y se conecta solo por HTTPS en el puerto 443. Si un warehouse está detenido o el host es incorrecto, la conexión desiste en un par de minutos en lugar de quedarse colgada.
Sí. Las filas llegan en bloques de 50,000 a archivos Parquet tipados, en lugar de una sola extracción gigante, y el progreso se muestra a medida que llegan. En tablas que crecen cada día, una columna cursor permite que cada ejecución lea solo las filas posteriores a la última. También puedes limitar las filas por tabla.
No. Una vez sincronizadas las tablas, cualquiera con acceso pregunta en lenguaje natural. Querri muestra los pasos detrás de cada respuesta, para que alguien del equipo de datos pueda revisar la lógica, y una buena respuesta se puede guardar como un proyecto que se vuelve a ejecutar con datos frescos.
Querri cuenta con las certificaciones SOC 2 Type II, HIPAA e ISO 27001:2022, y tus datos nunca se usan para entrenar un modelo. Tu token de acceso se cifra en reposo, se elimina de los mensajes de error y nunca se le muestra al Connector Agent, y la conexión usa solo HTTPS.
Sigue explorando
Conéctalo con un nombre de host, una ruta HTTP y un token. Querri solo lee el lakehouse y nunca escribe en él.