Aller au contenu

Databricks + Querri

Des réponses Databricks,sans notebook ni ligne de SQL.

Le lakehouse contient ce que les opérations, la finance et les ventes veulent savoir. Querri place les tables que vous choisissez dans une seule Bibliothèque avec le reste de votre entreprise, interrogées en direct dans Databricks ou synchronisées sous forme de copie : chacun peut les interroger en langage naturel et obtenir des réponses fondées sur les définitions de votre équipe.

Querri ne fait que lire Databricks, avec des identifiants stockés chiffrés et hors de vue de l'agent. Certifié SOC 2 Type II, HIPAA et ISO 27001:2022.

Pourquoi le reporting Databricks se bloque

Le lakehouse est construit. Les métiers n'y ont toujours pas accès.

Les data engineers passent à Databricks parce qu'il gère le gros du travail sur les pipelines. Les frictions apparaissent plus tard, quand quelqu'un hors de l'équipe data a une question sur ce qu'il contient.

01

Les notebooks et le SQL sont la porte d'entrée

Un responsable régional n'ouvrira ni un notebook ni l'éditeur SQL. Chaque question devient une demande à l'équipe data, et la file grossit plus vite que l'équipe.

02

Les définitions se cachent dans le code

Le chiffre d'affaires net est une instruction CASE dans un notebook, un modèle dbt dans un autre et un filtre légèrement différent dans la requête d'un tableau de bord. Personne en dehors de l'ingénierie ne peut voir laquelle est la bonne.

03

Quelques questions suffisent à garder le calcul allumé

Par défaut, les entrepôts SQL classiques et pro attendent 45 minutes d'inactivité avant de s'arrêter, les serverless 10. Un filet de questions ponctuelles au fil de la journée suffit à faire tourner la facturation d'un entrepôt.

04

Les gros résultats finissent en export.csv

Une table de notebook affiche au plus 10 000 lignes ou 2 Mo, selon la limite atteinte en premier. Tout ce qui dépasse est téléchargé, collé dans Excel et envoyé par e-mail, et les copies divergent.

05

La gouvernance s'arrête au téléchargement

Unity Catalog décide qui lit quelle table dans Databricks. Dès qu'un CSV quitte le workspace, ces droits ne le suivent plus, et chaque destinataire voit toutes les lignes.

Live ou synchronisé

Laissez les données dans le lakehouse. Interrogez-les quand même.

Chaque table peut être Live ou synchronisée, et vous choisissez table par table. Une table Live ne quitte jamais Databricks : Querri n'en garde que les colonnes et une estimation du nombre de lignes, chaque question s'exécute sur votre SQL warehouse avec les données telles qu'elles sont à cet instant, et seul le petit résultat revient.

Live

Interrogée là où elle est

Querri écrit chaque question en Databricks SQL et l'exécute sur votre SQL warehouse. Rien n'est copié, pas même lors des actualisations planifiées. Cliquez sur un chiffre de la réponse : il indique la table, la connexion et un badge Live.

Idéal pour

  • Les très grandes tables
  • Les données qui doivent rester dans le lakehouse
  • Des réponses toujours à jour
  • Les équipes qui paient déjà le calcul de l'entrepôt

Synchronisée

Copiée selon votre planning

Le choix par défaut. Querri copie la table dans son propre stockage et répond à partir de cette copie : les questions ne démarrent donc pas de SQL warehouse.

Idéal pour

  • Les petites et moyennes tables
  • L'exploration intensive, sans coût d'entrepôt par question
  • Les jointures avec de nombreuses autres sources
  • Les entrepôts lents à se réveiller

Lecture seule, appliquée

Querri n'envoie jamais qu'un seul SELECT sur les tables que vous avez choisies. Les écritures, les instructions multiples, les autres tables, les lectures de fichiers et les paramètres de session sont refusés avant que quoi que ce soit n'atteigne Databricks.

Les règles de lignes dans la requête

Les filtres de lignes de chaque personne dans Querri sont appliqués à l'intérieur de la requête Databricks : les lignes qu'elle ne peut pas voir sont filtrées avant que quoi que ce soit ne quitte le lakehouse.

Traçable et borné

Chaque requête Live porte une étiquette de requête que vous retrouvez dans l'historique des requêtes de Databricks. Les résultats s'arrêtent à 100 000 lignes par défaut, et un résultat tronqué par cette limite est signalé.

Votre calcul, utilisé avec soin

Les requêtes Live s'exécutent sur votre SQL warehouse et consomment donc sa capacité de calcul. Avant une actualisation planifiée, Querri consulte les métadonnées de la table, ce qui ne démarre pas l'entrepôt, et n'exécute rien si la table n'a pas changé.

Les tables Live sont disponibles avec l'offre Scale. Voir l'offre Scale

Ce à quoi vous pouvez enfin répondre

Huit questions Databricks qui échappent à la file de l'équipe data

Chacune est une demande qui arrive chaque mois à une équipe lakehouse, avec ce qui la rend si longue aujourd'hui et ce qu'en fait Querri.

Comment les opérations et la finance peuvent-elles obtenir des réponses Databricks sans notebook ?

Pourquoi c'est difficile

Les tables sont propres et documentées, mais les seules façons de les lire sont un notebook, l'éditeur SQL ou un tableau de bord écrit par quelqu'un d'autre.

Avec Querri

Choisissez les tables gold que Querri doit utiliser, en direct dans Databricks ou synchronisées, et chacun pose ses questions dans le chat avec ses propres mots. Chaque réponse détaille ses étapes, et une réponse utile peut être enregistrée comme projet que tout le monde peut relancer.

Chaque client a-t-il été facturé pour l'usage que nous avons mesuré le mois dernier ?

Pourquoi c'est difficile

L'usage mesuré arrive dans le lakehouse alors que les factures sont émises dans l'ERP. Comparer les deux suppose un pipeline que personne n'a encore construit, ou un tableur de fin de mois.

Avec Querri

Connectez NetSuite à côté de Databricks, et Querri rapproche l'usage mesuré de chaque client de ses factures d'usage. Indiquez une fois dans Faits et règles quels événements sont facturables, et la liste des clients non facturés en tient compte.

Le chiffre d'affaires net de nos tables gold peut-il atteindre ceux qui ne se connectent jamais à Databricks ?

Pourquoi c'est difficile

La définition convenue se trouve dans le code de transformation. Un responsable commercial qui reconstruit le chiffre dans un tableur s'en approche, et c'est comme ça que deux chiffres se retrouvent dans la même réunion.

Avec Querri

Écrivez la définition en mots simples dans la Bibliothèque et suivez-la comme un KPI. Le chat, les tableaux de bord et les rapports planifiés lisent tous le même sens, et le KPI garde son historique dès le premier jour.

La prévision de la demande construite par nos data scientists tient-elle face au réel ?

Pourquoi c'est difficile

Le modèle écrit sa prévision dans une table Delta et passe à autre chose. La confronter aux vraies commandes, semaine par semaine et région par région, n'est le travail de personne.

Avec Querri

Connectez la table de prévisions et la table des commandes, en direct ou synchronisées, et suivez l'erreur de prévision comme un KPI. Chaque nuit, les Analyses nocturnes comparent chaque région à son propre historique et déposent celle qui dérive dans votre Boîte de réception.

Comment exporter automatiquement des données Databricks vers Excel chaque lundi ?

Pourquoi c'est difficile

Quelqu'un exécute la requête, télécharge le résultat, met en forme la feuille et la découpe par région à la main. La semaine où il est en congé, personne ne la reçoit.

Avec Querri

Enregistrez la ventilation par région comme projet, avec une exécution le lundi à 7 h. Rapports et automatisation la relance sur des données à jour et envoie par e-mail à chaque responsable un classeur mis en forme pour sa propre région, construit avec les Outils Excel.

Les clients qui contactent souvent le support commandent-ils moins ensuite ?

Pourquoi c'est difficile

Les commandes sont dans le lakehouse et les conversations dans l'outil de support. Personne ne relie les deux, donc le coût d'un mauvais mois au support n'apparaît jamais dans le chiffre d'affaires.

Avec Querri

Connectez Intercom à côté de Databricks et posez la question. Querri rapproche les clients entre les deux et explique comment il les a rapprochés. Le playbook sur le volume de tickets montre comment repérer les contacts qui reviennent sans cesse.

Pouvons-nous donner à nos clients un tableau de bord sur les données du lakehouse, sans accès à Databricks ?

Pourquoi c'est difficile

Ouvrir le workspace à des personnes extérieures passe par une revue de sécurité, et un outil BI séparé pour le reporting client, c'est un contrat de plus et une copie de plus du modèle de données.

Avec Querri

Construisez le tableau de bord en demandant, puis intégrez-le dans votre propre portail avec un filtre de lignes par client. Avec la marque blanche, il porte votre marque, pas la nôtre.

Puis-je interroger Claude ou ChatGPT sur nos tables Databricks ?

Pourquoi c'est difficile

Un assistant qui ne reçoit que des noms de tables bruts devine quelle colonne correspond au chiffre d'affaires et sur quelle date filtrer. La réponse se lit bien, qu'elle soit juste ou non.

Avec Querri

Connectez Querri à Claude ou ChatGPT, et les questions sur les données du lakehouse reçoivent une réponse tirée de votre Bibliothèque, selon les droits d'accès de chaque personne dans Querri. Quand une question peut se lire de deux façons, il nomme la lecture qu'il a retenue.

Databricks et le reste

Le lakehouse ne contient pas encore tous les systèmes

L'ingénierie fait d'abord arriver dans Databricks les données à fort volume. L'ERP, le CRM, l'outil de support et la feuille de budget attendent souvent leur tour. Querri les réunit dans une seule Bibliothèque à côté de vos tables lakehouse, pour qu'une question qui traverse plusieurs systèmes n'exige pas un nouveau job d'ingestion.

Databricks se combine bien avec

Des réponses que vous pouvez défendre

« En retard » a deux sens honnêtes, et la réponse nomme celui qu'elle a compté

« Combien de commandes étaient en retard en septembre ? » peut compter les commandes parties de l'entrepôt après la date promise ou celles arrivées chez le client après cette date. Les deux se défendent, et les opérations comme le service client ont chacun leur préférée. Querri répond avec une lecture, la nomme et montre l'autre total : le débat porte sur la façon de réduire les retards, pas sur la requête. Voir comment une réponse est vérifiée avant que vous la voyiez.

Découvrez au réveil ce qui a changé

Pendant la nuit, Querri lit les chiffres du lakehouse pour vous

Chaque nuit, Querri compare vos KPI à leur propre passé par un simple calcul et cherche le changement sur lequel personne n'a posé de question. Ce qu'il trouve vous attend le matin dans votre Boîte de réception, et rien ne change avant votre approbation.

Tableaux de bord Databricks personnalisés

Des tableaux de bord Databricks sans une seule requête à écrire

Demandez la mise en page en une phrase, ou fournissez une capture du rapport que la finance ouvre chaque lundi. Les modifications fonctionnent de la même façon : une demande en mots simples. Les graphiques lisent la même Bibliothèque que le chat, et chaque lecteur peut être limité à ses propres lignes.

  • Demandé en mots, ajusté en mots
  • Les tables du lakehouse à côté des données ERP, CRM et tableurs
  • Filtres de lignes par personne, définis une fois dans Querri
Une seule demande tapée a changé le style de tout le tableau de bord, et un clic suffirait à revenir en arrière.

Des demandes que vous n'exécutez plus à la main

Six rapports Databricks qui se reconstruisent tout seuls

Ce qui est synchronisé

Tables synchronisées : le schéma que vous désignez, copié selon votre planning

Les tables synchronisées, le choix par défaut, sont copiées dans le stockage de Querri, et les questions qui les concernent reçoivent une réponse tirée de cette copie, sans toucher à Databricks. En Live ou synchronisé, Querri ne peut lire que ce que le principal de service ou l'utilisateur du jeton a le droit de lire.

Ce que vous pouvez synchroniser

  • Tables
  • Vues
  • Toutes les tables du schéma
  • Une sélection de tables
  • Unity Catalog ou metastore Hive
  • Entrepôts SQL Databricks
  • Une connexion couvre un seul catalogue et un seul schéma ; INFORMATION_SCHEMA est exclu.

Actualisation complète, ou Live

Chaque synchronisation relit en entier les tables que vous avez choisies, chaque jour, chaque semaine ou chaque mois, si bien que les lignes modifiées ou supprimées dans Databricks arrivent toujours. Pour une table trop volumineuse pour être copiée aussi souvent, passez-la en Live et chaque question la lit là où elle se trouve.

Transmis par blocs

Les lignes arrivent par 50 000 sous forme de fichiers Parquet typés et deviennent un dataset Querri dans un stockage basé sur Iceberg. Un plafond de lignes par table est disponible si vous en voulez un.

Lecture seule

Querri exécute des lectures de schéma et des requêtes SELECT, rien d'autre. Il n'écrit jamais dans une table et ne modifie jamais un enregistrement. Les synchronisations s'exécutent sur votre entrepôt SQL, et consomment donc sa capacité de calcul.

Identifiants stockés chiffrés

OAuth avec un principal de service, ou un jeton d'accès personnel, chiffré au repos et retiré des messages d'erreur. Le Connector Agent sait qu'un identifiant existe, sans jamais voir l'identifiant lui-même.

Comment connecter Databricks

Trois valeurs tirées de votre workspace, puis l'agent prend le relais

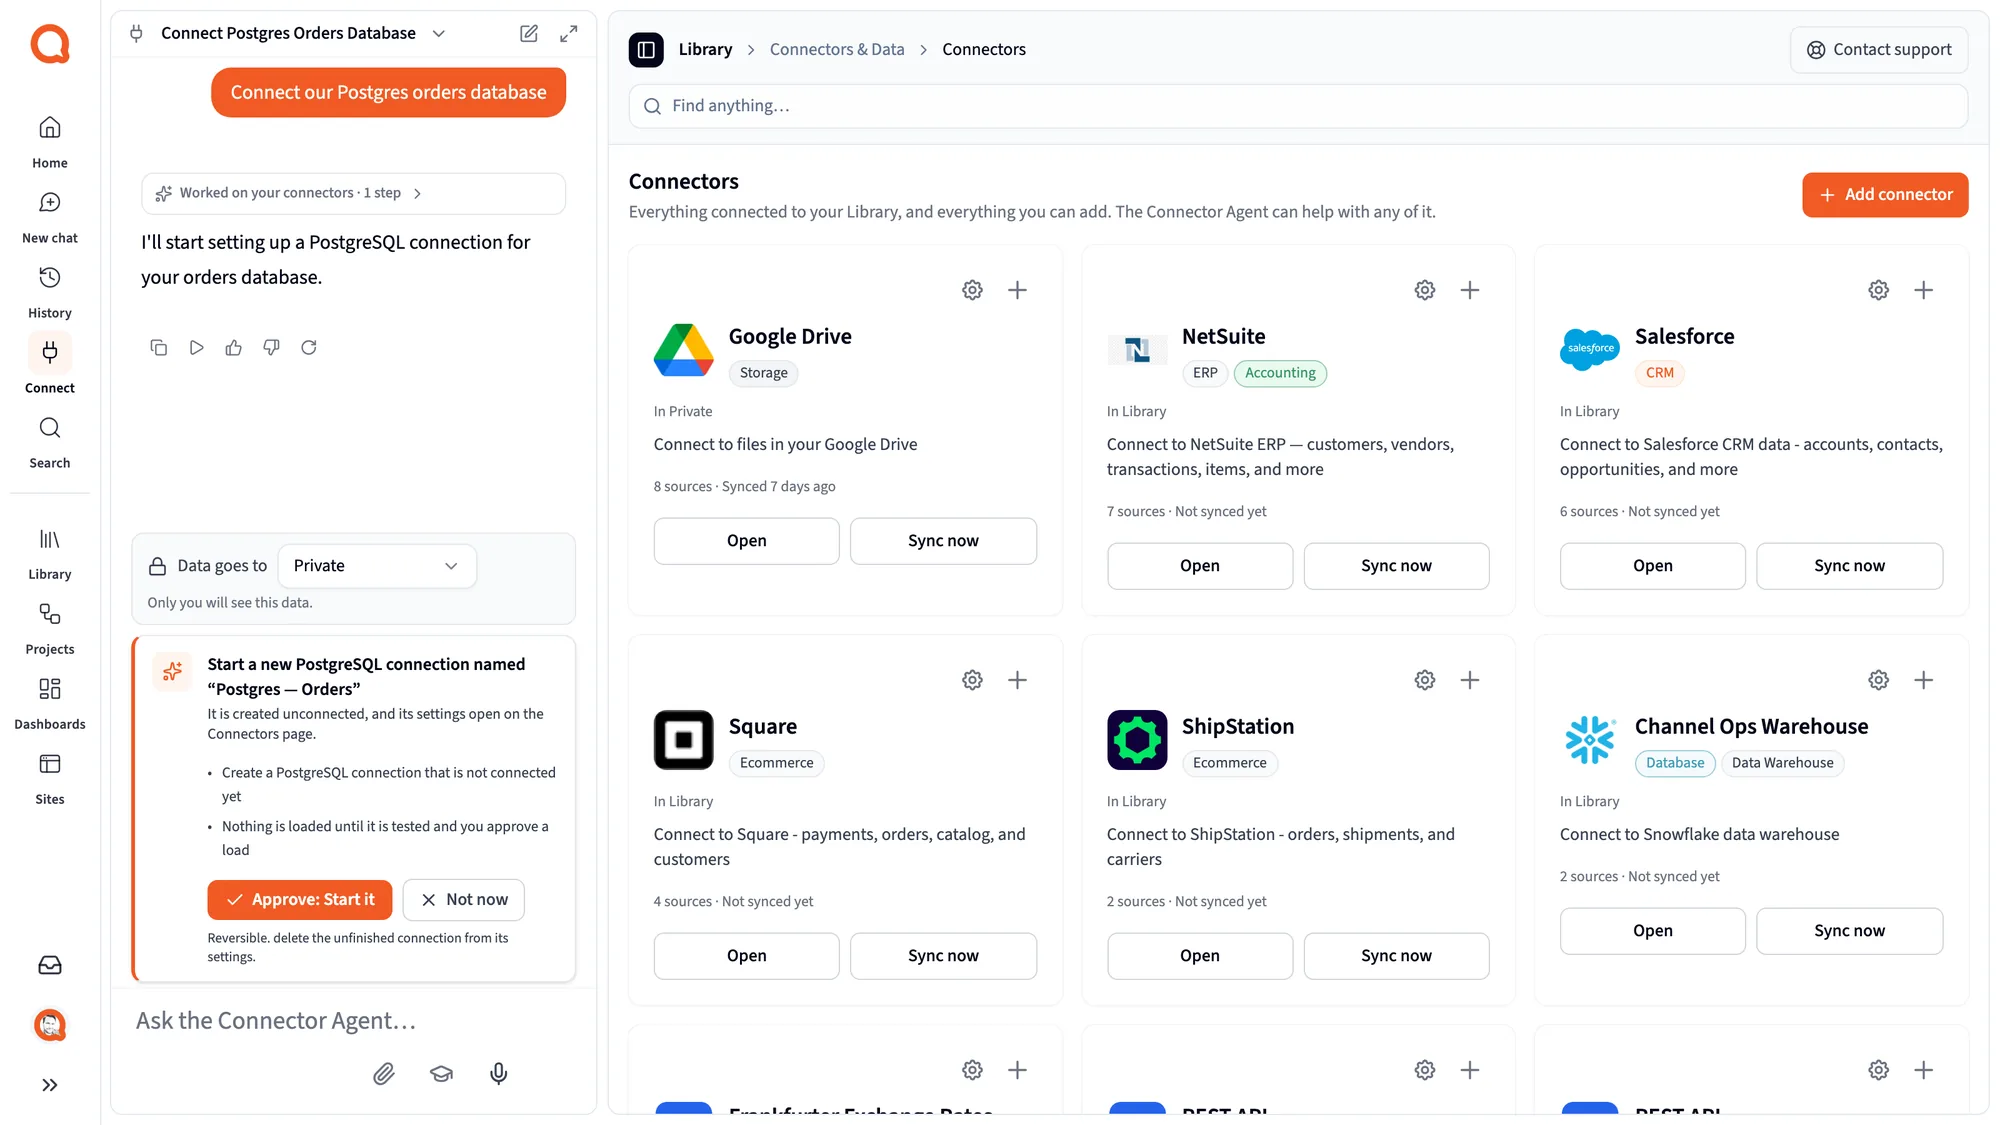
  1. 1

    Demandez au Connector Agent

    Dans Connect, tapez « ajoute notre workspace Databricks », ou cliquez sur la carte Databricks dans le catalogue.

  2. 2

    Copiez les informations de connexion

    Dans les Connection details de votre entrepôt SQL, copiez le nom d'hôte du serveur et le chemin HTTP.

  3. 3

    Ajoutez vos identifiants dans le formulaire sécurisé

    Saisissez l'ID client et le secret OAuth d'un principal de service, ou un jeton d'accès personnel, et indiquez un catalogue et un schéma si vous en voulez d'autres que ceux par défaut.

  4. 4

    Choisissez les tables et approuvez

    Gardez toutes les tables ou choisissez-en quelques-unes, et choisissez un planning. Pour garder une table dans Databricks, passez-la en Live. Rien ne se charge sans votre approbation.

  5. 5

    Posez votre première question

    Les tables Live sont prêtes dès que Querri a lu leurs colonnes, les tables synchronisées dès la fin du premier chargement. Interrogez ensuite les tables du lakehouse dans le chat, ou construisez-en des tableaux de bord et des rapports planifiés.

Les cartes de connecteurs Google Drive, NetSuite, Salesforce, Square, ShipStation et Snowflake sur la page Connect de Querri, avec le Connector Agent qui met une nouvelle connexion en attente d'approbation
L'agent met chaque nouvelle connexion et chaque premier chargement en attente de votre Approve.

FAQ Databricks

Questions sur Databricks et Querri

Comment connecter Databricks à Querri ?

Dites au Connector Agent que vous voulez Databricks, ou choisissez sa carte dans le catalogue. Saisissez le nom d'hôte du serveur et le chemin HTTP indiqués dans les Connection details de votre entrepôt SQL, puis les identifiants OAuth d'un principal de service ou un jeton d'accès personnel dans le formulaire sécurisé. Indiquez si besoin un catalogue et un schéma. Choisissez ensuite les tables, celles qui restent en Live et la fréquence d'actualisation des autres, puis approuvez.

Quelles données Databricks Querri synchronise-t-il ?

Les tables et les vues du schéma que vous choisissez, toutes ou seulement une liste que vous sélectionnez, avec leurs colonnes et leurs types. Cela fonctionne avec Unity Catalog ou le metastore Hive, via un entrepôt SQL. Querri ne peut lire que ce que l'utilisateur ou le principal de service du jeton peut lire.

À quelle fréquence les données Databricks sont-elles synchronisées ?

Les tables synchronisées sont relues en entier chaque jour, chaque semaine ou chaque mois, si bien que les lignes modifiées ou supprimées dans Databricks apparaissent après la prochaine exécution. Avant une réunion importante, lancez-en une à la main. Les tables Live sont toujours à jour : chaque question lit Databricks tel qu'il est au moment de son exécution.

Querri écrit-il dans Databricks ou modifie-t-il mes données ?

Non. Querri ne fait que lire vos tables Databricks et n'y modifie jamais un enregistrement. Il exécute des lectures de schéma et des requêtes SELECT, et ne crée, ne met à jour ni ne supprime jamais une table ou une ligne ; les requêtes Live sont vérifiées avant leur envoi, si bien que seul un SELECT unique sur les tables que vous avez choisies atteint Databricks. Ces requêtes s'exécutent bien sur votre entrepôt : les synchronisations et les questions Live consomment donc sa capacité de calcul.

Comment les autorisations Unity Catalog se répercutent-elles dans Querri ?

Querri ne peut lire que ce qui est accordé au principal de service ou à l'utilisateur du jeton : un principal de service avec un accès en lecture au seul schéma voulu est donc la configuration la plus propre. Dans Querri, les droits Unity Catalog ne s'appliquent pas personne par personne : ce sont les paramètres de partage de Querri et un filtre de lignes par personne qui décident de ce que chacun voit, et pour les tables Live, ce filtre est appliqué à l'intérieur de la requête Databricks.

Querri interroge-t-il Databricks en direct chaque fois que quelqu'un pose une question ?

C'est possible, table par table. Une table Live reste dans Databricks : chaque question qui en a besoin s'exécute sur votre SQL warehouse sous forme de requête écrite en Databricks SQL, et seul le résultat revient. Ces requêtes consomment la capacité de calcul de l'entrepôt, et un entrepôt arrêté ajoute quelques secondes à la première question. Les tables synchronisées reçoivent une réponse tirée de la copie de Querri : ces questions ne réveillent donc jamais un entrepôt SQL et reflètent la dernière synchronisation. Les tables Live sont disponibles avec l'offre Scale.

Une table Databricks doit-elle être Live ou synchronisée ?

Passez-la en Live quand la table est très grande, quand les données doivent rester dans le lakehouse, ou quand chaque réponse doit refléter Databricks tel qu'il est à cet instant. Gardez-la synchronisée quand la table est petite ou moyenne, quand elle est beaucoup explorée et que vous préférez ne pas payer le calcul de l'entrepôt à chaque question, ou quand l'entrepôt est lent à démarrer. Vous pouvez repasser une table Live en synchronisée à tout moment ; elle se charge à la prochaine synchronisation complète.

Puis-je combiner une table Databricks Live avec d'autres données ?

Oui. Les questions qui portent sur plusieurs tables Live d'une même connexion s'exécutent en une seule requête Databricks. Quand une question a aussi besoin d'une table synchronisée ou d'un fichier importé, Querri résume d'abord la table Live dans Databricks, puis combine ce petit résultat avec les autres données dans Querri. Tout se fait automatiquement, et un clic sur un chiffre montre de quelle table il provient, avec un badge Live.

Comment combiner les données Databricks et NetSuite ?

Connectez aussi NetSuite, et les deux arrivent dans la même Bibliothèque. Querri peut rapprocher l'usage, les commandes ou les expéditions du lakehouse des factures, commandes clients et paiements NetSuite par un numéro de commande ou un client commun, et il vous dit comment il a fait le rapprochement. Définissez une fois quel usage est facturable ou quand une commande compte comme expédiée, et chaque réponse suit cette définition.

Comment combiner les données Databricks et Salesforce ?

Connectez Salesforce à côté de Databricks. Querri rapproche les comptes entre les deux, idéalement par un ID présent dans les deux systèmes : vous pouvez ainsi mettre l'activité produit ou les commandes à côté du pipeline, des renouvellements et des tickets ouverts. Si un rapprochement repose sur un nom plutôt que sur un ID, la réponse le signale.

Comment obtenir un rapport Excel hebdomadaire depuis Databricks sans export manuel ?

Transformez l'analyse en projet et associez-lui un planning hebdomadaire. Le lundi matin, il se relance sur les données à jour du lakehouse et envoie à chaque responsable un classeur mis en forme qui ne contient que sa région, ou un classeur par client. L'étape télécharger-coller disparaît.

Comment obtenir un rapport prévisions vs réel depuis Databricks ?

Connectez la table Delta dans laquelle votre modèle écrit sa prévision, plus la table des commandes ou des ventes, en direct ou synchronisées. Définissez une fois l'erreur de prévision comme un KPI, ventilé par région ou par produit. Querri en garde l'historique dès le premier jour, et les Analyses nocturnes signalent une région dont l'erreur dérive.

Puis-je créer des tableaux de bord Databricks personnalisés sans outil BI ?

Oui. Demandez le tableau de bord en mots simples, ou partez d'une capture de celui que votre équipe utilise déjà, et modifiez-le en demandant. Un même tableau de bord peut mêler des tables du lakehouse à des données ERP, CRM ou tableurs, limiter chaque lecteur à ses propres lignes et être intégré dans votre propre application.

Puis-je interroger ChatGPT ou Claude sur mes données Databricks ?

Oui. Après une configuration unique dans Claude ou ChatGPT, les questions sur les tables du lakehouse s'appuient sur votre Bibliothèque Querri, suivent vos définitions et vos règles et restent dans les limites de ce que la personne peut voir dans Querri : l'assistant et vos tableaux de bord sont d'accord.

Puis-je connecter Databricks avec OAuth plutôt qu'avec un jeton ?

Oui. OAuth avec un principal de service (machine à machine) est la configuration recommandée : saisissez son ID client et son secret, et ses jetons de courte durée n'ont pas besoin de rotation. Un jeton d'accès personnel fonctionne aussi. Dans les deux cas, la connexion ne dépend de la connexion d'aucun employé.

Quelles sont les limites du connecteur Databricks ?

Une connexion couvre un seul catalogue et un seul schéma. Les requêtes SQL personnalisées ne sont pas prises en charge : sélectionnez plutôt des tables ou des vues. Pas d'écriture en retour. Par défaut, les résultats Live s'arrêtent à 100 000 lignes et les questions dans le chat expirent au bout de 2 minutes. Plusieurs catalogues ou schémas signifient simplement plusieurs connexions.

Querri peut-il accéder à un workspace Databricks sur un réseau privé ?

Pas encore. Querri se connecte à votre workspace en HTTPS sur le port 443, le workspace doit donc être joignable depuis Internet. Si un entrepôt est arrêté ou que l'hôte est erroné, la connexion abandonne en quelques minutes au lieu de rester bloquée.

Querri gère-t-il les grosses tables Databricks ?

Oui. Passez une grande table en Live et elle reste dans Databricks, où chaque question s'exécute, et seul le résultat revient. Les tables synchronisées arrivent par blocs de 50 000 lignes dans des fichiers Parquet typés, plutôt qu'en une seule extraction géante, et la progression s'affiche à mesure que les lignes arrivent. Vous pouvez aussi plafonner le nombre de lignes par table.

Faut-il connaître SQL ou Python pour utiliser les données Databricks dans Querri ?

Non. Une fois les tables connectées, toute personne qui y a accès pose ses questions en langage naturel. Querri montre les étapes derrière chaque réponse, pour qu'un membre de l'équipe data puisse vérifier la logique, et une bonne réponse peut être enregistrée comme projet qui se relance sur des données fraîches.

Mes données Databricks sont-elles en sécurité dans Querri ?

Querri est certifié SOC 2 Type II, HIPAA et ISO 27001:2022, et vos données ne servent jamais à entraîner un modèle. Vos identifiants sont chiffrés au repos, retirés des messages d'erreur et jamais montrés au Connector Agent, et la connexion se fait uniquement en HTTPS.
Ouvrez le lakehouse à ceux qui posent les questions.

Connectez-vous avec un nom d'hôte, un chemin HTTP et un principal de service ou un jeton, puis interrogez le lakehouse en direct ou synchronisez une copie. Querri ne fait que lire et n'y écrit jamais.